

Il crawl budget indica, in termini pratici, l’insieme degli URL di un sito che Google può e vuole scansionare. Non è un credito giornaliero fisso, non è un punteggio SEO e soprattutto non è un problema che ogni sito deve necessariamente ottimizzare.
Questa ultima distinzione conta molto. Se gestisci un normale sito aziendale, un blog con qualche centinaio di articoli o un progetto nel quale le nuove pagine vengono scansionate senza difficoltà, probabilmente il crawl budget non è la prima cosa di cui dovresti preoccuparti. Google stesso presenta la gestione del crawl budget come un tema avanzato rivolto soprattutto a siti molto grandi, molto dinamici o con evidenti problemi nella scansione di una parte consistente degli URL.
La situazione cambia con ecommerce dotati di migliaia di combinazioni di filtri, marketplace, portali editoriali enormi, siti che generano quantità incontrollate di URL parametrizzati o infrastrutture sulle quali Google incontra frequentemente errori e rallentamenti.
Il punto, quindi, non è “come ottenere più crawl budget” a ogni costo. È capire prima se hai davvero un problema di crawling, dove Google sta spendendo risorse e quali interventi hanno senso nel tuo caso.
| Scenario | Priorità del crawl budget |
|---|---|
| Sito aziendale con poche decine o centinaia di URL | Normalmente bassa |
| Blog con alcune centinaia di articoli e scansione regolare | Normalmente bassa |
| Ecommerce con migliaia di combinazioni di filtri | Da valutare |
| Sito con oltre 10.000 URL che cambiano quotidianamente | Potenzialmente alta |
| Portale con centinaia di migliaia o milioni di URL | Alta |
| Grande quantità di URL “Rilevata, ma attualmente non indicizzata” | Da diagnosticare |
| Molti URL duplicati, parametrici o generati senza controllo | Da diagnosticare |
Cos’è il crawl budget secondo Google
Google definisce il crawl budget attraverso due componenti: crawl capacity limit e crawl demand.
La prima determina quanto Google può scansionare senza mettere in difficoltà l’infrastruttura del sito. La seconda riguarda quanto i sistemi di Google vogliono tornare sugli URL conosciuti.
Solo combinando le due dimensioni ha senso parlare realmente di crawl budget.
Questo modello è più utile della vecchia idea del “numero di pagine disponibili ogni giorno”, perché spiega anche un fenomeno apparentemente contraddittorio: un server potrebbe essere perfettamente in grado di sostenere altre richieste e Google potrebbe comunque non effettuarle, semplicemente perché non esiste sufficiente domanda di scansione.
Crawl capacity limit: quanto Google può scansionare
Il crawl capacity limit rappresenta la capacità massima di scansione che i crawler possono utilizzare senza sovraccaricare il server.
Google considera sia il numero di connessioni sia il tempo durante il quale queste rimangono aperte. Se il sito risponde in modo stabile e i tempi di risposta restano buoni, la capacità può aumentare automaticamente. Se invece aumentano latenza, errori 5xx o risposte 429 Too Many Requests, Google riduce l’attività di crawling.
Qui c’è quindi una relazione reale fra infrastruttura e crawling, ma va interpretata correttamente.
Un server più veloce non garantisce automaticamente più crawling. Elimina piuttosto un possibile limite tecnico. Per utilizzare quella capacità deve comunque esistere una domanda di scansione.
È la stessa differenza che c’è fra avere un’autostrada capace di sostenere molto traffico e avere effettivamente automobili che devono percorrerla.
Crawl demand: quanto Google vuole scansionare
La crawl demand riguarda invece la necessità dei sistemi di Google di recuperare o aggiornare gli URL conosciuti.
Per Googlebot entrano in gioco, tra gli altri elementi:
- dimensione del sito;
- frequenza con cui cambiano i contenuti;
- qualità e pertinenza delle pagine;
- inventario URL conosciuto;
- popolarità degli URL;
- necessità di rilevare modifiche.
Uno degli aspetti sui quali hai più controllo è proprio l’inventario percepito. Se il sito genera moltissimi URL duplicati, rimossi o inutili da scansionare, Google può spendere parte della propria attività su risorse che non aggiungono contenuto nuovo.
Questo è molto diverso dal sostenere che “Google premia i siti che pubblicano spesso” o che basta cambiare continuamente i contenuti per ricevere più crawl budget.
La frequenza di aggiornamento ha senso quando riflette modifiche reali. Cambiare date, timestamp o parti irrilevanti di una pagina soltanto per provocare nuove scansioni non crea automaticamente valore.
Perché crawl budget non significa “quota fissa di pagine al giorno”
Il crawl budget non è un contatore del tipo:
10.000 URL disponibili oggi → 9.999 → 9.998 → ...
Google adegua dinamicamente capacità e domanda. La quantità di richieste può quindi cambiare nel tempo e differire notevolmente fra due siti.
C’è inoltre un’altra distinzione fondamentale: crawling non significa indicizzazione.
Una pagina può essere scansionata e successivamente non essere inserita nell’indice. Google descrive infatti crawling, indexing e serving come fasi differenti della Ricerca. Se vuoi approfondire il meccanismo generale, nella guida su come funziona Googlebot trovi la separazione completa fra discovery, crawling, rendering, indicizzazione e ranking.
Il crawl budget è davvero un problema per il tuo sito?
Prima di ottimizzare qualcosa, conviene capire se esiste realmente un collo di bottiglia.
Per molti siti la risposta è no.
Google arriva a dire esplicitamente che, se non hai un grande numero di pagine soggette a frequenti modifiche oppure le pagine vengono normalmente scansionate nello stesso giorno in cui vengono pubblicate, mantenere aggiornata la sitemap e controllare il report Indicizzazione delle pagine può essere sufficiente.
Questo ridimensiona parecchie checklist SEO che presentano il crawl budget come un’attività obbligatoria anche per un blog con 200 articoli.
Quando un sito piccolo o medio può ignorarlo
Immagina un sito aziendale composto da:
- home;
- pagine servizio;
- portfolio;
- contatti;
- una cinquantina di articoli.
Le pagine importanti sono linkate, la sitemap è coerente, il server risponde correttamente e Search Console mostra che Google visita regolarmente i contenuti.
In questa situazione passare ore a “recuperare crawl budget” probabilmente produce meno valore che lavorare su contenuti, intent, linking interno, conversioni o problemi tecnici realmente osservati.
La buona manutenzione tecnica resta utile. È il problema specifico del crawl budget a non essere necessariamente prioritario.
Quando diventa rilevante su siti grandi o molto dinamici
La situazione cambia quando l’inventario cresce rapidamente.
Google indica come riferimenti approssimativi:
- siti con oltre un milione di pagine univoche che cambiano con una certa frequenza;
- siti da oltre 10.000 pagine univoche che cambiano quotidianamente;
- siti con una quota rilevante di URL scoperti ma non ancora sottoposti a scansione.
Non sono soglie oltre le quali “si attiva” un algoritmo e sotto le quali il problema non può esistere. Google specifica che sono valori orientativi per capire il tipo di sito a cui è destinata la guida.
Un ecommerce da 8.000 prodotti potrebbe avere un problema enorme se la navigazione a faccette genera milioni di URL. Un sito con 30.000 pagine statiche e un’architettura semplice potrebbe invece non mostrare alcun collo di bottiglia significativo.
Conta l’inventario effettivamente generato e conosciuto da Google, non soltanto il numero di contenuti pubblicati nel CMS.
Il segnale “Rilevata, ma attualmente non indicizzata”
Nel report Indicizzazione delle pagine di Search Console puoi trovare URL nello stato “Rilevata, ma attualmente non indicizzata”.
Significa che Google conosce l’URL ma non lo ha ancora sottoposto a scansione. La documentazione Search Console spiega che, tipicamente, Google aveva intenzione di scansionarlo ma ha rinviato l’operazione, per esempio perché prevedeva un carico eccessivo sul sito.
Una grande quantità di URL in questo stato è infatti uno dei casi in cui Google suggerisce di approfondire il crawl budget.
Attenzione però a non trasformare una singola URL in una diagnosi globale.
Un contenuto appena pubblicato che rimane brevemente nello stato “Rilevata” non dimostra che il dominio abbia esaurito il crawl budget. Devi osservare dimensione del fenomeno, durata, tipologie di URL e comportamento complessivo del sito.
Cosa consuma realmente attività di crawling
Su siti che hanno un vero problema di crawl budget, il primo obiettivo non è convincere Google a lavorare di più. È capire quale inventario gli stai facendo conoscere.
Il problema più comune non è avere “troppe pagine” in assoluto. È produrre troppe URL che rappresentano la stessa informazione, stati temporanei o combinazioni che non meritano una scansione autonoma.
URL duplicati e inventario URL eccessivo
Una stessa risorsa può diventare raggiungibile attraverso molti indirizzi:
/scarpe/
/scarpe/?sort=price
/scarpe/?sort=name
/scarpe/?session=12345
/scarpe/?source=qualcosa
Il crawler vede URL distinti. Saranno poi altri sistemi a capire se rappresentano contenuti equivalenti.
Su piccola scala non è necessariamente un problema. Su un ecommerce con migliaia di categorie e molte combinazioni di parametri, però, l’inventario può crescere di ordini di grandezza rispetto alle pagine realmente utili.
Qui consolidare o impedire la generazione di URL inutili può essere molto più efficace che aumentare la capacità del server.
Filtri, faceted navigation e parametri
La navigazione a faccette è uno dei casi classici.
Un catalogo potrebbe permettere di combinare:
marca × colore × taglia × prezzo × disponibilità × ordinamento
Anche partendo da un numero gestibile di prodotti, le combinazioni possono produrre uno spazio URL enorme.
Google raccomanda di prestare particolare attenzione alle URL generate da ordinamenti, filtri, calendari, ricerche interne e altri sistemi in grado di creare spazi praticamente infiniti. La documentazione sulla struttura degli URL dedica infatti indicazioni specifiche alla gestione di queste configurazioni.
Il criterio non dovrebbe essere “bloccare tutti i filtri”.
Alcune combinazioni possono avere valore reale per utenti e ricerca. Altre rappresentano soltanto variazioni tecniche dello stesso inventario. La soluzione deve derivare dall’intento e dall’architettura del singolo ecommerce.
Soft 404, pagine rimosse e redirect chain
Una pagina rimossa dovrebbe comunicare chiaramente il proprio stato.
Se non esiste più e non ha un sostituto appropriato, una risposta 404 o 410 è normalmente corretta. Restituire invece un 200 OK con una pagina che comunica “prodotto non trovato” può generare un soft 404.
Google segnala espressamente i soft 404 come un possibile spreco di attività di crawling sui siti nei quali il crawl budget è rilevante. Lo stesso vale per le lunghe catene di redirect.
Questo non significa che un normale 404 occasionale sia una catastrofe SEO. I codici HTTP devono rappresentare lo stato reale della risorsa, non essere eliminati per avere un report “pulito”.
Errori 5xx, 429 e server lento
Gli errori server hanno un effetto differente.
Google tratta 5xx e 429 Too Many Requests come segnali di difficoltà del server e può ridurre temporaneamente la velocità di crawling. Quando il sito torna a rispondere regolarmente con codici 2xx, la frequenza può aumentare nuovamente in modo graduale.
Su un grande ecommerce questo può diventare un problema concreto.
Se le richieste Google coincidono sistematicamente con:
502 Bad Gateway;503 Service Unavailable;504 Gateway Timeout;429 Too Many Requests;- forti aumenti della latenza;
il collo di bottiglia potrebbe essere l’infrastruttura, non l’architettura degli URL.
Crawl budget e Googlebot: qual è la relazione
Il crawl budget descrive l’allocazione delle risorse di crawling; Googlebot è il crawler di Google Search che effettua materialmente le richieste.
Sono quindi concetti collegati, ma non sinonimi.
Come Googlebot decide cosa recuperare
Googlebot segue un processo algoritmico che decide quali siti e URL sottoporre a scansione, con quale frequenza e quante richieste effettuare.
Il comportamento deriva dalla combinazione fra capacità disponibile e domanda.
Non ha senso quindi pensare a Googlebot come a un visitatore umano che “si annoia”, “perde fiducia” o decide di premiare un sito perché trova un’architettura ordinata.
Queste metafore possono sembrare intuitive, ma rischiano di nascondere il meccanismo reale.
Perché più crawling non significa automaticamente più indicizzazione
Puoi aumentare enormemente il numero di URL scansionati senza ottenere un aumento equivalente delle pagine indicizzate.
Se Google incontra:
- duplicati;
- pagine alternate;
- contenuti non idonei all’indice;
- canonical differenti;
- pagine senza sufficiente valore autonomo;
il sistema può scansionarle e decidere comunque di non indicizzarle.
Per questo, quando analizzi il fenomeno, affianca sempre crawling e indicizzazione Google.
Più fetch non significa automaticamente più documenti nell’indice.
Perché più crawling non significa più ranking
Lo stesso vale per il ranking.
Il crawl budget non va trattato come un ranking factor diretto. Risolvere un problema che impediva a Google di raggiungere URL importanti può ovviamente rendere possibile la fase successiva del processo, ma non significa che quelle pagine saliranno automaticamente nei risultati.
Una pagina può essere:
scoperta → scansionata → indicizzata → poco competitiva
e il crawl budget può essere perfettamente sano.
Questa distinzione serve anche durante gli audit: se le pagine strategiche vengono regolarmente scansionate e indicizzate ma restano in posizione 40, continuare a lavorare sul crawl budget significa probabilmente diagnosticare il problema sbagliato.
Come capire se hai davvero un problema di crawl budget
La diagnosi dovrebbe partire dai dati, non da una checklist.
Io utilizzerei tre livelli:
Search Console → inventario reale → log server
Il primo offre una vista Google-side aggregata. Il secondo ti dice quali URL il sito produce e rende raggiungibili. Il terzo mostra le richieste realmente ricevute dal server.
Crawl Stats in Search Console
Il report Statistiche di scansione / Crawl Stats mostra la cronologia dell’attività di crawling di Google sul sito: numero di richieste, dimensione dei download, tempi di risposta, codici HTTP, tipi di file, finalità e user-agent.
È uno strumento diagnostico, non un tachimetro nel quale “più alto = migliore”. La documentazione del report Crawl Stats descrive proprio queste dimensioni.
Guarderei soprattutto:
| Segnale | Domanda da fare |
|---|---|
| Richieste totali | Il cambiamento è coerente con ciò che è successo sul sito? |
| Tempo medio di risposta | Il server sta diventando un limite? |
5xx / 429 | Google incontra problemi di capacità? |
| Tipo di risposta | Stiamo servendo troppi redirect o errori? |
| Tipo di file | Dove vengono spese le richieste? |
| Discovery / refresh | Google sta trovando nuovi URL o aggiornando soprattutto quelli noti? |
Un calo di richieste da solo non dimostra un problema. Se non hai pubblicato né modificato nulla, può semplicemente esistere meno domanda di scansione.
Page Indexing e “Rilevata, ma attualmente non indicizzata”
Il report Indicizzazione delle pagine ti consente di capire come Google classifica gli URL conosciuti.
Non devi cercare il 100% di indicizzazione. Redirect, duplicati e pagine volutamente escluse possono essere completamente normali.
Il dato interessante per il crawl budget è piuttosto la presenza sistemica di URL importanti conosciuti ma mai scansionati, soprattutto se il fenomeno coinvolge una parte consistente dell’inventario.
Per imparare a leggere insieme crawling, indexing e performance puoi usare la guida a Google Search Console, evitando di trasformare ogni stato “non indicizzato” in un errore.
Analisi dei log server
Search Console ti offre la vista aggregata di Google. I log ti mostrano invece ciò che è realmente arrivato al server.
Da un log puoi ricostruire:
timestamp → IP → user-agent → URL richiesta → status HTTP → bytes → tempo di risposta
Su un progetto abbastanza grande puoi quindi segmentare le richieste di Googlebot e chiederti:
- quali directory riceve più spesso;
- quali URL strategici non vengono quasi mai richiesti;
- quanta attività finisce su parametri;
- quanta su redirect;
- quanta su
404; - quali aree producono
5xx; - quanto frequentemente vengono ricontrollati i documenti importanti.
Questo è il punto in cui il concetto astratto di “spreco” diventa misurabile.
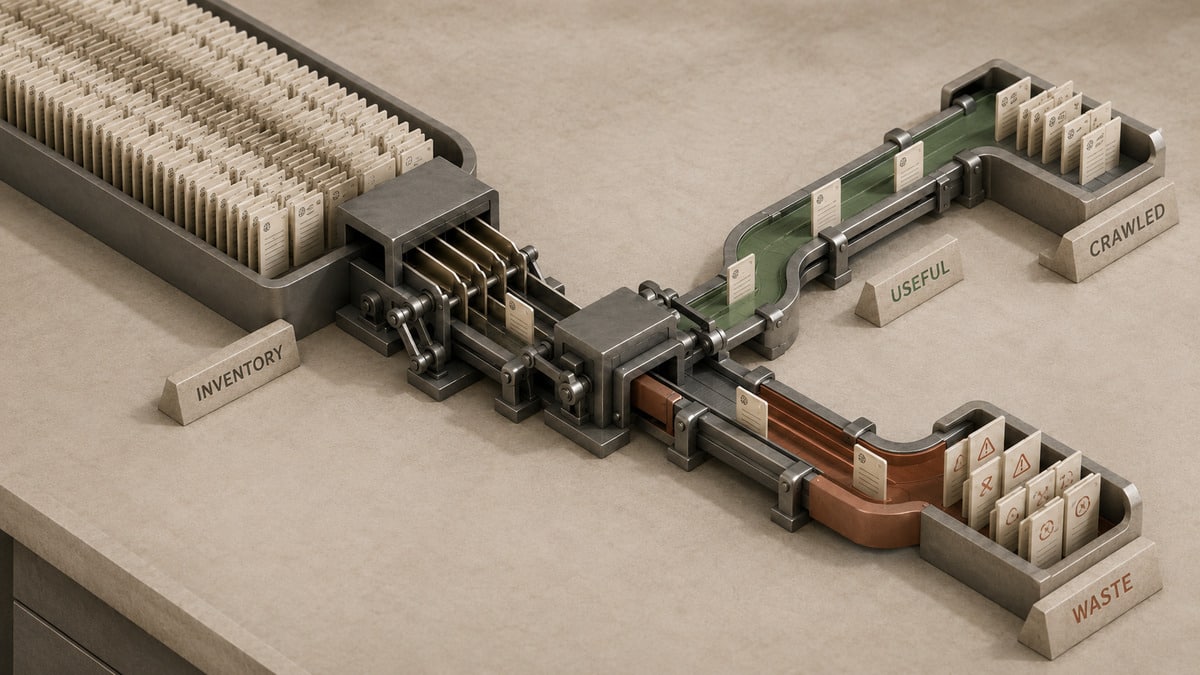
Come confrontare URL importanti e URL realmente scansionati
Un metodo semplice consiste nel creare due insiemi:
A — URL che vuoi rendere disponibili alla Ricerca
e
B — URL effettivamente richiesti da Googlebot nel periodo osservato
Poi confrontarli.
Se hai 50.000 prodotti canonici importanti ma la maggioranza delle richieste Googlebot finisce su milioni di combinazioni di filtri, hai un problema concreto da investigare.
Se invece hai 400 URL, Google visita regolarmente quelli importanti e non esistono spazi URL fuori controllo, probabilmente non hai bisogno di un progetto dedicato al crawl budget.
Come ottimizzare il crawl budget quando serve
Una volta verificato che il problema esiste, la priorità è ridurre il lavoro inutile e rimuovere i colli di bottiglia reali.
Non applicare indiscriminatamente tutte le tecniche. Un intervento corretto per un ecommerce con faceted navigation può essere pericoloso su un sito in cui quelle faccette rappresentano landing page organiche importanti.
Ridurre gli URL che non vuoi far scansionare
Parti dall’inventario.
Cerca soprattutto:
- URL generati da ricerche interne;
- combinazioni infinite di filtri;
- parametri di sessione;
- calendari senza fine;
- ordinamenti che non cambiano realmente il contenuto;
- duplicati tecnici;
- vecchi URL ancora linkati;
- pagine create automaticamente dal CMS senza funzione reale.
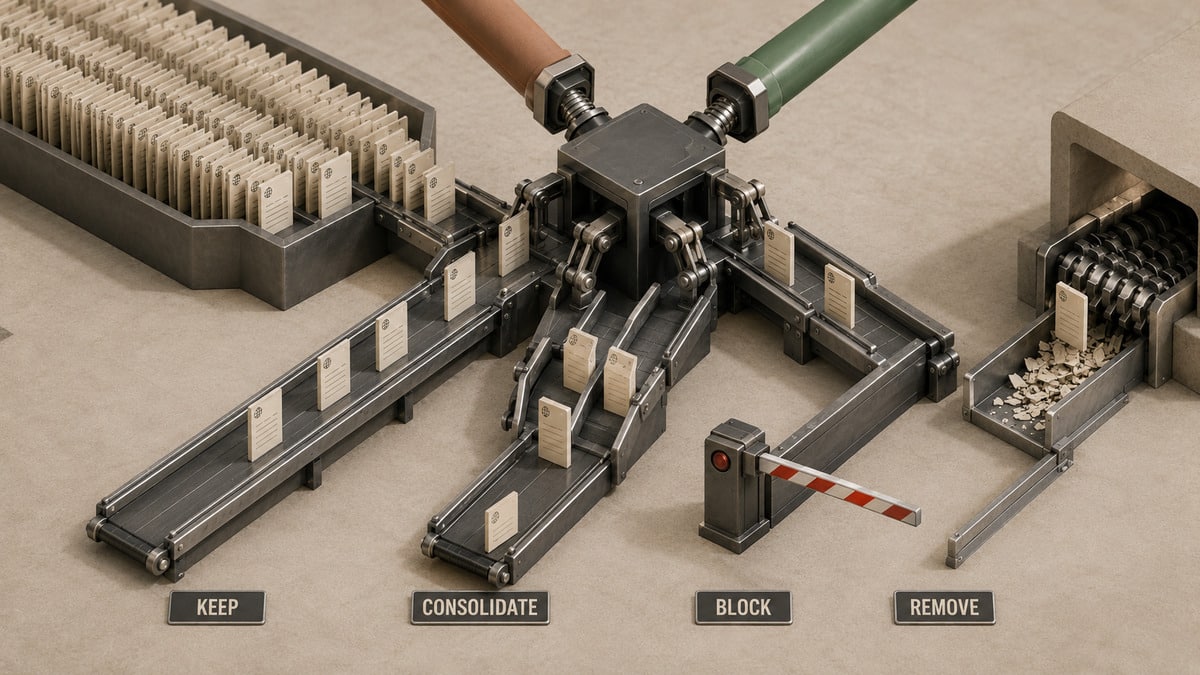
Per ogni classe decidi cosa deve accadere.
KEEP → CONSOLIDATE → BLOCK CRAWL → REMOVE → REDIRECT
Il criterio viene prima dello strumento.
Consolidare i duplicati
Quando più URL rappresentano sostanzialmente lo stesso contenuto, la soluzione migliore può essere eliminare alla fonte le varianti inutili oppure consolidarle.
rel="canonical" è uno dei segnali che puoi utilizzare per indicare una versione rappresentativa, ma non è un comando di blocco del crawling. Google deve poter scansionare le pagine per osservare e valutare i segnali di canonicalizzazione.
La documentazione sulla canonicalizzazione spiega infatti il processo come selezione della versione rappresentativa fra pagine duplicate.
Se il problema è impedire a Googlebot di richiedere un intero spazio URL inutile, canonical e robots.txt stanno risolvendo due problemi differenti.
Usare correttamente robots.txt
Il file robots.txt può impedire ai crawler conformi di richiedere URL o pattern che non vuoi vengano scansionati.
Può essere utile, per esempio, per spazi URL virtualmente infiniti generati da ordinamenti o ricerche interne, quando hai stabilito che quelle risorse non devono essere sottoposte a crawling.
Ma ci sono due limiti fondamentali.
Primo: robots.txt non è uno strumento per impedire con certezza che un URL compaia nell’indice. Un URL bloccato può essere conosciuto attraverso altri segnali. La documentazione Google lo chiarisce esplicitamente.
Secondo: non usare robots.txt come un rubinetto temporaneo per “spostare” crawl budget da una directory a un’altra.
Google specifica che la capacità apparentemente liberata non viene automaticamente trasferita ad altre pagine, a meno che il sito non stia già raggiungendo il proprio limite di capacità.
Rimuovere definitivamente gli URL con 404 o 410
Se un URL è stato rimosso definitivamente e non esiste una pagina sostitutiva pertinente, rispondi con uno status coerente: normalmente 404 Not Found o 410 Gone.
Non creare un redirect verso la home soltanto per evitare un 404.
Allo stesso modo, non bloccare automaticamente in robots.txt un vecchio URL già noto a Google se vuoi comunicare che non esiste più: il crawler deve poter ricevere la risposta corretta.
Evitare soft 404 e catene di redirect
Un soft 404 crea ambiguità: il server restituisce 200, ma la pagina comunica sostanzialmente che non esiste contenuto valido.
Le redirect chain aggiungono invece richieste intermedie inutili:
A → B → C → D
quando sarebbe possibile:
A → D
Nei link interni aggiorna quindi, quando possibile, direttamente il target finale.
Tenere pulite le sitemap
La sitemap dovrebbe rappresentare gli URL canonici che vuoi rendere disponibili alla Ricerca.
La documentazione Google sulle sitemap specifica che l’invio è un hint, non un ordine: non garantisce né crawling né indicizzazione.
Eviterei quindi sitemap piene di:
- redirect;
404;- URL duplicati;
- pagine non canoniche;
- URL che non vuoi indicizzare.
Quando una pagina viene modificata materialmente, <lastmod> può comunicare la data effettiva della modifica. Non modificarlo artificialmente per simulare freschezza.
Migliorare capacità e stabilità del server
Se Crawl Stats e log mostrano che Google incontra spesso 5xx, 429 o forti rallentamenti, intervieni sul vero collo di bottiglia.
Può significare:
- più risorse;
- caching;
- ottimizzazione database;
- migliore gestione delle richieste;
- CDN;
- eliminazione di elaborazioni costose;
- controllo delle regole WAF;
- verifica del rate limiting.
Qui l’obiettivo non è “rendere Google felice”. È avere un’infrastruttura capace di servire correttamente utenti e crawler.
Usare HTTP caching e 304 Not Modified
Una delle ottimizzazioni più interessanti, e spesso trascurate, riguarda il caching HTTP.
Quando Google ha già recuperato una risorsa, può effettuare richieste condizionali utilizzando informazioni come ETag o Last-Modified.
Se la risorsa non è cambiata, il server può rispondere:
304 Not Modified
senza trasferire nuovamente il corpo della risposta.
Questo riduce banda e lavoro del server, rendendo più efficiente la scansione senza fingere che il contenuto sia stato aggiornato. Google include esplicitamente il supporto al 304 fra le pratiche per migliorare l’efficienza del crawling.
robots.txt, noindex e canonical: cosa usare per ogni problema
Questi tre strumenti vengono spesso messi nello stesso contenitore, ma hanno scopi differenti.
| Problema | Strumento principale | Cosa non fa |
|---|---|---|
| Non vuoi che Googlebot richieda determinati URL | robots.txt | Non garantisce la rimozione dell’URL dall’indice |
| Non vuoi che una pagina accessibile compaia nell’indice | noindex | Non evita il fetch necessario a leggere la direttiva |
| Hai URL duplicati e vuoi indicare la versione rappresentativa | canonical | Non blocca necessariamente il crawling delle varianti |
robots.txt per il crawling
Usalo quando il problema è l’accesso del crawler a una classe di URL.
Esempio:
un ecommerce genera milioni di URL di ordinamento senza alcun valore autonomo per Search e non riesci a eliminarli o consolidarli a monte.
In questo scenario può avere senso impedire il crawling del pattern appropriato.
noindex per l’indicizzazione
noindex risolve invece un problema diverso:
la pagina può essere visitata, ma non deve comparire nei risultati.
Perché Google possa rilevare noindex, deve poter recuperare la risorsa.
Di conseguenza, noindex non è lo strumento da scegliere con l’obiettivo specifico di risparmiare crawl budget su un sito che ne ha realmente bisogno.
Questo non rende noindex “sbagliato”. Rimane corretto quando l’obiettivo è tenere la pagina fuori dall’indice.
canonical per consolidare URL equivalenti
Il canonical serve a comunicare quale URL preferisci come rappresentativo fra versioni duplicate o molto simili.
Non va usato come sostituto di:
robots.txt;noindex;- redirect;
- status
404.
Se due URL non sono realmente equivalenti, indicare uno come canonical dell’altro può essere ignorato da Google.
Errori comuni nell’ottimizzazione del crawl budget
La parte più rischiosa del crawl budget non è ignorarlo. È ottimizzarlo quando non serve o con strumenti scelti per la ragione sbagliata.
Bloccare URL sperando che Google sposti il budget altrove
È probabilmente il mito più importante da correggere.
Se blocchi 100.000 URL, Google non prende automaticamente le 100.000 richieste “risparmiate” e le assegna alle tue landing page migliori.
La riallocazione può diventare rilevante quando Google sta effettivamente raggiungendo il crawl capacity limit. Altrimenti potrebbe semplicemente utilizzare meno risorse.
Ridurre l’inventario inutile resta corretto; aspettarsi un trasferimento matematico del budget no.
Usare noindex per “risparmiare crawl”
Se Google deve scansionare una pagina per vedere noindex, hai già utilizzato una richiesta.
Quindi:
noindex = controllo dell’indicizzazione
non:
noindex = blocco del crawling
È una distinzione semplice, ma cambia completamente il modo in cui progetti l’intervento.
Eliminare URL utili solo perché non generano traffico
Un URL senza traffico organico non è automaticamente inutile.
Potrebbe:
- servire l’utente;
- supportare una conversione;
- rappresentare una variante prodotto necessaria;
- aiutare la navigazione;
- essere una pagina di supporto;
- avere valore stagionale;
- avere un ruolo nell’architettura pur senza intercettare direttamente query.
Il criterio deve essere:
funzione della pagina + unicità + intent + necessità di crawling
non:
traffico = 0 → blocca.
Confondere crawlability, indicizzazione e ranking
Puoi avere:
- una pagina crawlable ma
noindex; - una pagina scansionata ma non indicizzata;
- una pagina indicizzata ma non competitiva;
- una pagina con ranking debole e zero problemi di crawl budget.
Se non distingui questi scenari rischi di cambiare robots.txt per risolvere un problema di contenuto oppure riscrivere contenuti quando il server restituisce errori.
Crawl budget negli ecommerce e nei siti molto grandi
È nei grandi ecommerce che il crawl budget smette più spesso di essere una discussione teorica.
Un catalogo può generare quantità di URL molto maggiori del numero di prodotti effettivi.
Filtri e faceted navigation
Considera una categoria con:
- 20 marche;
- 10 colori;
- 12 taglie;
- 8 fasce di prezzo;
- 4 ordinamenti.
Le combinazioni possibili diventano rapidamente enormi, anche se molte mostrano gli stessi prodotti in ordine differente o insiemi quasi identici.
Non devi necessariamente indicizzare né far scansionare tutte le combinazioni.
Devi però decidere quali faccette:
- corrispondono a una domanda reale;
- meritano una landing autonoma;
- devono essere consolidate;
- devono restare disponibili solo per l’utente;
- non devono proprio produrre URL crawlable.
URL parametrizzati
I parametri non sono cattivi in sé.
URL come:
?color=rosso
possono essere perfettamente legittimi.
Il problema nasce quando vengono combinati senza controllo, duplicati, riordinati o aggiunti a ogni click creando moltissime stringhe diverse che rappresentano praticamente lo stesso stato.
In fase di progettazione preferirei sempre prevenire l’esplosione degli URL invece di generare milioni di varianti e cercare successivamente di gestirle tutte tramite direttive SEO.
Prodotti rimossi o non disponibili
Non ogni prodotto non disponibile deve diventare un 404.
La decisione dipende dallo stato reale:
- temporaneamente non disponibile → la pagina può restare valida;
- prodotto definitivamente eliminato senza sostituto →
404/410può avere senso; - prodotto sostituito da un equivalente reale → redirect al replacement può essere appropriato.
Eviterei redirect di massa alla categoria o alla home soltanto per eliminare errori dai report.
Sitemap multiple e grandi inventari URL
Quando l’inventario cresce, suddividere le sitemap può aiutare soprattutto sul piano diagnostico e gestionale.
Puoi, per esempio, separare:
prodotti
categorie
articoli
landing
Il vantaggio non deriva dal fatto che Google “preferisca” tante sitemap. Deriva dalla capacità di osservare più facilmente quale parte dell’inventario viene scoperta e indicizzata.
Domande frequenti sul crawl budget
Il crawl budget è un ranking factor?
Non va trattato come un ranking factor diretto.
Il crawling è necessario perché Google possa recuperare le pagine, ma essere scansionati più spesso non implica automaticamente un ranking migliore.
Se esiste un serio problema di crawling, risolverlo può consentire alle pagine di entrare correttamente nelle fasi successive. Da lì, però, indicizzazione e ranking dipendono da altri sistemi.
Ogni sito ha un crawl budget?
Google dispone di meccanismi per stabilire quanto può e vuole scansionare ciascun hostname, quindi il concetto esiste anche per siti piccoli.
Questo non significa che ogni sito abbia un problema di crawl budget da ottimizzare.
Per molte proprietà normali è sufficiente assicurarsi che gli URL importanti siano raggiungibili, la sitemap sia coerente, il server funzioni correttamente e Search Console non mostri anomalie significative.
Come aumentare il crawl budget?
Google indica due grandi leve.
La prima riguarda la capacità del server: se il limite dipende dall’infrastruttura, aumentare le risorse può permettere più crawling.
La seconda riguarda la domanda: per Google Search entrano in gioco elementi come popolarità, valore complessivo per l’utente, unicità dei contenuti e capacità di serving.
Non esiste quindi un pulsante “aumenta crawl budget” né una richiesta da inviare a Google per ottenere più crawling.
Più crawl budget significa indicizzazione più veloce?
Non necessariamente.
Se il collo di bottiglia era veramente la scansione, una maggiore capacità o una migliore efficienza possono aiutare Google a recuperare prima determinati URL.
Se invece Google ha già scansionato le pagine ma decide di non indicizzarle, aumentare il crawling non risolve il problema.
Prima devi capire in quale fase si trova l’ostacolo.
Un sito WordPress deve ottimizzare il crawl budget?
Non per il semplice fatto di usare WordPress.
Un normale sito WordPress con un numero gestibile di contenuti probabilmente non richiede un progetto dedicato al crawl budget.
Diventa interessante quando plugin, template o configurazioni producono grandi spazi URL: ricerche interne, archivi inutili, parametri, filtri ecommerce, calendari o altre combinazioni.
Il CMS conta quindi per ciò che genera, non per il suo nome.
Conclusione
Il crawl budget è importante quando rappresenta un limite reale alla capacità di Google di recuperare gli URL che contano, non perché ogni sito possieda un fantomatico serbatoio SEO da riempire o proteggere.
Per un normale blog o sito aziendale partirei da cose più semplici: pagine importanti raggiungibili, server stabile, sitemap coerente e assenza di blocchi tecnici. Se Google trova e scansiona regolarmente ciò che pubblichi, probabilmente non hai bisogno di “aumentare” nulla.
Su ecommerce, marketplace e siti molto grandi il discorso cambia. Lì guarderei prima l’inventario: faccette, parametri, duplicati, soft 404, redirect, URL rimossi. Poi confronterei Crawl Stats con i log per capire dove finiscono realmente le richieste. Solo dopo deciderei se intervenire sul crawling o sulla capacità del server.
Il principio utile è questo: non ottimizzare il crawl budget perché esiste; ottimizzalo quando i dati mostrano che sta limitando il crawling delle risorse che dovrebbero essere recuperate.
Se la diagnosi coinvolge contemporaneamente crawling, indicizzazione, canonical, sitemap, server e grandi famiglie di URL, allora il problema non è più una singola direttiva: entra nel perimetro di un audit SEO tecnico.