
Screaming Frog SEO Spider è un crawler per l’analisi tecnica dei siti web. Inserisci un dominio o un elenco di URL, avvii la scansione e il software raccoglie dati su link, codici di stato HTTP, redirect, canonical, direttive robots, title, meta description, heading, immagini, contenuti duplicati, dati strutturati e molti altri elementi utili durante un audit SEO.
La versione gratuita permette di scansionare fino a 500 URL. Per siti più grandi e per funzioni come rendering JavaScript, salvataggio e confronto dei crawl, scheduling, integrazioni avanzate e analisi semantiche serve invece una licenza.
Il punto importante, però, è un altro: Screaming Frog non decide cosa devi correggere e non sostituisce Google Search Console o Googlebot. Trasforma il sito in un dataset molto dettagliato; sta poi a chi conduce l’analisi distinguere un’anomalia tecnica da un problema realmente prioritario.
In questa guida vediamo come funziona Screaming Frog SEO Spider, come impostare il primo crawl, quali controlli sono davvero utili durante un audit e cosa cambia tra versione gratuita e licenza.
Cos’è Screaming Frog SEO Spider e cosa fa davvero
Screaming Frog SEO Spider è un software desktop sviluppato da Screaming Frog Ltd e disponibile per Windows, macOS e Linux.
Il suo lavoro principale consiste nel seguire gli URL di un sito e raccogliere informazioni sulle risorse incontrate, in modo simile a quanto fanno altri crawler utilizzati per audit tecnici.
Partendo da una pagina iniziale, il programma segue i collegamenti che trova, registra le risposte del server e costruisce progressivamente una rappresentazione della struttura del sito.
Da questo processo puoi ricavare, per esempio:
- URL raggiungibili attraverso i link interni;
- codici di risposta HTTP;
- redirect e relative catene;
- pagine canoniche e canonical dichiarati;
- direttive
index,noindex,followenofollow; - title e meta description;
- heading H1 e H2;
- immagini e relativi attributi;
- link interni ed esterni;
- profondità di scansione;
- hreflang;
- dati strutturati;
- pagine duplicate o molto simili;
- sitemap XML;
- dati provenienti da Search Console, GA4 e PageSpeed Insights quando le integrazioni sono attive.
È quindi uno degli strumenti più utili quando devi passare dalla percezione generica che “qualcosa non va” a un inventario concreto di URL e segnali tecnici.
Per capire come questi dati entrano in un controllo più ampio puoi approfondire la nostra guida alla SEO tecnica.
Come funziona il crawler
In modalità Spider inserisci normalmente l’URL iniziale del sito e avvii la scansione.
Il crawler richiede la pagina, legge i link che può seguire e aggiunge alla coda gli URL scoperti. Il processo continua finché raggiunge i limiti configurati o non trova più risorse da analizzare.
Questo significa che il risultato del crawl dipende anche dalla configurazione.
Se escludi una directory, limiti la profondità, cambi user-agent, blocchi determinati parametri o utilizzi il rendering JavaScript, il dataset ottenuto può cambiare anche sensibilmente.
Prima di concludere che una pagina “non esiste” o “non è raggiungibile”, quindi, conviene sempre verificare:
- da quale URL è partito il crawl;
- quali regole include/exclude sono attive;
- quale user-agent stai utilizzando;
- se il sito richiede JavaScript per generare link o contenuti;
- se robots.txt o altre impostazioni limitano la scansione;
- se l’URL è raggiungibile solo tramite sitemap, API, form o altri percorsi non seguiti dal crawler.
È proprio questa configurabilità a rendere Screaming Frog potente, ma anche facile da interpretare male.
Screaming Frog non è Googlebot: la differenza che conta
Una delle semplificazioni più frequenti consiste nel dire che Screaming Frog “simula esattamente Googlebot”.
Non è corretto.
Googlebot è il crawler della Ricerca Google e Google distingue, tra gli altri, Googlebot Smartphone e Googlebot Desktop. Screaming Frog utilizza invece il proprio crawler e può essere configurato con differenti user-agent e modalità di rendering.
Puoi quindi creare un ambiente di scansione più vicino a determinate condizioni di Googlebot, ma un crawl di Screaming Frog non rappresenta ciò che Google ha effettivamente scansionato, renderizzato, indicizzato o scelto come canonical.
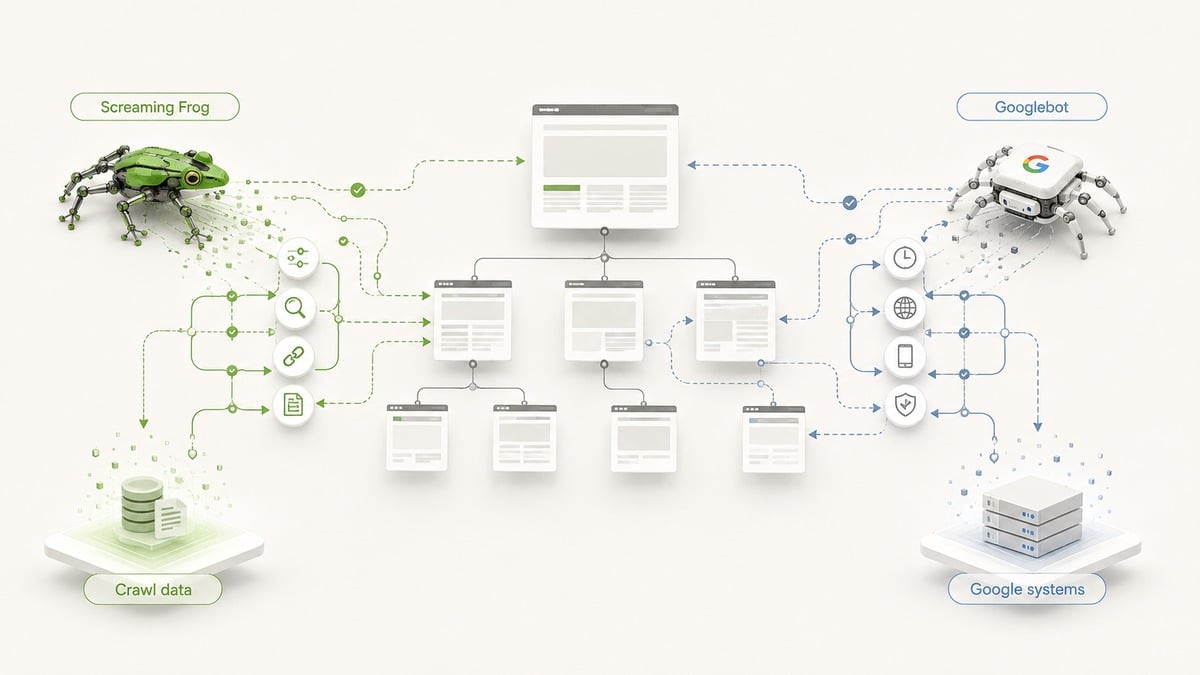
La documentazione ufficiale di Googlebot è utile per capire questa distinzione.
Se invece vuoi osservare richieste realmente effettuate dai crawler sul server, l’analisi cambia completamente: in quel caso entrano in gioco i file di log del server.
Questa differenza evita parecchi falsi problemi. Se Screaming Frog non trova una pagina, per esempio, non significa automaticamente che Google non la conosca. Allo stesso modo, una pagina presente nel crawl non è necessariamente indicizzata.
Quali dati raccoglie durante una scansione
L’interfaccia organizza le informazioni in schede e filtri.
Per una normale analisi tecnica, le aree più importanti sono generalmente:
| Area | Cosa permette di controllare |
|---|---|
| Internal | URL interni, status code, indexability, depth e dati principali |
| Response Codes | 2xx, 3xx, 4xx, 5xx e redirect |
| URL | caratteristiche e possibili anomalie degli indirizzi |
| Page Titles | title mancanti, duplicati o da revisionare |
| Meta Description | presenza e duplicazioni delle description |
| H1 / H2 | heading presenti, assenti o duplicati |
| Images | immagini, dimensioni e attributi alt |
| Canonicals | canonical dichiarati e possibili incoerenze |
| Directives | robots directives e attributi collegati |
| Hreflang | implementazioni internazionali |
| Structured Data | dati strutturati individuati |
| Sitemaps | confronto con URL contenuti nelle sitemap |
| JavaScript | differenze e problemi osservabili con rendering JS |
| Content | duplicati e analisi di similarità |
Non tutti gli elementi segnalati richiedono una correzione.
Un title duplicato, un redirect o un canonical diverso dall’URL corrente possono essere perfettamente intenzionali. L’issue è un punto da investigare, non una sentenza SEO.
Come iniziare con Screaming Frog: installazione e primo crawl
Il modo migliore per imparare Screaming Frog non è partire dalle funzioni più avanzate. Conviene prima capire cosa produce un crawl standard e come leggere il dataset.
Installazione su Windows, macOS e Linux
Puoi scaricare SEO Spider dal sito ufficiale di Screaming Frog.
Dopo l’installazione puoi iniziare anche senza licenza, tenendo presente il limite dei 500 URL della versione gratuita.
Per siti piccoli può essere sufficiente per molte verifiche. Per un sito più grande, invece, il limite può impedire al crawl di raggiungere sezioni importanti e produrre quindi una fotografia incompleta.
Come avviare la prima scansione
Per il primo test eviterei configurazioni troppo sofisticate.
Inserisci l’homepage nel campo superiore, lascia inizialmente le impostazioni standard e premi Start.
Durante il crawl vedrai aumentare il numero di URL scoperti. Quando la scansione termina, non partire immediatamente dall’elenco degli “errori”: prima controlla se il crawler ha esplorato il sito che pensavi di analizzare.
Le prime domande da farti sono:
- quanti URL HTML sono stati trovati?
- quali directory compaiono?
- sono presenti le sezioni strategiche?
- il crawler ha scoperto URL inattesi?
- ci sono parametri o faceted navigation che stanno moltiplicando gli indirizzi?
- il numero di pagine è compatibile con la dimensione reale del sito?
Se ti aspettavi 2.000 pagine e ne trovi 80, cercare title duplicati è prematuro. Prima devi capire perché il crawl è incompleto.
Definire correttamente lo scope
Lo scope stabilisce cosa vuoi realmente analizzare.
In alcuni audit interessa l’intero dominio. In altri casi vuoi limitarti a una directory, a un sottodominio o a un insieme preciso di URL.
È possibile utilizzare configurazioni include/exclude, limiti di scansione, sitemap e modalità List per restringere il dataset.
Un esempio concreto: se stai analizzando soltanto il blog, includere migliaia di URL provenienti da un’area riservata o da parametri di filtro può rendere il dataset inutilmente rumoroso.
La configurazione non serve quindi solo a “far funzionare” il crawler: serve a fare la domanda corretta al sito.
Come usare Screaming Frog per un audit SEO
Un audit efficace non consiste nell’esportare tutti gli errori e consegnarli a uno sviluppatore.
La sequenza più utile è:
scansione → anomalia → verifica → impatto → priorità → intervento
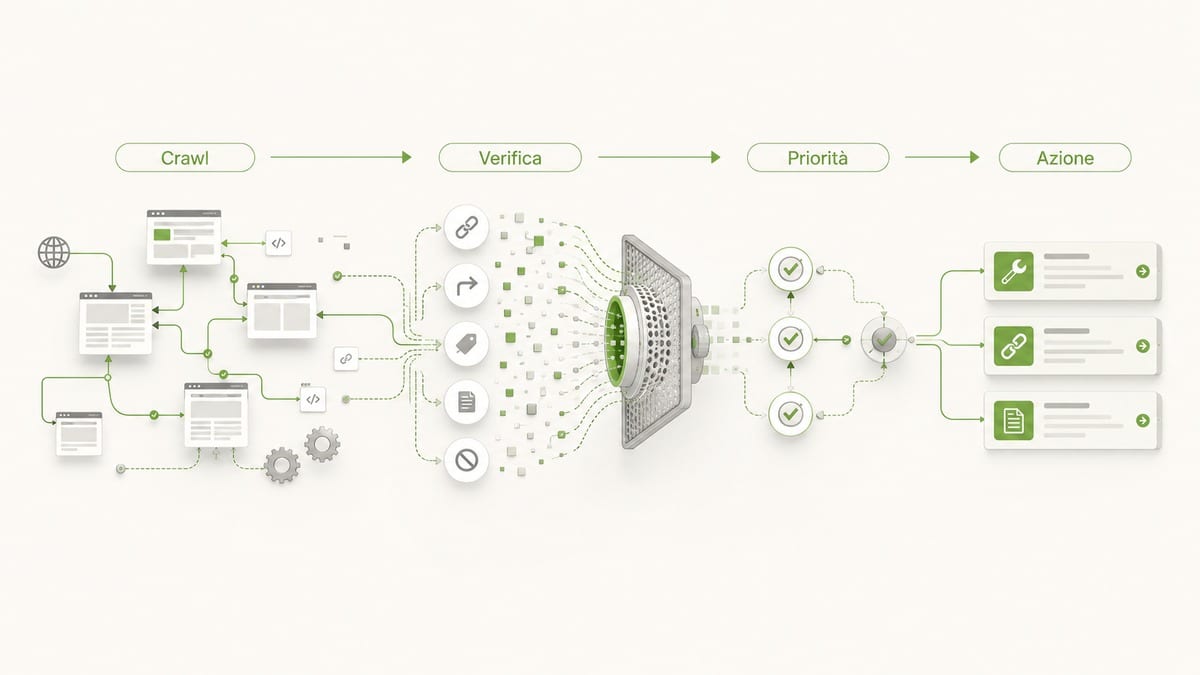
Vediamo dove Screaming Frog aiuta maggiormente.
Errori 4xx e 5xx, link rotti e redirect
La scheda Response Codes permette di isolare rapidamente codici di stato differenti.
Un 404 indica che la risorsa richiesta non è disponibile all’indirizzo richiesto. Questo non equivale automaticamente a un problema di ranking: può essere perfettamente normale che un URL eliminato restituisca 404.
Diventa invece interessante capire:
- se l’URL riceve link interni;
- se dovrebbe ancora esistere;
- se ha un sostituto realmente equivalente;
- se compare nelle sitemap;
- se fa parte di un percorso importante per utenti o crawler.
La stessa logica vale per i redirect.
Un singolo 301 intenzionale non è di per sé un problema. Una catena del tipo:
URL A → URL B → URL C → URL D
merita invece una verifica, soprattutto se migliaia di link interni continuano a puntare alla prima destinazione.
Screaming Frog è particolarmente efficace perché non mostra soltanto il codice HTTP: permette di risalire anche alle pagine che contengono quei collegamenti.
Indicizzabilità, robots.txt, canonical e sitemap XML
La scansione consente di incrociare più segnali che spesso vengono confusi tra loro:
- accessibilità al crawler;
- direttive robots;
- canonical;
- presenza nella sitemap;
- risposta HTTP.
Una pagina può essere raggiungibile ma avere noindex. Può restituire 200 ma dichiarare come canonical un altro URL. Può essere presente nella sitemap e contemporaneamente reindirizzare altrove.
Queste combinazioni sono spesso più interessanti del singolo dato isolato.
Per esempio, una sitemap XML contenente numerosi URL reindirizzati, non canonici o noindex merita una revisione: la sitemap dovrebbe aiutare a comunicare quali URL del sito vuoi proporre ai motori di ricerca, non diventare un inventario indiscriminato di qualsiasi indirizzo generato dal CMS.
Screaming Frog può anche generare sitemap XML, ma prima di farlo conviene verificare attentamente quali URL debbano effettivamente entrarvi.
Title, meta description e heading
SEO Spider permette di analizzare title, meta description, H1 e H2 su scala molto più rapidamente di un controllo manuale.
I filtri sono utili per trovare:
- elementi mancanti;
- duplicazioni;
- title estremamente simili;
- pagine prive di H1;
- heading ripetuti in modo sospetto.
Qui bisogna però evitare l’ottimizzazione meccanica.
Un title non diventa migliore solo perché rispetta una lunghezza predefinita e una meta description non deve necessariamente contenere una determinata quantità di keyword.
Il crawler serve soprattutto a trovare pattern che meritano una revisione editoriale.
Se 400 schede prodotto hanno esattamente lo stesso title, probabilmente esiste un problema di template. Se invece due pagine molto simili condividono parte del titolo, occorre prima capire se hanno davvero intent differenti.
Contenuti duplicati e near duplicate
Screaming Frog può individuare duplicati esatti e, con le funzioni avanzate, contenuti molto simili.
La duplicazione tecnica può derivare da:
- parametri URL;
- filtri;
- versioni HTTP/HTTPS;
- sottodomini;
- paginazioni o archivi;
- template;
- copie effettive dello stesso contenuto.
Anche in questo caso, duplicato non significa automaticamente penalizzazione.
La domanda utile è piuttosto: perché queste versioni esistono, quale deve essere accessibile o indicizzabile e che relazione c’è tra loro?
Link interni e crawl depth
Uno degli utilizzi che considero più interessanti riguarda la struttura dei link interni.
Per ogni URL puoi osservare:
- quanti link interni riceve;
- da quali pagine arrivano;
- a quali pagine punta;
- con quali anchor;
- a quale profondità viene scoperto.
Questo aiuta a individuare pagine strategiche scarsamente collegate oppure sezioni del sito raggiungibili solo attraverso percorsi profondi.
Una pagina importante non diventa automaticamente “migliore” aggiungendo cento link interni. Tuttavia, se una risorsa che dovrebbe essere centrale è raggiungibile soltanto dopo cinque o sei passaggi, vale la pena rivedere l’architettura.
Pagine orfane: perché un normale crawl non basta
Qui emerge un limite concettuale importante.
Se una pagina non riceve alcun link interno, un crawler che scopre gli URL seguendo i link potrebbe non incontrarla affatto.
Per cercare possibili pagine orfane devi quindi fornire a Screaming Frog altre fonti URL, per esempio sitemap XML, Search Console o Analytics, e confrontare gli indirizzi presenti in questi dataset con quelli scoperti dal crawl.
È un buon esempio di come l’integrazione di più fonti sia spesso più utile del singolo report.
Rendering JavaScript per React, Vue e altri siti dinamici
La modalità standard analizza il codice ricevuto dal server.
Su siti in cui contenuti e link vengono generati lato client tramite JavaScript, questo può produrre una visione incompleta.
Con la versione a pagamento puoi attivare il JavaScript rendering. Screaming Frog utilizza Chromium per renderizzare le pagine e permette di analizzare elementi presenti nel DOM renderizzato.
La documentazione di configurazione di SEO Spider spiega le opzioni disponibili.
Il rendering è particolarmente utile quando vuoi confrontare:
- HTML sorgente;
- contenuto renderizzato;
- link presenti solo dopo l’esecuzione degli script;
- dipendenze JavaScript;
- risorse bloccate o problematiche.
Anche Google renderizza JavaScript durante i propri processi di crawling e indicizzazione, ma questo non significa che il rendering di Screaming Frog riproduca perfettamente ogni comportamento di Google.
Screaming Frog gratis o a pagamento: cosa cambia davvero
La versione gratuita non è una demo quasi inutilizzabile. Per siti piccoli e controlli mirati può già fornire parecchi dati.
Il limite più evidente sono i 500 URL per crawl.
La licenza sblocca soprattutto scala, configurabilità, integrazioni e automazione.
| Funzione | Versione gratuita | Versione a pagamento |
|---|---|---|
| Link rotti, errori e redirect | Sì | Sì |
| Analisi title e meta data | Sì | Sì |
| Meta robots e directives | Sì | Sì |
| Hreflang | Sì | Sì |
| Duplicati esatti | Sì | Sì |
| Generazione sitemap XML | Sì | Sì |
| Visualizzazioni del sito | Sì | Sì |
| Limite crawl | 500 URL | Senza limite software fisso* |
| Salvataggio e apertura crawl | No | Sì |
| Scheduling | No | Sì |
| Rendering JavaScript | No | Sì |
| Crawl comparison | No | Sì |
| Near duplicate | No | Sì |
| Custom extraction e JavaScript | No | Sì |
| Integrazione GA4 | No | Sì |
| Integrazione Search Console | No | Sì |
| Integrazione PageSpeed Insights | No | Sì |
| Funzioni AI e semantic analysis | No | Sì |
| MCP Server | No | Sì |
*La capacità reale dipende comunque dalle risorse disponibili sulla macchina e dalla modalità di storage utilizzata.
Quanto costa Screaming Frog
Al momento della verifica editoriale, una licenza individuale per 1–4 utenti costa €245 per utente all’anno.
Per quantità superiori sono previsti sconti progressivi.
Il prezzo corrente va sempre controllato sulla pagina ufficiale delle licenze Screaming Frog, perché può cambiare.
Quando basta la versione gratuita
La versione free ha senso soprattutto quando:
- analizzi un sito molto piccolo;
- devi controllare pochi URL;
- vuoi verificare redirect e status code;
- stai imparando a utilizzare il crawler;
- devi effettuare un controllo circoscritto.
Su un sito di 80 pagine, per esempio, il limite dei 500 URL può non essere un problema.
Attenzione però alle risorse: CSS, JavaScript, immagini e altri URL possono contribuire alla scansione a seconda della configurazione.
Quando la licenza vale la spesa
Il paid cambia realmente il workflow se utilizzi Screaming Frog per lavoro.
Ha senso soprattutto quando devi:
- analizzare siti sopra i 500 URL;
- salvare progetti e confrontarli nel tempo;
- effettuare audit JavaScript;
- automatizzare crawl ricorrenti;
- integrare GSC, GA4 o PageSpeed;
- utilizzare custom extraction;
- lavorare con grandi dataset;
- analizzare contenuti simili semanticamente;
- utilizzare funzionalità AI o MCP.
Per un singolo controllo occasionale la licenza può essere eccessiva. Per un consulente o un’agenzia che esegue audit regolarmente, queste funzioni cambiano invece parecchio la produttività.
GSC, GA4 e PageSpeed: quando integrare i dati del crawl
Il crawl tecnico diventa molto più interessante quando viene collegato a dati che rispondono a domande diverse.
Screaming Frog permette di integrare Google Search Console, Google Analytics 4 e PageSpeed Insights.
Google Search Console
L’integrazione con Search Console permette di recuperare dati Search Analytics come:
- clic;
- impression;
- CTR;
- posizione.
Può inoltre utilizzare la URL Inspection API per aggiungere informazioni relative allo stato degli URL in Google, entro i limiti previsti dall’API.
Il vantaggio non è semplicemente “avere Search Console dentro Screaming Frog”.
Il vantaggio è poter porre domande come:
Quali pagine ricevono impression ma hanno pochi link interni?
oppure:
Quali URL presenti nei dati Google non vengono scoperti dal normale crawl del sito?
Questo tipo di incrocio può far emergere problemi che nessuno dei due strumenti mostrerebbe con la stessa chiarezza da solo.
Google Analytics 4
L’integrazione GA4 permette di associare al crawl metriche relative alle landing page.
Può essere utile per distinguere una criticità teorica da un URL che genera realmente visite, conversioni o valore per il sito.
Se trovi migliaia di anomalie, sapere quali interessano le pagine utilizzate dagli utenti può aiutarti a stabilire un ordine di analisi.
Questo non significa che le pagine senza traffico siano automaticamente irrilevanti. Significa soltanto aggiungere contesto business al dataset tecnico.
PageSpeed Insights
L’integrazione PageSpeed permette di recuperare metriche e diagnostiche Lighthouse e, quando disponibili tramite l’API, dati CrUX.
È utile soprattutto per analizzare un problema su scala.
Invece di aprire manualmente centinaia di URL in PageSpeed Insights, puoi affiancare alcune metriche di performance alle pagine del crawl e filtrare i casi su cui investigare.
Anche qui eviterei di trasformare automaticamente un punteggio Lighthouse in priorità SEO. I dati servono a individuare pattern e problemi tecnici; la decisione richiede contesto.
Analisi semantica, AI Prompt e MCP: le funzioni più recenti
Le versioni recenti di SEO Spider hanno ampliato molto il perimetro del prodotto.
Il crawler non lavora più soltanto su status code, tag e link: può utilizzare embedding, modelli AI e un server MCP per analizzare o interrogare i dati in modi nuovi.
Sono funzioni interessanti, ma vanno tenute separate dall’hype.
Semantic Similarity e content cluster
Screaming Frog può utilizzare embedding generati tramite provider AI per valutare la similarità semantica tra pagine.
L’analisi non guarda semplicemente se due testi contengono le stesse parole. Trasforma il contenuto in rappresentazioni vettoriali che consentono di stimare quanto due pagine siano semanticamente vicine.
Può essere utile per:
- trovare contenuti molto simili;
- individuare possibili sovrapposizioni;
- cercare pagine correlate;
- identificare outlier;
- supportare redirect mapping durante una migrazione;
- esplorare opportunità di linking interno;
- visualizzare cluster di contenuti.
La documentazione ufficiale specifica anche un threshold di similarità configurabile. Il valore è però un criterio dello strumento, non una soglia universale che stabilisce quando Google considera due pagine duplicate o cannibalizzate.
Una similarità elevata può essere perfettamente normale.
Due pagine sullo stesso argomento possono avere intent diversi e meritare entrambe di esistere. La documentazione sulla Semantic Similarity invita infatti a revisionare i risultati nel loro contesto.
AI Prompt con OpenAI, Gemini, Anthropic e modelli locali
SEO Spider può collegarsi a provider AI e utilizzare prompt sui contenuti scansionati.
A seconda della configurazione puoi impiegare questi modelli per attività come classificazione, estrazione o analisi del contenuto.
Questo apre workflow interessanti, ma introduce anche almeno tre cautele.
La prima è la qualità del prompt: una classificazione sbagliata applicata a 20.000 pagine produce semplicemente 20.000 risultati sbagliati più rapidamente.
La seconda riguarda i costi e i limiti delle API utilizzate.
La terza riguarda dati e privacy: quando invii contenuti a servizi esterni devi sapere quali informazioni vengono trasmesse e con quali condizioni.
L’AI aggiunge capacità di elaborazione. Non rende automaticamente corretta l’interpretazione SEO.
Cosa permette di fare Screaming Frog MCP
Tra le evoluzioni più interessanti c’è il server MCP, disponibile con licenza a pagamento.
MCP, Model Context Protocol, permette a client e assistenti AI compatibili di interagire con gli strumenti esposti da SEO Spider.
In pratica un assistente compatibile può accedere a dati di crawl, report ed export e, in determinate configurazioni, avviare o manipolare processi attraverso gli strumenti messi a disposizione dal server.
Screaming Frog documenta configurazioni con client come Claude Desktop e LM Studio.
È una differenza importante rispetto al semplice “chiedere a un chatbot di analizzare un CSV”: l’assistente può lavorare direttamente con strumenti e dati messi a disposizione dal software.
La documentazione MCP di Screaming Frog sottolinea però anche implicazioni di sicurezza, accesso ai file, esecuzione di script e privacy.
Per questo non attiverei indiscriminatamente tutte le capacità disponibili. Più potere concedi all’agente, più diventano importanti permessi, isolamento e controllo del risultato.
Crawl periodici e confronto: usare Screaming Frog per monitorare i cambiamenti
Un singolo crawl è una fotografia.
Due crawl confrontabili iniziano invece a raccontare cosa è cambiato.
Questa differenza è importante su siti aggiornati frequentemente, durante migrazioni o quando più persone intervengono sull’infrastruttura.
Scheduling e salvataggio delle scansioni
Con la licenza puoi programmare crawl e salvare i risultati.
Questo permette di trasformare un controllo manuale in un sistema periodico.
Per esempio puoi eseguire un crawl ricorrente e verificare se nel frattempo:
- sono comparsi nuovi 404;
- è cambiato il numero di pagine indicizzabili;
- sono stati rimossi canonical;
- sono apparsi redirect inattesi;
- alcune sezioni hanno perso link interni;
- sono cambiate direttive robots.
Il valore non è il fatto di avere “più audit”, ma poter confrontare condizioni omogenee nel tempo.
Auto Compare Crawls e change detection
Le versioni recenti hanno esteso il confronto automatico tra crawl.
L’opzione Auto Compare Crawls permette di confrontare le due scansioni più recenti di un progetto e riportare le differenze rilevate.
Può essere molto utile in un workflow di monitoring, perché risponde a una domanda diversa dal normale audit:
cosa è cambiato rispetto all’ultima volta?
Se ieri il sito aveva 3 errori 404 e oggi ne ha 150, questa variazione è spesso più informativa del semplice numero “150”.
La stessa logica vale per modifiche a canonical, indexability e altri elementi.
Migrazioni e staging
Il confronto tra crawl è particolarmente utile durante una migrazione.
Una procedura sensata può prevedere:
- crawl del sito live prima della migrazione;
- scansione dello staging;
- mappatura degli URL;
- verifica dei redirect;
- nuovo crawl dopo il go-live;
- confronto con la situazione precedente.
In questo scenario Screaming Frog diventa una sorta di controllo differenziale tra due stati del sito.
È molto più affidabile che ricordare manualmente “come era configurato prima”.
Workflow pratici in cui Screaming Frog è davvero utile
Le funzioni diventano più comprensibili quando partiamo dal problema e non dal menu del software.
Controllare una migrazione prima e dopo il go-live
In una migrazione puoi utilizzare il crawler per costruire l’inventario degli URL esistenti, analizzare lo staging, verificare redirect e ricontrollare la struttura dopo il passaggio.
Ciò aiuta a intercettare:
- pagine dimenticate;
- redirect mancanti;
- redirect verso destinazioni poco pertinenti;
- canonical rimasti sul dominio di staging;
noindexdimenticati;- link interni che continuano a usare i vecchi URL;
- differenze nella struttura.
Nessun crawler può garantire che una migrazione non perda traffico. Può però ridurre drasticamente il numero di errori tecnici invisibili a un controllo manuale.
Individuare problemi di linking interno
Supponiamo che una pagina importante riceva un solo link interno e venga raggiunta a profondità elevata.
Screaming Frog ti permette di individuare la situazione e, soprattutto, vedere da dove arrivano i link esistenti.
A quel punto il lavoro SEO inizia davvero: devi cercare pagine semanticamente pertinenti dalle quali un collegamento aggiuntivo sarebbe utile al lettore.
Il software trova il pattern. La qualità del nuovo collegamento resta una decisione editoriale.
Trovare contenuti semanticamente troppo vicini
Con l’analisi degli embedding puoi individuare gruppi di pagine fortemente simili.
Non procederei mai con un merge automatico basato sul solo similarity score.
Userei invece il dato per creare una shortlist da controllare:
- le pagine rispondono alla stessa query?
- soddisfano lo stesso intento?
- hanno entrambe visibilità?
- una è semplicemente una variante meno completa?
- servono davvero come URL separati?
La similarità segnala un possibile overlap; non decide l’ownership del topic.
Incrociare crawl e Search Console per stabilire le priorità
Immagina di avere:
- 5.000 URL indicizzabili;
- 800 anomalie;
- 120 pagine con impression;
- 30 pagine che generano la maggior parte dei clic.
Lavorare in ordine alfabetico sugli 800 problemi sarebbe poco razionale.
Incrociando crawl e GSC puoi invece individuare le criticità che coinvolgono URL già visibili in Ricerca, senza perdere di vista i problemi strutturali che potrebbero interessare intere sezioni.
Questo è uno dei motivi per cui una SEO audit professionale non dovrebbe coincidere con l’esportazione automatica del report di un tool.
Screaming Frog vs Sitebulb, Ahrefs Site Audit e crawler cloud
Non esiste un crawler migliore in assoluto.
La scelta cambia in base al tipo di audit, al volume del sito, al modo in cui lavora il team e al livello di controllo richiesto.
| Scenario | Screaming Frog | Sitebulb | Ahrefs Site Audit |
|---|---|---|---|
| Crawl locale con grande controllo | Molto adatto | Disponibile con Desktop | No, workflow cloud |
| Analisi cloud | Non è il modello principale | Disponibile con Sitebulb Cloud | Sì |
| Collaborazione sullo stesso progetto | Più dipendente dal workflow del team | Forte nel Cloud | Integrata nella piattaforma |
| Rendering JavaScript | Sì, paid | Sì | Sì |
| Confronto audit nel tempo | Sì | Sì | Sì |
| Reporting già interpretato | Più orientato al dato grezzo | Forte su hint e visualizzazioni | Forte su issue e dashboard |
| Personalizzazione ed estrazione | Molto elevata | Elevata | Più legata alla piattaforma |
| AI/MCP sul dataset del crawler | MCP e funzioni AI dedicate | Funzioni proprie della piattaforma | Ecosistema Ahrefs |
| Integrazione con suite backlink/rank | Tramite API esterne | Limitata rispetto a suite complete | Nativa nell’ecosistema Ahrefs |
Quando sceglierei Screaming Frog
Screaming Frog ha particolarmente senso se vuoi:
- grande controllo sulla configurazione;
- accesso granulare ai dati del crawl;
- custom extraction;
- scripting e automazioni;
- audit locali;
- possibilità di interrogare dataset molto specifici;
- integrazioni personalizzate;
- workflow tecnici complessi.
È uno strumento che tende a restituirti molti dati e lasciarti parecchia libertà su come interpretarli.
Questa libertà è un vantaggio per un SEO esperto e può essere uno svantaggio per chi cerca un report immediatamente pronto da consegnare.
Quando Sitebulb può avere più senso
Sitebulb è disponibile sia come applicazione desktop sia in modalità cloud e mette molta enfasi su prioritizzazione, visualizzazioni e spiegazione degli issue.
Può quindi essere interessante quando il risultato deve essere condiviso facilmente con stakeholder meno tecnici oppure quando vuoi un workflow cloud collaborativo.
Non significa che l’interpretazione automatica sostituisca l’analisi: significa che il prodotto dedica più spazio alla presentazione del problema.
Quando Ahrefs Site Audit può essere più comodo
Ahrefs Site Audit appartiene a una suite più ampia.
Se utilizzi già Ahrefs per backlink, keyword, contenuti e analisi competitiva, avere audit e monitoraggio nello stesso ecosistema può semplificare il lavoro.
Il prodotto supporta JavaScript, crawl pianificati e numerose verifiche tecniche.
Screaming Frog mantiene invece un vantaggio importante quando il tuo obiettivo principale è manipolare in profondità il crawl e costruire analisi molto personalizzate.
Il criterio non dovrebbe quindi essere “quale trova più errori?”, ma:
quale strumento produce il dataset e il workflow più adatti alla decisione che devo prendere?
Limiti di Screaming Frog ed errori di interpretazione
Imparare Screaming Frog significa anche capire cosa non può dirti.
Questo è probabilmente più importante che conoscere ogni menu.
Un crawl non dice automaticamente cosa Google ha indicizzato
SEO Spider può mostrarti che un URL:
- esiste;
- restituisce 200;
- è raggiungibile;
- non ha
noindex; - ha canonical self-referencing.
Da questo non puoi concludere automaticamente che Google lo abbia indicizzato.
Crawling e indexing sono processi differenti. La documentazione Google su crawling e indicizzazione li tratta infatti separatamente.
Per lo stato osservato da Google devi usare dati e strumenti appropriati, come Search Console e URL Inspection.
Un issue non equivale automaticamente a una priorità SEO
Se il crawler trova 3.000 title “troppo lunghi”, non significa che la prima attività dell’audit debba essere riscrivere 3.000 title.
Magari il problema reale del sito è una sezione strategica bloccata da noindex, una migrazione gestita male o migliaia di link interni verso redirect.
La priorità nasce dall’incrocio tra:
gravità tecnica + diffusione + tipologia di pagina + domanda organica + business + costo della correzione
Non dal numero rosso più grande presente nell’interfaccia.
Configurazione e JavaScript possono cambiare il risultato
Due crawl dello stesso dominio possono restituire risultati diversi se utilizzi:
- user-agent differenti;
- rendering differenti;
- regole include/exclude;
- velocità differenti;
- autenticazione;
- sitemap aggiuntive;
- limiti;
- configurazioni robots personalizzate.
Prima di confrontare due audit devi quindi essere sicuro che le condizioni siano sufficientemente omogenee.
I grandi crawl dipendono dalle risorse disponibili
La versione paid non applica il limite dei 500 URL, ma questo non significa che un normale computer possa scansionare una quantità infinita di risorse.
RAM, CPU, spazio disco, modalità di storage, rendering JavaScript e configurazione influenzano il carico.
Su siti molto grandi conviene pianificare attentamente il crawl, evitare di raccogliere dati inutili e utilizzare filtri e segmentazioni quando necessario.
Il tool raccoglie dati, la priorità resta una decisione umana
Questa è la distinzione che vale più di qualsiasi elenco di feature.
Screaming Frog è estremamente bravo a rispondere a domande come:
- quali URL restituiscono 404?
- quali pagine hanno questo canonical?
- quali URL ricevono pochi link interni?
- dove compare un determinato elemento HTML?
- quali contenuti sono molto simili?
- cosa è cambiato dall’ultimo crawl?
È molto meno adatto a rispondere da solo a:
- quale problema devo correggere per primo?
- queste due pagine devono essere unite?
- questo redirect è semanticamente corretto?
- questa pagina merita di essere indicizzata?
- questo contenuto soddisfa l’intento di ricerca?
- questa modifica migliorerà il traffico?
Quelle sono decisioni SEO, non semplici query sul dataset.
Conclusione
Screaming Frog SEO Spider è molto più di un programma per trovare link rotti.
Usato bene, permette di trasformare la struttura tecnica di un sito in dati interrogabili: URL, redirect, canonical, link interni, rendering JavaScript, contenuti, sitemap, segnali di indicizzabilità e informazioni provenienti da strumenti esterni possono essere analizzati nello stesso workflow.
La versione gratuita è più che sufficiente per imparare il funzionamento del crawler e analizzare siti piccoli entro il limite di 500 URL. La licenza diventa interessante quando servono scala, rendering JavaScript, automazione, confronti nel tempo, integrazioni, analisi semantiche e funzioni avanzate come MCP.
Il limite da ricordare è semplice: Screaming Frog può mostrarti con precisione cosa ha trovato il suo crawler; non può trasformare automaticamente quel dato nella decisione SEO corretta.
Il workflow migliore resta quindi quello che parte da una domanda concreta, configura la scansione di conseguenza, verifica le anomalie e assegna le priorità in base al loro impatto reale. È in quel passaggio, tra dato e decisione, che un crawl diventa finalmente un audit SEO.