
Gemini AI è la famiglia di modelli di intelligenza artificiale sviluppata da Google DeepMind, ma il nome Gemini viene utilizzato anche per l’assistente di Google e per diversi servizi che sfruttano questi modelli. È una distinzione importante: il modello che elabora una richiesta, l’app con cui interagisci e la piattaforma usata dagli sviluppatori non sono la stessa cosa.
La famiglia Gemini è progettata per lavorare con più tipi di informazione, tra cui testo, immagini, audio, video, codice e documenti. Nelle generazioni più recenti Google ha inoltre sviluppato capacità di reasoning, uso di strumenti esterni, function calling e workflow agentici.
Questa guida chiarisce cosa significa realmente Gemini AI, quali modelli esistono oggi, come funzionano e dove possono essere utilizzati. Se invece vuoi accedere all’assistente, capire cosa puoi fare gratuitamente o imparare a usarlo nella pratica, trovi tutto nella nostra guida completa a Google Gemini.
Gemini AI non è una sola cosa: modelli, app e servizi Google
Quando leggi “Gemini” puoi trovarti davanti a concetti diversi. Il problema è che vengono spesso usati come sinonimi, anche quando indicano livelli differenti dello stesso ecosistema.
La distinzione più semplice è questa:
Gemini AI → famiglia di modelli → singoli modelli Gemini → API e piattaforme che li espongono → prodotti e applicazioni che li utilizzano.
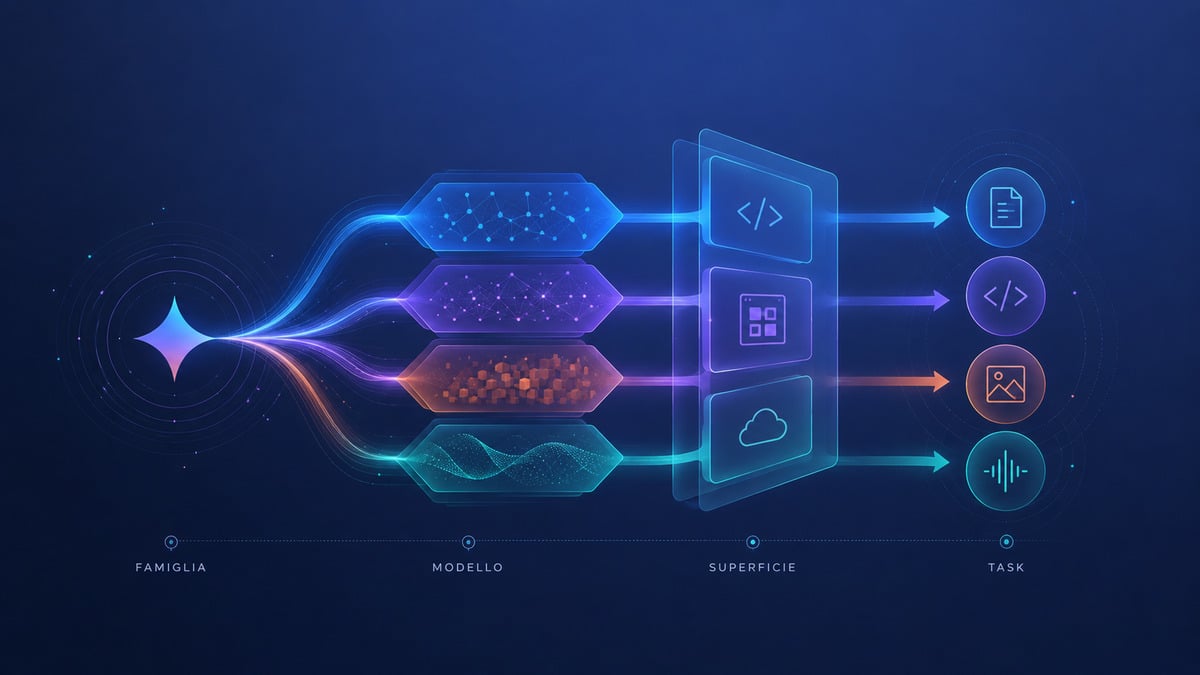
L’app Gemini è quindi un prodotto costruito sopra i modelli Gemini. Non coincide con la famiglia di modelli e non permette necessariamente di scegliere ogni modello disponibile attraverso le API.
Cosa significa “Gemini” oggi
Gemini nasce come famiglia di modelli multimodali di Google DeepMind e si è progressivamente trasformato in uno dei nomi centrali dell’ecosistema AI di Google.
Dal punto di vista tecnico, conviene pensare a Gemini prima di tutto come a una famiglia di foundation model generativi. I modelli ricevono un input, lo elaborano all’interno del contesto disponibile e producono un output in base al task richiesto.
Molti appartengono alla categoria dei Large Language Model, anche se la definizione di semplice “modello linguistico” è ormai limitante per sistemi capaci di lavorare nativamente con immagini, audio, video, codice e strumenti esterni.
È inoltre utile distinguere il modello dal sistema che gli viene costruito intorno. Un’applicazione basata su Gemini può aggiungere ricerca sul web, memoria del contesto, accesso a file, strumenti, database, API o altre applicazioni. Non tutte queste capacità appartengono al modello in sé.
Differenza tra famiglia di modelli e app Gemini
L’app Gemini di Google è l’interfaccia consumer attraverso cui puoi conversare con l’assistente e usare funzionalità come analisi dei file, Deep Research, Gemini Live, Canvas, Gems o strumenti di generazione.
La Gemini API è invece pensata per chi deve integrare i modelli all’interno di software, servizi e workflow propri.
La conseguenza pratica è importante: non puoi dedurre automaticamente il modello disponibile nell’app leggendo l’elenco dei modelli esposti dalla Gemini API.
Un modello può essere:
- disponibile stabilmente tramite API;
- presente soltanto in preview;
- utilizzato in una specifica funzione dell’app;
- disponibile solo con determinati piani o in determinate aree;
- sostituito da una versione successiva su una piattaforma ma ancora utilizzabile su un’altra.
Per questo, quando qualcuno dice semplicemente “sto usando Gemini”, la domanda successiva dovrebbe essere: quale prodotto e quale modello?
Da Bard e Gemini 1.0 alla generazione 3.x
L’evoluzione del nome ha contribuito alla confusione.
Google aveva inizialmente lanciato il proprio chatbot generativo con il nome Bard. Nel 2024 Bard è stato rinominato Gemini, avvicinando il nome dell’assistente a quello della famiglia di modelli che lo alimenta. Se vuoi ricostruire questo passaggio, abbiamo mantenuto un approfondimento dedicato a Google Bard e alla sua evoluzione verso Gemini.
Nel frattempo anche i modelli sono cambiati rapidamente: Gemini 1.x è stato seguito dalle generazioni 2.x e poi dalla famiglia 3.x.
È uno dei motivi per cui non conviene identificare Gemini con un singolo numero di versione. Gemini è la famiglia; 3.7 Flash, 3.1 Pro o 3.5 Flash-Lite sono specifici modelli all’interno dell’ecosistema.
Quali modelli Gemini sono disponibili oggi
Ad agosto 2026 l’inventario ufficiale della Gemini API comprende diversi modelli della generazione Gemini 3, affiancati da modelli specializzati.
Non tutti hanno lo stesso scopo e, soprattutto, non tutti hanno lo stesso stato di disponibilità.
| Modello | Stato nella Gemini API | Ruolo principale |
|---|---|---|
| Gemini 3.7 Flash | Stable | coding, agenti e workflow complessi |
| Gemini 3.6 Flash | Stable | modello Flash general purpose della generazione precedente |
| Gemini 3.5 Flash | Stable | modello Flash precedente, ancora disponibile |
| Gemini 3.5 Flash-Lite | Stable | alta efficienza e grandi volumi |
| Gemini 3.1 Flash-Lite | Stable | workload leggeri, con successore già disponibile |
| Gemini 3.1 Pro | Preview | reasoning e task multimodali complessi |
| Nano Banana 2 / modelli Gemini Image | Stable o specifico per versione | generazione e modifica di immagini |
| Gemini Live | dipende dall’endpoint | interazioni real-time audio/visive |
| Gemini Embedding | specifico | rappresentazioni vettoriali ed embedding |
Questa tabella fotografa lo stato attuale, non una gerarchia assoluta di qualità. Un modello più recente o più potente in alcuni benchmark non è automaticamente la scelta migliore per ogni applicazione.
Flash: velocità, scala e workflow agentici
La linea Flash è diventata molto più importante rispetto alle prime generazioni Gemini.
Gemini 3.7 Flash, rilasciato in disponibilità generale il 13 agosto 2026, è attualmente il Flash più recente della Gemini API. Google lo posiziona soprattutto per coding, workflow agentici e operazioni multi-step.
La sua scheda tecnica ufficiale indica input multimodali — testo, immagini, video, audio e PDF — un context window superiore al milione di token e supporto per strumenti come function calling, grounding con Google Search, code execution, File Search e URL Context.
Qui c’è una distinzione utile: Flash non significa più automaticamente “modello semplice e veloce”. Le generazioni recenti hanno spostato la linea verso task che richiedono pianificazione, uso di tool e ragionamento multi-step.
Gemini 3.6 Flash e 3.5 Flash restano disponibili, ma 3.7 è il punto di riferimento più recente della linea.
Flash-Lite: efficienza per grandi volumi
La famiglia Flash-Lite privilegia un altro compromesso.
L’obiettivo non è massimizzare la capacità su ogni singola richiesta, ma ridurre latenza e costo quando devi eseguire grandi quantità di operazioni relativamente contenute.
Un modello di questo tipo può avere più senso per:
- classificazioni;
- estrazione strutturata;
- elaborazioni ripetitive;
- sub-agent specializzati;
- grandi pipeline di automazione;
- task semplici eseguiti ad alta frequenza.
Gemini 3.5 Flash-Lite è il modello più recente di questa linea fra quelli stabili attualmente documentati.
Il punto non è quindi “Flash-Lite è peggiore di Flash”, ma quanto modello serve davvero al task. Usare sempre l’opzione più pesante può aumentare costo e latenza senza migliorare materialmente il risultato.
Pro e Deep Think per compiti complessi
La denominazione Pro continua a essere associata ai task in cui conta maggiormente la capacità di affrontare problemi complessi.
Al momento della verifica, Gemini 3.1 Pro è indicato come Preview nella Gemini API. Questo dettaglio non è secondario: un modello preview può essere utilizzabile, ma offre garanzie di stabilità e lifecycle differenti rispetto a un endpoint stable.
Google DeepMind presenta inoltre Gemini 3.1 Deep Think come soluzione orientata a problemi avanzati in aree come scienza, ricerca e ingegneria.
Non bisogna però confondere Deep Think con una semplice variante da scegliere automaticamente al posto di Flash. Disponibilità, superficie, limiti e modalità d’accesso possono essere differenti.
Per un progetto reale la scelta va fatta confrontando almeno qualità dell’output, latenza, costo, stabilità dell’endpoint e capacità necessarie.
Modelli specializzati oltre testo e chat
L’ecosistema Gemini non si ferma ai modelli che generano risposte testuali.
Google include oggi modelli e componenti dedicati a:
- generazione e modifica delle immagini;
- conversazioni vocali in tempo reale;
- embedding;
- elaborazione multimodale;
- uso del computer;
- tool calling;
- workflow agentici.
I modelli Nano Banana, per esempio, appartengono alla parte dell’ecosistema dedicata alla generazione e modifica visuale, mentre la Live API utilizza modelli progettati per interazioni a bassa latenza con audio e input continui.
Questo è un altro motivo per cui una lista generica “Pro, Flash e Flash-Lite” non descrive più correttamente Gemini.
Gemini 2.5: cosa resta e perché il lifecycle conta
Gemini 2.5 è stato per molto tempo il centro dell’offerta Google, ma nel 2026 va ormai letto nel contesto della migrazione verso Gemini 3.
Qui bisogna evitare una semplificazione.
La pagina delle deprecazioni della Gemini API non indica ancora, alla data di questo aggiornamento, una data generale di spegnimento per gli endpoint Gemini 2.5 Pro, 2.5 Flash e 2.5 Flash-Lite.
Nell’ambiente cloud/enterprise la situazione è diversa: Google ha annunciato per i corrispondenti modelli su Vertex AI una retirement date del 16 ottobre 2026.
Quindi non è corretto scrivere semplicemente “Gemini 2.5 chiude il 16 ottobre” senza specificare la piattaforma.
La lezione pratica è più importante della singola data: con un servizio AI il lifecycle dell’endpoint fa parte della scelta tecnica. Se costruisci un’applicazione su un modello, devi sapere non solo cosa sa fare oggi, ma anche quanto è stabile e quale percorso di migrazione prevede il provider.
Come funzionano i modelli Gemini
Gemini appartiene alla stessa grande famiglia tecnologica degli attuali modelli generativi: riceve un input, lo trasforma in rappresentazioni elaborabili dal modello e genera progressivamente l’output sulla base del contesto disponibile.
Questo processo non equivale a cercare una risposta già memorizzata in un database.
Durante l’addestramento i parametri del modello vengono ottimizzati per riconoscere relazioni e pattern nei dati. Durante l’utilizzo, invece, il modello esegue un processo di inferenza: utilizza ciò che ha appreso, il prompt, il contesto disponibile ed eventuali strumenti esterni per produrre una risposta.
Se vuoi approfondire questo meccanismo, nella nostra guida sul machine learning spieghiamo la relazione fra addestramento, modelli e inferenza.
Multimodalità: testo, immagini, audio, video e codice
Una delle caratteristiche strutturali di Gemini è la multimodalità.
Un sistema multimodale non è limitato a una sola forma di input. A seconda del modello e dell’endpoint può ricevere, per esempio, testo insieme a immagini, video, audio o PDF.
Immagina di dover analizzare un report aziendale composto da una relazione testuale, grafici, tabelle e alcune pagine scannerizzate. Un modello multimodale può utilizzare questi elementi all’interno della stessa richiesta invece di obbligarti a trasformare tutto preventivamente in testo.
Questo non significa che ogni modalità sia gestita allo stesso modo o con la stessa affidabilità. Il supporto effettivo dipende dal modello, ed è sempre meglio controllare la relativa model card prima di progettare il workflow.
La multimodalità è quindi una capacità dell’architettura e dell’interfaccia del modello, non la promessa che ogni input venga interpretato senza errori.
Reasoning e thinking: cosa succede realmente
Nella documentazione Gemini moderna compare frequentemente il concetto di thinking.
Non va interpretato come prova che il modello pensi nello stesso modo di una persona. Dal punto di vista operativo indica la possibilità di dedicare più risorse di inferenza alla costruzione e verifica della risposta prima dell’output finale.
Gemini 3.7 Flash, per esempio, permette agli sviluppatori di impostare diversi livelli di thinking. Un livello più elevato può essere utile quando il task richiede pianificazione, matematica, coding complesso o più chiamate a strumenti.
Il compromesso è intuitivo:
più lavoro di inferenza → potenzialmente migliore gestione di alcuni problemi complessi → maggiore latenza e consumo di token.
Questo spiega perché non ha senso utilizzare sempre il livello massimo. Per un semplice task di estrazione o classificazione, il costo aggiuntivo può non produrre un beneficio utile.
Contesto, grounding e uso degli strumenti
Il context window determina quanta informazione un modello può prendere in considerazione nella singola interazione o nel flusso previsto dall’API.
Per Gemini 3.7 Flash Google documenta un limite di input superiore a un milione di token. È una capacità importante per documenti estesi, repository di codice, conversazioni lunghe o analisi multimodali complesse.
Ma grande context window non significa memoria infinita né conoscenza sempre aggiornata.
Per lavorare con informazioni esterne o correnti, Gemini può essere collegato a strumenti. La documentazione della Gemini API include, fra gli altri:
- Grounding con Google Search;
- URL Context;
- Code Execution;
- File Search;
- Function Calling;
- Grounding con Google Maps;
- Computer Use, dove supportato.
Il function calling è particolarmente importante per i sistemi agentici: il modello non esegue magicamente un’operazione esterna, ma può determinare quando è necessario invocare una funzione e generare i parametri necessari. L’applicazione esegue quindi l’azione e restituisce il risultato al modello.
È la differenza fra generare una risposta e partecipare a un workflow che può consultare dati o compiere azioni reali.
Perché Gemini non “impara da te” dopo ogni conversazione
Un equivoco frequente è immaginare che il modello modifichi progressivamente i propri parametri ogni volta che parli con lui.
Non è così.
Il modello può utilizzare il contesto della conversazione e il prodotto può aggiungere meccanismi di personalizzazione, memoria, cronologia o informazioni provenienti da servizi collegati. Ma questo non equivale all’aggiornamento in tempo reale dei pesi del modello sulla base della tua singola chat.
Conviene separare tre concetti:
contesto della conversazione ≠ personalizzazione del prodotto ≠ addestramento del modello.
Questa differenza è importante anche per capire la privacy. Le modalità con cui Google conserva o utilizza le interazioni dipendono dal prodotto, dal tipo di account e dalle impostazioni applicabili; non vanno dedotte dal semplice fatto che il modello sembri ricordare qualcosa.
Dove si possono usare i modelli Gemini
Conoscere il nome del modello serve poco se non sai attraverso quale superficie puoi utilizzarlo.
Per un utente consumer il punto d’ingresso naturale è l’app Gemini. Per uno sviluppatore possono essere più appropriati Google AI Studio e Gemini API. Per implementazioni aziendali entrano invece in gioco le piattaforme cloud e gli strumenti di governance.
Gemini API e Google AI Studio
Google AI Studio è l’ambiente più immediato per provare i modelli, sperimentare con prompt e configurazioni e passare poi al codice.
Puoi selezionare un modello, testare input differenti, modificare impostazioni e abilitare strumenti supportati. Quando il comportamento è quello desiderato, AI Studio consente di ottenere il codice necessario per proseguire attraverso la Gemini API.
La Gemini API rappresenta invece il livello di integrazione programmatica.
In pratica:
AI Studio → prova e prototipa
Gemini API → integra il modello nella tua applicazione
È una distinzione utile soprattutto se stai valutando Gemini per chatbot personalizzati, elaborazione documentale, automazioni, applicazioni multimodali o agenti.
Gemini Enterprise Agent Platform e ambienti enterprise
Per progetti aziendali complessi Google offre oggi Gemini Enterprise Agent Platform, evoluzione e rebranding dell’ambiente precedentemente conosciuto come Vertex AI.
La piattaforma enterprise di Google Cloud aggiunge al semplice accesso ai modelli strumenti per sviluppo, deployment, gestione dei dati, valutazione, personalizzazione e costruzione di agenti.
La differenza rispetto alla Gemini API non è quindi soltanto “più potenza”.
Entrano in gioco esigenze differenti: identità e accessi, governance, integrazione con dati cloud, deployment, osservabilità, valutazione e gestione di workload di produzione.
Per un piccolo prototipo tutto questo può essere superfluo. Per un’applicazione aziendale che deve gestire dati, permessi e deployment controllato può diventare invece determinante.
Perché app Gemini e API possono offrire modelli diversi
L’app Gemini è un prodotto, non un semplice frontend universale della Gemini API.
Google decide quali modelli utilizzare nelle diverse funzioni dell’app, quali rendere selezionabili e quali associare a specifici piani o strumenti.
Al momento di questo aggiornamento, per esempio, la pagina consumer dell’app indica Gemini 3.6 Flash come modello disponibile per l’uso quotidiano e accesso variabile a 3.1 Pro. Il più recente 3.7 Flash è disponibile anche in alcune esperienze specifiche, come Gemini Spark, ma questo non significa che ogni conversazione standard nell’app utilizzi automaticamente 3.7 Flash.
È quindi perfettamente possibile che:
ultimo modello disponibile via API ≠ modello predefinito dell’app Gemini.
Se il tuo obiettivo è usare l’assistente e non sviluppare un’applicazione, la distinzione fra endpoint interessa relativamente. In quel caso ti conviene partire dalla guida pratica a Google Gemini anziché dall’inventario developer.
Come scegliere un modello Gemini
La scelta corretta non parte dal nome più recente. Parte dal task.
Prima di selezionare un modello chiediti cosa stai ottimizzando: qualità, latenza, costo, stabilità dell’endpoint, capacità multimodali, dimensione del contesto o accesso a strumenti.
Solo dopo ha senso confrontare i modelli.
Lo stesso principio vale quando il confronto esce dall’ecosistema Gemini. Prima definisci il task, poi stabilisci se ti serve un assistente generalista oppure un prodotto specializzato. Se devi confrontare anche ChatGPT, Claude, Perplexity, tool creativi, coding assistant e piattaforme di automazione, trovi una selezione ragionata degli AI tools per ogni attività.
Quando conta soprattutto il reasoning
Task come analisi complesse, pianificazione, problem solving, interpretazione di molti vincoli e alcuni workflow di coding possono beneficiare di una maggiore capacità di reasoning.
In questi casi puoi confrontare un Flash recente come 3.7 con un modello Pro disponibile, senza dare per scontato che la parola “Pro” renda automaticamente migliore ogni risultato.
Il modo corretto di decidere è testare lo stesso dataset o gli stessi task reali e misurare:
qualità utile → consistenza → latenza → costo → stabilità operativa.
Un benchmark generale può orientarti, ma non sostituisce la valutazione sul tuo caso d’uso.
Quando contano velocità, latenza e grandi volumi
Se devi classificare migliaia di elementi, estrarre campi da documenti semplici o usare molti sub-agent, la qualità massima sul singolo prompt potrebbe non essere il fattore dominante.
Qui i modelli Flash-Lite diventano interessanti perché sono progettati proprio per workload sensibili a costo, latenza e throughput.
Un esempio concreto è una pipeline che riceve migliaia di ticket e deve identificarne categoria, urgenza e reparto di destinazione.
Non serve necessariamente utilizzare il modello più costoso per ogni ticket. Puoi riservare un modello più capace ai casi ambigui e affidare il lavoro ordinario a un modello più efficiente.
Questa architettura spesso è più razionale del “un modello per tutto”.
Coding, agenti e tool use
Un agente deve fare qualcosa di più che produrre una frase plausibile.
Può dover leggere dati, scegliere uno strumento, invocare una funzione, interpretarne il risultato e decidere il passo successivo.
Gemini 3.7 Flash è esplicitamente orientato da Google a coding e agentic workflow e supporta function calling e diversi built-in tool.
Questo non rende automaticamente un’applicazione autonoma o affidabile.
Il modello è soltanto uno dei componenti. Per un sistema agentico serio servono anche:
- permessi;
- validazione degli input;
- controllo degli output;
- gestione degli errori;
- limiti alle azioni;
- osservabilità;
- conferma umana dove necessaria.
Un agente capace di chiamare un’API ha una superficie di rischio molto diversa da un chatbot che produce soltanto testo.
Quando serve un modello specializzato
Non tutti i task dovrebbero essere inviati a un modello general purpose.
Se devi generare immagini, produrre embedding o costruire un’interazione vocale real-time, la soluzione più appropriata può essere un modello specializzato.
La domanda diventa quindi:
“Qual è il modello Gemini migliore?”
non ha una risposta utile senza completarla con:
“per quale task, su quale piattaforma e con quali vincoli?”
È questa la logica con cui conviene leggere l’intero catalogo Gemini.
Limiti dei modelli Gemini e aspetti da controllare
Le capacità dei modelli Gemini sono ampie, ma questo non rende l’output automaticamente corretto.
Google stessa documenta limitazioni tipiche dei foundation model, comprese le hallucination, cioè risposte che possono risultare convincenti pur contenendo informazioni inesatte o inventate.
Un buon workflow deve quindi essere progettato anche attorno agli errori del modello, non soltanto alle sue capacità.
Errori, hallucination e necessità di verifica
Gemini può produrre informazioni fattualmente errate.
Questo vale anche per modelli recenti e non viene eliminato semplicemente aumentando il reasoning.
Per task informativi puoi ridurre parte del rischio collegando il modello a fonti verificabili. Il grounding con Google Search, per esempio, permette ai modelli supportati di utilizzare informazioni web aggiornate e fornire riferimenti alle fonti.
Non equivale però a una garanzia di correttezza.
Per dati critici, numeri, citazioni, decisioni economiche, sicurezza, salute o altre situazioni ad alto impatto, l’output del modello non dovrebbe essere considerato una fonte primaria.
La regola pratica è semplice: più è alto il costo di un errore, più deve essere forte il livello di verifica esterna.
Stable, preview ed experimental non significano la stessa cosa
La documentazione Gemini distingue versioni stable, preview, latest ed experimental.
Un endpoint stable punta a una versione specifica progettata per utilizzo stabile. Un endpoint preview può avere condizioni, rate limit e lifecycle differenti. Gli alias “latest”, invece, possono cambiare il modello sottostante nel tempo.
Per un esperimento questa differenza può sembrare secondaria.
In produzione diventa importante.
Se il comportamento della tua applicazione dipende da uno specifico output, cambiare silenziosamente la versione del modello può modificare qualità, formato delle risposte, compatibilità con alcuni parametri o costo.
Per questo, nei sistemi di produzione, conviene trattare versione del modello e migrazione come dipendenze software, non come dettagli editoriali.
Lifecycle e versioni: perché un modello può diventare legacy rapidamente
L’evoluzione Gemini del 2026 lo mostra bene.
In pochi mesi Google ha introdotto più generazioni Flash, nuovi modelli Lite, endpoint specializzati e nuove modalità di reasoning.
Questo comporta un costo di manutenzione.
Se stai sviluppando sopra Gemini devi prevedere:
- monitoraggio delle deprecazioni;
- test delle nuove versioni;
- aggiornamento degli endpoint;
- regressioni possibili;
- variazioni di prezzo;
- cambiamenti nei parametri supportati.
La qualità di un modello oggi non basta quindi a definirne l’idoneità per un progetto di lungo periodo.
Conta anche quanto è prevedibile il percorso di aggiornamento.
Privacy e gestione dei dati dipendono dal prodotto utilizzato
Un altro errore è parlare di “privacy di Gemini” come se esistesse una sola modalità di trattamento.
L’app consumer, gli account Workspace, Google AI Studio, Gemini API e l’ambiente cloud possono essere soggetti a impostazioni e condizioni differenti.
Nel Privacy Hub dell’app Gemini, Google spiega per esempio come vengono gestite attività, conversazioni e relative impostazioni per gli account personali.
Questo non va automaticamente trasferito a un deployment aziendale attraverso API.
Prima di utilizzare Gemini con dati riservati devi quindi controllare la documentazione della specifica superficie che stai usando, il tipo di account, le impostazioni di retention e i termini applicabili.
Scrivere semplicemente “Gemini è conforme al GDPR, quindi è sicuro per qualsiasi dato” non sarebbe una conclusione corretta.
La conformità normativa, la sicurezza tecnica e l’adeguatezza del trattamento per uno specifico dato sono questioni collegate, ma non equivalenti.
Gemini AI e l’app Google Gemini: quale approfondimento leggere
A questo punto la distinzione dovrebbe essere più chiara.
Se vuoi capire che cos’è la tecnologia Gemini, come si differenziano i modelli, cosa significano Flash, Pro o Flash-Lite e perché API e app possono mostrare inventari diversi, questa è la guida di riferimento.
Se invece il tuo obiettivo è:
- aprire Gemini;
- capire come usarlo;
- conoscere le funzioni dell’assistente;
- verificare cosa è disponibile gratuitamente;
- confrontare i piani;
- usare Deep Research, Live, Canvas o Gems;
- lavorare con gli strumenti Google;
passa alla nostra guida su come usare Google Gemini.
Separare i due livelli evita anche un errore pratico: scegliere un piano consumer pensando di acquistare direttamente l’accesso a qualsiasi endpoint della Gemini API, oppure leggere la documentazione developer aspettandosi di trovare le stesse funzioni e gli stessi limiti dell’app.
Sono prodotti collegati, non equivalenti.
Conclusione
Capire Gemini AI richiede soprattutto di smettere di trattare Gemini come un unico prodotto.
Il modello mentale più utile è:
famiglia Gemini → specifico modello → stato della versione → piattaforma che lo espone → strumenti disponibili → task da risolvere.
Con questa distinzione diventa più semplice interpretare anche i continui aggiornamenti di Google. Gemini 3.7 Flash non “sostituisce Gemini” nel suo complesso: è un nuovo modello della famiglia, particolarmente orientato a coding e workflow agentici. Flash-Lite continua ad avere senso quando contano efficienza e volume; Pro e le modalità di reasoning avanzate rispondono ad altri scenari; i modelli specializzati servono compiti ancora differenti.
La scelta migliore, quindi, non consiste nel cercare il nome con il numero più alto. Consiste nel partire dal problema, scegliere la superficie corretta e verificare quale modello offre il compromesso più adatto fra capacità, costo, latenza e stabilità.
E se quello che cerchi non è un modello da integrare ma l’assistente da usare ogni giorno, il livello successivo non è la documentazione API: è l’app Google Gemini e il suo funzionamento concreto.