

Il TTFB, acronimo di Time to First Byte, misura quanto tempo passa dall’inizio della navigazione fino al momento in cui il browser riceve il primo byte della risposta.
È una metrica utile perché fotografa tutto ciò che accade prima che il browser possa iniziare a lavorare sul documento HTML. Un valore elevato può dipendere dal server, ma non solo: entrano in gioco redirect, rete, DNS, connessione, TLS, cache, CDN e tempo necessario al backend per generare la risposta.
Qui c’è quindi una distinzione importante: TTFB non significa semplicemente “tempo di risposta del server”.
La documentazione web.dev dedicata al Time to First Byte indica 0,8 secondi o meno come riferimento generale per un buon TTFB, mentre valori superiori a 1,8 secondi vengono considerati scarsi. Sono però soglie orientative, non un requisito SEO universale da inseguire a qualsiasi costo.
Allo stesso modo, il TTFB non è un Core Web Vital e Google non lo documenta come ranking factor autonomo. Può però consumare una parte importante del tempo disponibile prima di metriche di caricamento come FCP e LCP, oltre a segnalare problemi infrastrutturali che meritano una diagnosi.
Vediamo quindi cosa misura realmente, quali valori hanno senso, come testarlo e soprattutto come capire dove nasce un TTFB alto prima di iniziare a cambiare hosting, plugin o configurazioni alla cieca.
Cos’è il TTFB e cosa misura davvero
Il Time to First Byte rappresenta l’intervallo che precede la ricezione iniziale della risposta a una richiesta di navigazione.
In una rappresentazione semplificata il percorso è:
utente → eventuali redirect → DNS → connessione → TLS → richiesta HTTP → elaborazione/cache → primo byte della risposta
Questo spiega perché attribuire automaticamente un TTFB elevato all’hosting può portare alla diagnosi sbagliata.
Chrome UX Report chiarisce infatti che il TTFB rilevato sul campo non è una misura pura della velocità del server: può includere passaggi precedenti e può cambiare a seconda che la risposta arrivi dall’origine, da una cache o da una CDN.
Le fasi che compongono il Time to First Byte
Quando inserisci un URL nel browser o fai clic su un collegamento, prima che compaia il contenuto possono accadere diverse cose.
Se l’URL iniziale effettua un redirect, il browser deve ricevere quella risposta e avviare un’altra richiesta. Se deve risolvere il dominio, entra in gioco il DNS. Una nuova connessione HTTPS richiede inoltre l’apertura della connessione e la negoziazione TLS.
Solo successivamente la richiesta raggiunge l’infrastruttura che deve decidere come rispondere.
Per una pagina statica potrebbe esserci pochissimo lavoro da fare. Una pagina WordPress non memorizzata in cache può invece richiedere esecuzione di PHP, caricamento del CMS, plugin, query al database, template e altri processi prima che l’HTML inizi a essere restituito.
A questo si aggiunge la distanza fisica e di rete fra client e server.
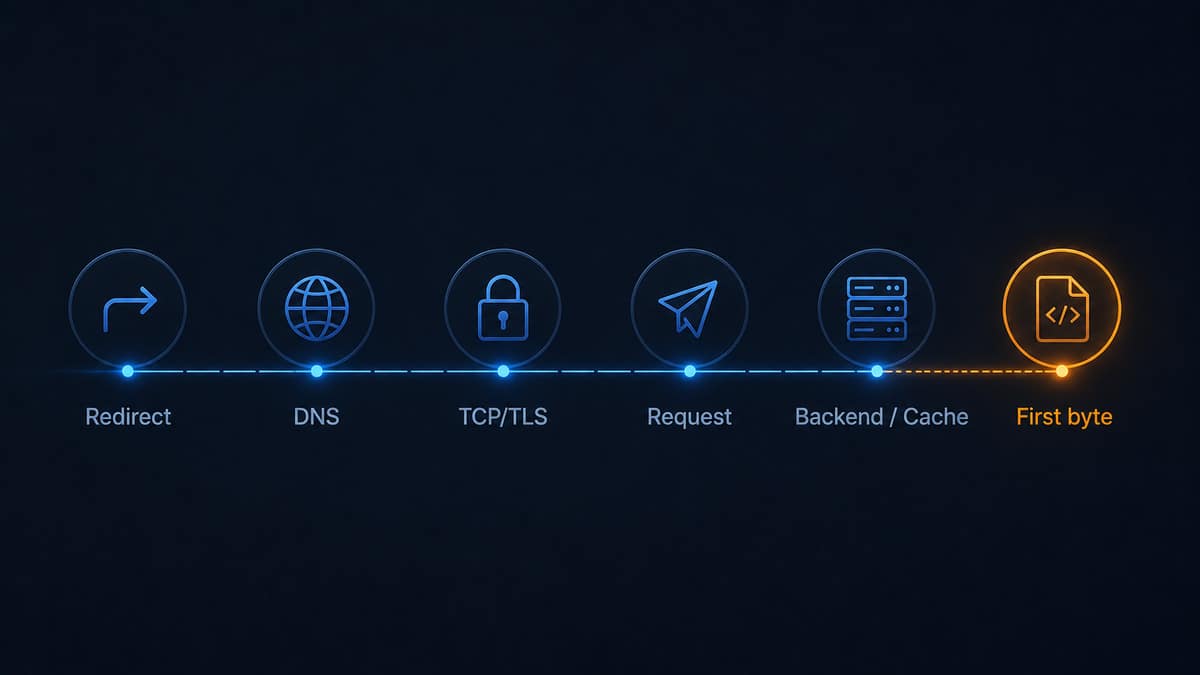
Per questo due utenti che aprono la stessa pagina possono sperimentare TTFB differenti anche quando il codice del sito non è cambiato.
Perché TTFB non significa semplicemente “velocità del server”
Il tempo di elaborazione server è solo una componente del TTFB.
Chrome, per esempio, distingue il TTFB complessivo dalla latenza della richiesta del documento e dai tempi specifici del backend. La documentazione Lighthouse sottolinea che il tempo di risposta del server rappresenta solo una parte della metrica completa, che può comprendere anche redirect e attività di rete precedenti.
Questa differenza diventa essenziale quando devi ottimizzare.
Se il backend genera l’HTML in 100 ms ma l’utente arriva da molto lontano e attraversa diversi redirect, cambiare plugin WordPress potrebbe non produrre alcun risultato rilevante.
Se invece il collegamento di rete è rapido ma WordPress impiega un secondo e mezzo per generare una pagina non presente in cache, il problema è molto più vicino all’applicazione o all’infrastruttura server.
Il TTFB ti dice quindi che c’è attesa prima della risposta. La fase successiva consiste nel capire dove si trova quell’attesa.
Qual è un buon valore TTFB
Come riferimento pratico, web.dev utilizza questa classificazione:
| TTFB | Interpretazione |
|---|---|
| ≤ 0,8 s | Buono |
| 0,8–1,8 s | Da migliorare |
| > 1,8 s | Scarso |
Questa tabella va letta come una guida diagnostica, non come una soglia SEO assoluta.
Un TTFB di 300 ms può essere ottimo in uno scenario e lasciare comunque spazio a un problema in un altro. Allo stesso modo, una pagina server-rendered con un valore leggermente superiore può ottenere risultati migliori su FCP e LCP rispetto a un’applicazione che restituisce subito un HTML minimo ma richiede molto lavoro JavaScript prima di mostrare contenuto significativo.
Le soglie 0,8 e 1,8 secondi e il 75° percentile
Quando analizzi dati reali non guardare soltanto il test effettuato dal tuo computer.
Il Chrome UX Report lavora con distribuzioni di esperienze realmente raccolte e, negli strumenti che espongono questi dati, il 75° percentile è particolarmente utile: indica un valore entro il quale rientra il 75% delle esperienze osservate.
La documentazione Chrome relativa ai dati CrUX mostrati da PageSpeed Insights conferma l’utilizzo del 75° percentile per le metriche presentate.
In pratica, se un test dal tuo ufficio mostra 250 ms ma gli utenti mobile in una determinata area geografica sperimentano valori molto superiori, il singolo risultato di laboratorio non descrive l’esperienza complessiva.
È uno dei motivi per cui field data e lab data devono essere usati insieme, non messi in competizione.
Perché 200 ms non è una soglia universale di Google
Per anni molte guide hanno indicato 200 ms come confine rigido fra un TTFB buono e uno problematico.
Oggi non è corretto presentarlo come soglia universale Google.
La guidance corrente di web.dev usa circa 800 ms come riferimento generale e specifica esplicitamente che il numero deve essere contestualizzato rispetto al modo in cui il sito distribuisce il proprio contenuto.
Questo non significa che arrivare a 150 o 200 ms sia inutile. Se riesci a ottenere un TTFB stabile molto basso senza introdurre compromessi, è naturalmente positivo.
Il problema nasce quando trasformi il numero in un obiettivo fine a sé stesso.
Ottimizzare da 1.500 a 500 ms può cambiare materialmente il caricamento. Passare da 250 a 180 ms potrebbe invece avere un valore marginale rispetto a un LCP lento per un’immagine scoperta in ritardo o a un INP elevato provocato da JavaScript pesante.
La priorità deve nascere dal collo di bottiglia reale.
TTFB, Core Web Vitals e SEO: qual è il rapporto reale
Il TTFB non fa parte dei tre Core Web Vitals.
Le metriche correnti sono LCP, INP e CLS. Se vuoi approfondire il loro significato, le soglie e il modo corretto di interpretarli, trovi la nostra guida aggiornata ai Core Web Vitals.
Google raccomanda buoni Core Web Vitals e spiega che questi segnali, insieme ad altri aspetti della page experience, sono coerenti con ciò che i suoi sistemi di ranking cercano di favorire. Allo stesso tempo, ottenere buoni valori tecnici non garantisce una determinata posizione nei risultati di ricerca.
Il rapporto corretto non è quindi:
TTFB basso → ranking migliore
ma:
TTFB → tempi iniziali del caricamento → possibile effetto su metriche e esperienza → una componente del quadro tecnico complessivo
Come il TTFB entra nel tempo di LCP e FCP
TTFB precede sia First Contentful Paint (FCP) sia Largest Contentful Paint (LCP).
Per mostrare il contenuto principale, il browser deve prima ricevere almeno una parte della risposta. Se questa fase iniziale richiede molto tempo, una porzione del budget temporale disponibile per LCP è già stata consumata prima ancora che l’elemento principale possa essere scoperto, scaricato e renderizzato.
La documentazione Lighthouse scompone infatti LCP in più fasi e considera TTFB una delle componenti iniziali del processo.
Immagina un LCP costituito dalla featured image di una pagina.
Il tempo totale potrebbe dipendere da:
TTFB → ritardo nella scoperta dell’immagine → download dell’immagine → ritardo di rendering
Se TTFB assorbe 1,5 secondi, il resto della pipeline parte già in svantaggio.
Ma se TTFB è 250 ms e il browser scopre l’immagine LCP con enorme ritardo a causa di JavaScript o lazy loading errato, continuare a ottimizzare il server non risolve il problema principale.
È questa relazione che rende TTFB importante nella diagnosi dei Core Web Vitals.
TTFB non è un Core Web Vital né un ranking factor autonomo
Questo è uno dei punti su cui conviene essere precisi.
Google non elenca TTFB fra i Core Web Vitals e non documenta una regola secondo cui una pagina con un TTFB superiore a una determinata soglia viene automaticamente declassata.
La stessa documentazione web.dev specifica che non è indispensabile raggiungere il valore “buono” di TTFB se questo non impedisce alla pagina di ottenere risultati soddisfacenti sulle metriche realmente rilevanti.
Questo elimina due errori comuni:
- un TTFB alto non equivale automaticamente a una penalizzazione;
- ridurre il TTFB non equivale automaticamente a ottenere più ranking.
Resta però una metrica tecnica molto utile. Se è elevata può segnalare un problema che rallenta l’intera pipeline di caricamento, peggiora l’esperienza e rende più difficile raggiungere buoni valori di altre metriche.
Quando una risposta server lenta può ridurre il crawling di Googlebot
Il rapporto fra velocità del server e crawling esiste, ma va contestualizzato.
La documentazione Google aggiornata sul crawl budget spiega che la capacità di crawling può diminuire quando un sito rallenta, aumenta la latenza, mantiene più a lungo aperte le connessioni o restituisce errori e segnali di rate limiting. Google cita espressamente anche Time to First Byte fra i parametri che contribuiscono alla valutazione della salute del crawling.
Non significa però che un piccolo blog con qualche centinaio di URL debba ossessionarsi con il crawl budget.
Google precisa che questa documentazione avanzata è rivolta soprattutto a siti molto grandi, siti con migliaia di URL aggiornati rapidamente o proprietà con molte pagine “Scoperta, attualmente non indicizzata”.
Per la maggior parte dei siti WordPress normali, la ragione principale per correggere un TTFB problematico resta la qualità tecnica e l’esperienza di caricamento, non l’idea di “far correre Googlebot”.
Come misurare correttamente il TTFB
Il modo peggiore di valutare il Time to First Byte è eseguire un solo test, vedere un numero e considerarlo definitivo.
Il risultato cambia in funzione di posizione geografica, rete, cache, CDN, carico server, URL richiesto e condizioni del test.
Una misurazione utile parte quindi dalla distinzione fra esperienza reale e test controllato.
Field data e lab data misurano scenari diversi
I field data provengono da utenti reali e incorporano la variabilità del mondo reale: dispositivi, connessioni, località, cache, redirect e infrastruttura.
I lab data sono invece misurazioni effettuate in condizioni definite. Sono fondamentali per riprodurre un problema, modificare una configurazione e verificare immediatamente l’effetto.
In sintesi:
| Tipo | Utile per |
|---|---|
| Field data | Capire cosa sperimentano realmente gli utenti |
| Lab data | Diagnosticare e riprodurre un collo di bottiglia |
| Entrambi | Verificare se una modifica tecnica risolve anche il problema reale |
Non stupirti quindi se CrUX mostra un dato diverso dal test che esegui in Chrome dal tuo computer.
Non stanno necessariamente misurando male: stanno osservando contesti diversi.
PageSpeed Insights e CrUX
PageSpeed Insights è un buon punto di partenza perché permette di avvicinare due livelli di analisi: dati sul campo provenienti dal Chrome UX Report quando disponibili e diagnostica di laboratorio.
TTFB non va però confuso con il Performance Score.
Un punteggio complessivo può cambiare anche se il backend è rimasto identico, mentre il TTFB può essere alto in un sottoinsieme di utenti e non emergere allo stesso modo da un singolo test.
Quando sono disponibili dati CrUX, guarda quindi distribuzione, dispositivo, periodo e contesto prima di formulare una diagnosi.
Chrome DevTools, Lighthouse e WebPageTest
Per capire cosa succede durante una singola richiesta, Chrome DevTools è particolarmente utile.
Nel pannello Network puoi selezionare la richiesta del documento HTML e controllare la voce Waiting (TTFB). Chrome la descrive come il tempo che comprende almeno il round trip di rete e il tempo impiegato dal server per preparare la risposta.
Lighthouse e i Performance Insights possono poi evidenziare problemi collegati alla latenza della richiesta del documento, redirect e risposta del server.
WebPageTest aggiunge un livello utile quando vuoi ripetere test da località, dispositivi e condizioni di rete differenti e leggere il waterfall completo.
Il punto non è scegliere “il tool migliore”: è usare lo strumento adatto alla domanda.
CrUX: gli utenti reali hanno un problema?
DevTools/WebPageTest: in quale fase si presenta?
Backend monitoring: cosa sta facendo realmente l’applicazione?
GTmetrix e waterfall della richiesta
Anche GTmetrix può essere utile quando vuoi leggere la sequenza delle richieste e osservare il comportamento del documento iniziale nel contesto dell’intera pagina.
Il waterfall permette soprattutto di evitare un errore frequente: attribuire al TTFB problemi che avvengono dopo la ricezione dell’HTML.
Se il documento arriva rapidamente ma CSS, font, immagini, script o risorse di terze parti introducono secondi di attesa, la priorità non è più il primo byte.
Quando confronti risultati di tool differenti considera inoltre che implementazioni come 103 Early Hints, cache edge e modalità diverse di misurare le risposte possono produrre valori apparentemente discordanti. Web.dev raccomanda proprio per questo di capire che cosa sta misurando lo strumento utilizzato, invece di confrontare numeri isolati come se fossero sempre equivalenti.
Come capire perché il TTFB è alto
Una volta verificato che il problema esiste davvero, la domanda cambia:
dove si accumula il tempo?
È qui che l’ottimizzazione diventa interessante.
Redirect, DNS, TCP/TLS e distanza geografica
Un redirect aggiunge un passaggio.
Se la navigazione attraversa:
http → https → dominio senza www → dominio con www → URL finale
il browser deve effettuare richieste aggiuntive prima di raggiungere il documento corretto.
Web.dev indica esplicitamente le catene di redirect come una delle cause comuni di TTFB elevato.
Controlla quindi che internal link, canonical, sitemap, campagne e URL condivisi puntino direttamente alla destinazione finale quando possibile.
Anche distanza geografica e round-trip time contano.
Se il server origin si trova negli Stati Uniti e la maggior parte degli utenti è in Italia, una parte della latenza deriva semplicemente dal percorso di rete. In questo scenario una CDN può essere molto più pertinente di un intervento sul database.
Backend, database e generazione della pagina
Se la rete non spiega il ritardo, devi guardare ciò che accade sul server.
In WordPress una richiesta dinamica può coinvolgere:
- bootstrap di WordPress;
- tema;
- plugin;
- hook;
- query al database;
- chiamate esterne;
- generazione del template;
- personalizzazioni PHP.
Il problema non è “avere tanti plugin” in senso astratto. Conta cosa fanno durante la richiesta.
Un singolo plugin che esegue query inefficienti o attende un’API remota può pesare più di dieci plugin leggeri che non intervengono nel percorso critico.
È qui che strumenti APM, Query Monitor in ambienti appropriati, log, profiling e misurazioni backend diventano molto più utili di una lista generica di plugin da disattivare.
Cache hit, cache miss e CDN
La cache può modificare drasticamente il percorso della richiesta.
Con una page cache efficace, una pagina già generata può essere restituita senza eseguire nuovamente gran parte di PHP e delle query necessarie a costruirla.
Per questo un test su una pagina “calda” può risultare molto più rapido del primo accesso dopo l’invalidazione della cache.
La nostra guida al caching in WordPress approfondisce le differenze fra i vari livelli di cache.
Questo introduce però un altro problema diagnostico: una cache efficace può nascondere un backend lento.
Web.dev suggerisce, quando serve un’analisi accurata, di distinguere il comportamento della risposta servita dalla cache da quello dell’origine.
Lo stesso vale per la CDN. Se l’HTML viene servito direttamente da un nodo edge vicino all’utente, il percorso è molto diverso rispetto a una richiesta che deve attraversare la CDN, raggiungere l’origine e attendere la generazione dinamica della pagina.
Usare Server-Timing per isolare il collo di bottiglia
Per le diagnosi più tecniche, l’header HTTP Server-Timing è particolarmente utile perché consente all’applicazione di comunicare al browser quanto tempo viene impiegato in specifiche operazioni backend.
Un esempio semplificato potrebbe essere:
Server-Timing: db;dur=85, app;dur=142
In questo caso stai distinguendo il tempo attribuito al database da quello relativo a un’altra fase applicativa.
La guida web.dev all’ottimizzazione del TTFB cita fra gli utilizzi possibili query database, server-side rendering, accesso al disco e hit/miss della cache edge. I valori possono poi essere visualizzati anche negli strumenti di sviluppo di Chrome.
Se non puoi instrumentare l’applicazione con Server-Timing, un sistema di Application Performance Monitoring può svolgere una funzione simile: passare dal sintomo “TTFB alto” alla domanda molto più utile “quale operazione sta consumando il tempo?”.
Come ridurre il Time to First Byte
Non esiste un intervento universale.
La soluzione dipende dalla componente che hai appena individuato.
La sequenza corretta è:
misura → isola la causa → intervieni → ripeti il test → controlla i dati reali
Ridurre il lavoro del backend
Se è il backend a generare il ritardo, devi ridurre il lavoro necessario a produrre la risposta.
Su WordPress può significare ottimizzare query inefficienti, eliminare elaborazioni inutili nel percorso della richiesta, verificare chiamate HTTP esterne, aggiornare PHP e componenti compatibili, correggere plugin problematici oppure aumentare risorse insufficienti.
Se il problema è specificamente il tempo necessario all’origine per generare l’HTML, è utile separare questa diagnosi dal TTFB complessivo. L’approfondimento su come ridurre il tempo di risposta del server WordPress affronta proprio quel sotto-problema.
Cambiare hosting ha senso quando esistono elementi che puntano realmente a CPU, memoria, I/O, concorrenza, limiti dell’account o capacità dell’infrastruttura.
Non quando l’unica evidenza è “TTFB alto”.
Usare cache e CDN dove hanno realmente senso
Per contenuti pubblici e ripetutamente richiesti, la page cache può evitare di rigenerare lo stesso HTML a ogni visita.
Su determinati stack WordPress, una cache integrata a livello server può ridurre in modo significativo il lavoro necessario per produrre la risposta. Nella guida a LiteSpeed, WordPress e LSCache abbiamo visto perché il vantaggio deriva dal meccanismo di caching e dall’integrazione dello stack, non dal nome del web server in sé.
Una CDN diventa particolarmente interessante quando:
- gli utenti sono geograficamente lontani dall’origine;
- il contenuto può essere servito o memorizzato all’edge;
- vuoi ridurre una parte della latenza di rete;
- l’infrastruttura edge offre DNS e protocolli efficienti.
Web.dev descrive proprio la prossimità geografica come uno dei motivi principali per utilizzare una CDN nell’ottimizzazione del TTFB.
Non tutto, però, è cacheabile.
Account autenticati, carrelli, checkout, contenuti personalizzati e altre risposte dinamiche richiedono politiche molto più attente. Un TTFB eccellente ottenuto servendo dati sbagliati dalla cache non è un’ottimizzazione.
Eliminare redirect evitabili e latenza di rete
Ogni redirect aggiuntivo costringe il browser a effettuare un nuovo passaggio prima di raggiungere la risorsa finale.
Controlla in particolare:
- collegamenti interni che puntano ancora a HTTP;
- varianti www/non-www errate;
- URL che passano attraverso vecchie strutture;
- catene create da più redirect successivi;
- link di campagne che potevano puntare direttamente alla destinazione finale.
Non devi eliminare un redirect necessario per ragioni architetturali o SEO. Devi eliminare quelli evitabili e le catene inutili.
Sul fronte della rete, invece, la priorità dipende dalla distribuzione geografica degli utenti. Se il problema è il round-trip time verso l’origine, ottimizzare una query SQL già rapidissima produrrà poco.
Ottimizzare WordPress, PHP e database senza interventi alla cieca
Su WordPress è facile trasformare l’ottimizzazione del TTFB in una collezione di ricette:
“installa questo plugin”, “usa questo hosting”, “attiva Redis”, “passa a LiteSpeed”.
Il problema è che tecnologie diverse risolvono colli di bottiglia diversi.
Una page cache può evitare gran parte dell’esecuzione di WordPress per pagine pubbliche già memorizzate.
Una object cache persistente può ridurre il costo di determinati accessi ripetuti ai dati, ma non sostituisce automaticamente una page cache.
Più CPU può aiutare un’applicazione realmente CPU-bound ma non elimina una chiamata API esterna lenta.
Un database più efficiente può risolvere query problematiche ma non riduce la distanza geografica.
Una CDN può avvicinare il contenuto agli utenti ma non corregge per magia un backend inefficiente quando ogni richiesta deve comunque raggiungere l’origine.
Prima identifica la parte lenta. Poi scegli la tecnologia.
È la differenza fra ottimizzare un sistema e accumulare plugin.
Gli errori più comuni quando si ottimizza il TTFB
Inseguire il valore più basso possibile
Il TTFB non è una gara.
Una volta che la fase iniziale non rappresenta più il collo di bottiglia, il tempo investito per guadagnare qualche decina di millisecondi potrebbe rendere molto meno di un intervento su LCP, JavaScript, immagini o risorse critiche.
Il valore corretto è sufficientemente rapido e stabile per l’architettura e il pubblico del sito, non necessariamente il numero più basso ottenibile in uno screenshot.
Cambiare hosting senza aver diagnosticato il problema
L’hosting è una delle possibili cause, non la spiegazione automatica.
Se il problema appare anche quando la risposta arriva dalla cache, potresti avere latenza di rete o configurazioni precedenti alla richiesta origin.
Se invece il TTFB crolla da oltre un secondo a poche centinaia di millisecondi quando la page cache è attiva, hai già un’indicazione molto più interessante: la generazione dinamica della pagina merita di essere analizzata.
Cambiare provider senza questa distinzione può semplicemente spostare lo stesso problema su un altro server.
Confondere un buon TTFB con una pagina complessivamente veloce
Un TTFB basso significa soltanto che il primo byte arriva rapidamente.
Dopo possono esserci megabyte di JavaScript, immagini enormi, CSS render-blocking, font lenti, layout instabili o task lunghi sul main thread.
Allo stesso modo, una pagina può avere un TTFB non eccezionale e offrire comunque un’esperienza complessivamente buona se il resto della pipeline è efficiente.
Per questo la nostra analisi professionale dell’ottimizzazione di un sito web non riduce mai le performance a un singolo punteggio o a una sola metrica.
Fidarsi di un solo test
Esegui più misurazioni.
Controlla almeno:
prima visita → visita con cache calda → posizione geografica differente → mobile/desktop quando pertinente → pagina diversa dello stesso sito
Se i risultati cambiano molto, quella variabilità è già un’informazione.
Potresti scoprire che:
- la homepage è veloce ma alcune pagine dinamiche no;
- il problema compare solo quando la cache scade;
- una determinata area geografica è molto più lenta;
- l’origine è lenta ma l’edge cache nasconde il problema;
- un picco di traffico cambia completamente la risposta.
Un singolo screenshot non può raccontare tutto questo.
Checklist pratica per diagnosticare un TTFB lento
Quando trovi un valore elevato, usa questa sequenza invece di iniziare immediatamente a modificare WordPress:
- Verifica che il problema sia ripetibile. Esegui più test e confronta risultati.
- Controlla field e lab data. Capisci se il problema riguarda utenti reali o soltanto un ambiente di test.
- Verifica redirect e URL finale. Elimina catene evitabili.
- Confronta località differenti. Se il valore cambia molto, indaga rete e distanza dall’origine.
- Confronta cache hit e cache miss. Se la differenza è enorme, analizza la generazione dinamica.
- Controlla il documento HTML nel waterfall. Non confondere il TTFB con problemi che avvengono dopo.
- Misura il backend. Usa profiling, APM o
Server-Timingquando possibile. - Isola database, PHP, plugin e chiamate esterne. Non disattivare componenti a caso su un sito in produzione.
- Valuta hosting e risorse solo con evidenze. CPU, RAM e I/O sono cause possibili, non automatiche.
- Ripeti esattamente lo stesso test dopo l’intervento.
- Controlla successivamente i dati reali. Un miglioramento di laboratorio deve tradursi, quando il campione lo permette, anche nell’esperienza degli utenti.
Questa sequenza evita buona parte delle false diagnosi legate alla velocità.
Conclusione
Il TTFB è una metrica di attesa iniziale, non un voto complessivo sulla qualità del sito e nemmeno una scorciatoia per prevedere il ranking.
Un valore elevato merita attenzione perché può rallentare l’inizio dell’intera pipeline di caricamento e consumare tempo prima di FCP e LCP. Ma il numero, da solo, non dice se il problema è il server, WordPress, la rete, un redirect, la cache o la distanza dall’origine.
Il passaggio decisivo è quindi smettere di ottimizzare il TTFB come numero isolato e iniziare a usarlo come segnale diagnostico.
Se il valore è alto, misura in condizioni diverse, separa rete e backend, confronta cache hit e miss, analizza il documento iniziale e individua la fase che sta realmente introducendo latenza.
Solo dopo ha senso decidere se intervenire su hosting, database, PHP, cache, CDN o architettura.
Un sito veloce non è quello con lo screenshot migliore: è quello che risponde in modo stabile agli utenti reali e nel quale ogni intervento è collegato a un problema effettivamente misurato.