
Il Deep Web è la parte del Web che non compare negli indici dei normali motori di ricerca. Non è necessariamente nascosta, anonima o illegale: la tua casella email, l’home banking, un pannello cloud, un’area clienti protetta da password o un database accessibile dopo una ricerca possono rientrare nel Deep Web.
Questa distinzione cambia anche la risposta alla domanda più comune: per accedere al Deep Web, nella maggior parte dei casi, non serve Tor. Basta un normale browser, l’indirizzo corretto e, quando richiesto, le credenziali necessarie.
Tor e gli indirizzi .onion diventano rilevanti quando si parla del Dark Web, cioè di una parte più specifica del Web raggiungibile attraverso reti e software progettati anche per nascondere la posizione dei servizi e rendere più difficile collegare utenti e destinazioni.
Deep Web e Dark Web sono quindi collegati, ma non sono sinonimi. Capire la differenza permette anche di evitare molti dei miti che ancora circolano su “Internet nascosto”.
Cos’è davvero il Deep Web
Il termine Deep Web, spesso tradotto come web sommerso o web profondo, descrive i contenuti del World Wide Web che non vengono normalmente mostrati nei risultati dei motori di ricerca generalisti.
La caratteristica decisiva non è quindi essere segreti. È non essere presenti nell’indice utilizzato dal motore per costruire i risultati di ricerca.
Quando cerchi qualcosa su Google, Bing o un altro motore non stai interrogando direttamente ogni server presente su Internet. Stai interrogando un indice costruito attraverso attività di discovery, crawling, elaborazione e classificazione delle risorse accessibili ai crawler.
Tutto ciò che non può essere trovato, raggiunto o inserito in quell’indice può restare fuori dai risultati.
Indicizzazione: perché alcuni contenuti non compaiono su Google
Una risorsa può non essere indicizzata per motivi molto diversi.
Alcuni contenuti sono disponibili soltanto dopo un login. Altri vengono generati dinamicamente quando compili un modulo o interroghi un database. Un editore può proteggere un articolo dietro autenticazione o abbonamento. Un’azienda può riservare applicazioni e documenti alla propria intranet.
Esistono poi scelte tecniche esplicite.
Un proprietario del sito può chiedere ai motori di non indicizzare una pagina tramite la direttiva noindex. Google chiarisce inoltre che la protezione tramite password o autenticazione impedisce al crawler di raggiungere il contenuto riservato.
Questo non significa che qualsiasi URL escluso dai risultati debba essere trattato automaticamente come un misterioso “sito del Deep Web”. Significa che l’indice pubblico dei motori non coincide con l’intero Web accessibile agli utenti.
La documentazione di Google Search Central sul crawling e sull’indicizzazione è utile proprio per capire questa differenza: discovery, crawling, accesso e indicizzazione sono passaggi distinti.
Email, home banking, cloud e database: usi il Deep Web ogni giorno
La parte più importante da capire è quanto il Deep Web sia ordinario.
Quando accedi alla webmail, Google non dovrebbe poter indicizzare il contenuto della tua posta privata. Lo stesso vale per l’estratto conto bancario visualizzato dopo il login o per i file presenti nel tuo spazio cloud personale.
Altri esempi possono comprendere:
- pannelli amministrativi e aree riservate;
- sistemi gestionali e applicazioni SaaS;
- intranet aziendali;
- account personali;
- cartelle cliniche protette;
- database scientifici e accademici;
- archivi pubblici interrogabili tramite form;
- documenti disponibili solo agli utenti autorizzati;
- contenuti dietro paywall o abbonamento;
- risultati prodotti dinamicamente da una ricerca interna.
In molti di questi casi non esiste nulla di clandestino. La mancata indicizzazione è una conseguenza della privacy, dell’autenticazione, della struttura del servizio o delle scelte del proprietario.
Quanto è grande il Deep Web? Perché le percentuali precise sono poco affidabili
È frequente leggere che il Deep Web rappresenterebbe il 90%, il 95% o una percentuale simile di Internet. Si trovano anche affermazioni secondo cui sarebbe centinaia di volte più grande del Web visibile.
Il problema è che trasformare queste stime in una fotografia precisa dell’attuale World Wide Web è difficile.
Come si misura, per esempio, il numero di risultati che milioni di database possono generare dinamicamente? Un account cloud con migliaia di file privati equivale a una pagina, mille documenti o a un insieme di risorse potenzialmente variabile? Come si confronta questo patrimonio con miliardi di URL pubblici che cambiano continuamente?
Inoltre Internet e Web non sono sinonimi: Internet comprende infrastrutture, protocolli e servizi che vanno oltre le pagine del WWW.
Per questo è più corretto fermarsi alla conclusione che possiamo realmente sostenere: il Web non indicizzato è molto esteso, ma attribuirgli una percentuale universale e stabile crea una precisione che il fenomeno non permette di misurare facilmente.
La metafora dell’iceberg può essere utile per visualizzare la differenza tra ciò che un motore mostra e ciò che rimane fuori dall’indice. Non dovrebbe però diventare un grafico quantitativo con proporzioni presentate come misurate.
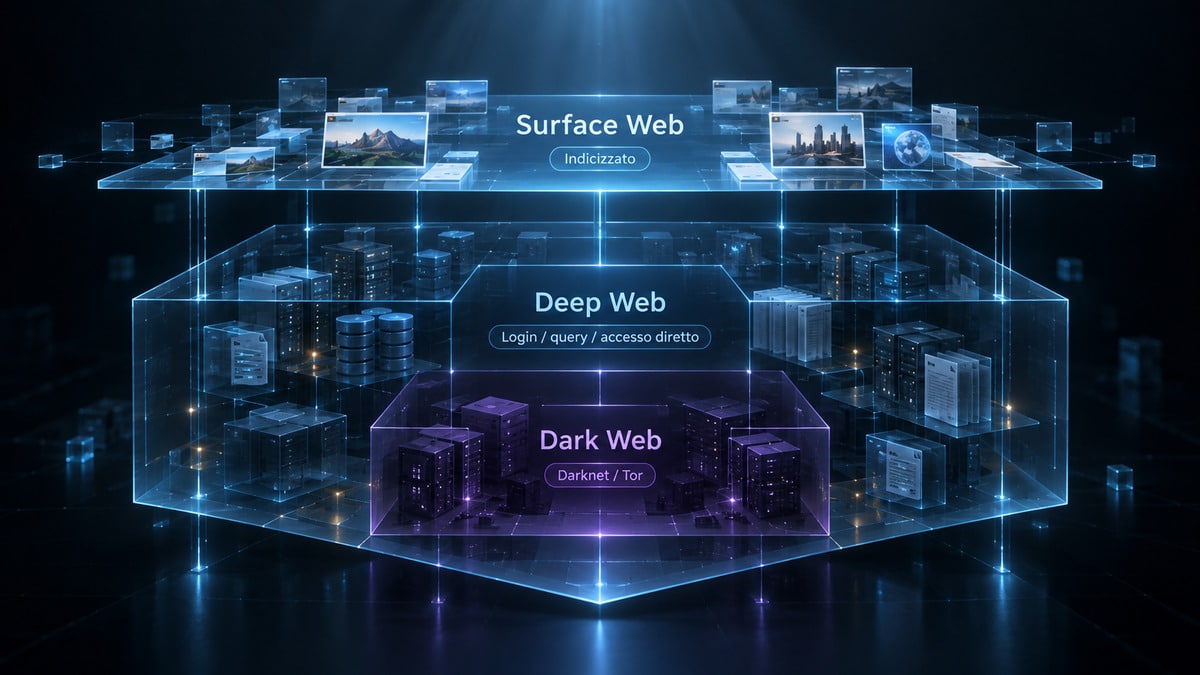
Surface Web, Deep Web e Dark Web: le differenze
La confusione nasce soprattutto perché Surface Web, Deep Web e Dark Web vengono spesso rappresentati come tre “livelli” dello stesso sistema.
È più utile considerarli in base a indicizzazione e modalità di accesso.
| Area | Indicizzata dai normali motori | Come si accede | Software speciale | Esempi |
|---|---|---|---|---|
| Surface Web | Normalmente sì | Browser e ricerca o link | No | siti pubblici, blog, ecommerce, pagine informative |
| Deep Web | Normalmente no | Browser, URL diretto, login, query o autorizzazione | Generalmente no | webmail, home banking, intranet, database, cloud privati |
| Dark Web | No | Attraverso una darknet compatibile | Generalmente sì | onion service e altri servizi intenzionalmente non esposti sul Web pubblico |
Il CERT-AGID distingue Surface Web, Deep Web e Dark Web proprio sulla base delle differenti modalità con cui questi contenuti vengono resi accessibili.
Il Deep Web non significa anonimato
Un contenuto può appartenere al Deep Web senza fornire alcun anonimato.
Se accedi al conto corrente tramite username, password e autenticazione a più fattori, la banca sa quale account stai utilizzando. Il fatto che l’area personale non compaia su Google non nasconde la tua identità al servizio.
Allo stesso modo, un gestionale aziendale può registrare utente, indirizzo IP, attività e orari pur essendo completamente invisibile ai motori di ricerca.
Indicizzazione e anonimato risolvono problemi differenti.
Una risorsa non indicizzata non diventa anonima e un sistema orientato all’anonimato non diventa automaticamente parte del Deep Web soltanto perché protegge meglio l’indirizzo IP dell’utente.
Il Dark Web è un sottoinsieme, non un sinonimo
Con Dark Web si indica invece una porzione intenzionalmente nascosta raggiungibile attraverso darknet e tecnologie specifiche.
La differenza pratica è importante.
Una dashboard privata è fuori dall’indice perché richiede l’autenticazione, ma continua a essere servita attraverso la normale infrastruttura Web.
Un onion service, invece, viene progettato per essere raggiunto all’interno dell’ecosistema Tor e non attraverso la normale risoluzione di un dominio pubblico.
Per questo l’equazione:
Deep Web = Dark Web
è sbagliata.
È più corretto ragionare così:
Web non indicizzato → Deep Web
servizi intenzionalmente nascosti su darknet → Dark Web
Il secondo insieme rientra concettualmente nel primo, ma rappresenta soltanto una categoria particolare.
Darknet e siti .onion: dove entra davvero in gioco Tor
Tor è una rete progettata per rendere più difficile collegare l’origine di una comunicazione alla sua destinazione.
Può essere utilizzata anche per raggiungere normali siti del Web pubblico. Non è quindi sinonimo di Dark Web.
Gli onion service rappresentano invece servizi raggiungibili soltanto attraverso Tor. La documentazione ufficiale del Tor Project spiega che questi servizi possono nascondere la posizione del server e mantenere la comunicazione all’interno dell’infrastruttura Tor.
Se vuoi capire il meccanismo senza confondere rete, browser e Dark Web, nella guida dedicata trovi spiegato cos’è Tor, come funziona Tor Browser e quali limiti ha l’anonimato.
Gli indirizzi onion attuali sono inoltre molto diversi da un normale dominio DNS. Il Tor Project indica che gli indirizzi supportati utilizzano il formato v3 e sono costituiti da una lunga stringa di caratteri seguita da .onion.
Questa parte appartiene al tema Dark Web/Tor. Non è necessaria per entrare nella casella email, utilizzare l’home banking o consultare un normale database privato.
Come accedere al Deep Web
Se per Deep Web intendiamo correttamente l’insieme dei contenuti non indicizzati, non esiste un unico metodo per accedervi.
Dipende dalla risorsa.
Per la maggior parte dei servizi che utilizzi quotidianamente è sufficiente un browser normale.
URL diretto, autenticazione e contenuti protetti
Il caso più semplice è una pagina conosciuta ma non pubblicamente indicizzata.
Puoi raggiungerla attraverso:
URL → pagina
oppure, se serve autenticazione:
URL → login → verifica identità → contenuto
È quello che accade con un’area clienti, un account bancario, una webmail o un’applicazione aziendale.
In questo scenario non stai cercando un “portale segreto”. Stai accedendo a una risorsa per la quale il server decide se possiedi le autorizzazioni corrette.
Il fatto che la pagina non appaia su Google è una conseguenza prevista del sistema.
Database e contenuti generati da una ricerca interna
Un secondo caso riguarda le informazioni recuperate tramite database.
Immagina un archivio contenente milioni di record. Il motore pubblico potrebbe indicizzare la pagina iniziale dell’archivio, ma non necessariamente ogni possibile combinazione di filtri e risultati che il sistema può generare.
Il percorso diventa quindi:
pagina pubblica → query interna → database → risultati
Quei risultati esistono per l’utente nel momento in cui effettua la ricerca, ma non devono necessariamente esistere come milioni di pagine pubbliche già disponibili ai crawler.
È uno dei motivi per cui la definizione “non lo trovo su Google” è più utile della rappresentazione cinematografica di un Internet parallelo.
Quando serve Tor Browser e quando invece non serve
Tor Browser serve quando vuoi utilizzare la rete Tor o raggiungere un onion service.
Non serve per il normale accesso a:
- Gmail o altre webmail;
- home banking;
- area riservata di un sito;
- pannello WordPress;
- account cloud;
- database accessibile dal Web;
- intranet raggiungibile con le autorizzazioni corrette.
Se una guida ti dice che devi installare Tor semplicemente per “entrare nel Deep Web”, sta in realtà utilizzando Deep Web come sinonimo impreciso di Dark Web.
La distinzione è importante anche per la sicurezza. Installare strumenti aggiuntivi non rende automaticamente più protetto un servizio che funziona già attraverso autenticazione e HTTPS, così come utilizzare Tor non trasforma ogni attività online in una sessione anonima.
Cosa si trova nel Deep Web
Chiedersi cosa si trova nel Deep Web porta spesso a immagini di marketplace clandestini, forum segreti e materiale illegale.
È una rappresentazione fortemente distorta.
La maggior parte degli esempi utili riguarda informazioni private, contenuti protetti o sistemi che non hanno alcun motivo per essere esposti nell’indice di un motore generalista.
Account, posta elettronica e servizi personali
Il tuo account personale è probabilmente l’esempio più immediato.
Dopo il login puoi visualizzare dati che altri utenti non devono vedere:
- email;
- documenti;
- fotografie private;
- fatture;
- ordini;
- informazioni bancarie;
- dati sanitari;
- cronologie e impostazioni personali.
Se un motore di ricerca potesse indicizzare liberamente queste informazioni, avremmo un problema di sicurezza, non una funzionalità utile.
Database scientifici, accademici, aziendali e istituzionali
Una parte importante del Web funziona attraverso banche dati specializzate.
Università, biblioteche, istituzioni pubbliche, aziende e centri di ricerca possono mettere a disposizione strumenti con cui interrogare collezioni molto più grandi di quanto sia visibile in una normale SERP.
Alcune informazioni sono pubbliche ma devono essere recuperate tramite una ricerca interna. Altre richiedono un account, un abbonamento o particolari autorizzazioni.
È qui che l’espressione Invisible Web descrive bene il problema: i dati possono essere perfettamente legittimi e accessibili, ma non esposti nello stesso modo di una normale pagina pubblica.
Paywall, intranet e archivi privati
Anche i contenuti dietro paywall o all’interno di sistemi privati contribuiscono al Web non indicizzato.
Il punto non è il pagamento in sé.
Un editore può consentire ai crawler di vedere una parte della pagina e proteggere il resto. Un altro servizio può impedire completamente l’accesso senza autenticazione. Un’azienda può rendere un portale disponibile soltanto dalla propria rete o tramite sistemi di accesso remoto.
Il Deep Web comprende quindi casi tecnicamente molto diversi accomunati da una caratteristica: il contenuto completo non appartiene all’indice pubblico normalmente interrogato dall’utente.
E il Dark Web? Contenuti leciti e illeciti senza sensazionalismo
Nel Dark Web possono esistere forum, sistemi di comunicazione, servizi per whistleblower, piattaforme utilizzate da giornalisti o persone che vivono sotto regimi censori e normali progetti orientati alla privacy.
Possono esistere anche mercati illegali, frodi, materiale rubato, malware e altri servizi criminali.
La tecnologia di accesso non stabilisce però da sola la natura del contenuto.
Un servizio onion non è automaticamente illegale, così come un normale sito HTTPS non è automaticamente sicuro o legittimo.
È molto più utile valutare chi gestisce il servizio, cosa offre e quale attività viene svolta anziché giudicarlo soltanto dall’infrastruttura utilizzata.
Esistono motori di ricerca per il Deep Web?
La query “motori di ricerca Deep Web” contiene in realtà almeno tre problemi diversi.
Il primo riguarda le pagine semplicemente escluse dai motori generalisti. Il secondo riguarda database verticali interrogabili attraverso strumenti propri. Il terzo riguarda gli onion service del Dark Web.
Trattarli come un’unica cosa porta a liste poco utili.
Perché Google non può indicizzare un account privato
Un normale motore ha bisogno di poter scoprire e accedere alla risorsa.
Se una pagina richiede credenziali personali che Googlebot non possiede, il crawler non può effettuare il login al posto tuo e vedere ciò che vedi nel tuo account.
Questo è intenzionale.
Google stessa indica la protezione tramite password come uno dei modi per impedire che contenuti privati vengano mostrati nella Ricerca.
Non esiste quindi un motore alternativo che possa magicamente cercare dentro la tua casella email privata senza avere accesso al tuo account.
Motori verticali, database e ricerca interna non sono “Google del Deep Web”
Esistono però motori e sistemi di ricerca specializzati.
Una biblioteca può consentire di interrogare il proprio catalogo. Un archivio pubblico può offrire filtri sui record. Una piattaforma scientifica può permettere la ricerca tra pubblicazioni e dataset. Un ecommerce può generare risultati interrogando il proprio database prodotti.
Questi sistemi possono raggiungere informazioni che una ricerca generalista non espone direttamente.
Chiamarli tutti “motori del Deep Web”, però, rischia di nascondere ciò che fanno realmente.
Sono più spesso:
motori verticali
cataloghi
database interrogabili
search interne
La distinzione fra motore di ricerca, indice e semplice interfaccia di interrogazione è importante anche sul Web pubblico. Se vuoi approfondirla, nella guida ai motori di ricerca alternativi a Google trovi anche la differenza tra indice proprietario, metamotore e provider esterno dei risultati.
Cercare servizi .onion è un problema diverso
Nel Dark Web esistono strumenti che tentano di indicizzare onion service, ma il problema è molto diverso da quello di Google.
I servizi possono cambiare indirizzo, sparire, limitare l’accesso o rimanere online per periodi brevi. Nessun indice garantisce quindi una fotografia completa e affidabile.
Per questo non è utile trasformare una guida sul Deep Web in una directory di indirizzi onion. Oltre a cambiare l’intento dell’articolo, una lista di link può invecchiare rapidamente e non offre alcuna garanzia sull’affidabilità delle destinazioni.
Conoscere un indirizzo non equivale a fidarsi del servizio che lo utilizza.
Il Deep Web è illegale?
No. Il Deep Web non è illegale in sé.
Accedere alla propria email, al conto bancario o all’area riservata del proprio datore di lavoro con le credenziali e le autorizzazioni corrette è normale attività online.
Lo stesso principio aiuta a capire il Dark Web.
Anche l’accesso a una rete orientata alla privacy non trasforma automaticamente l’attività in un reato. Conta ciò che l’utente fa, quali contenuti utilizza, quali beni o servizi scambia e quali leggi risultano applicabili.
ANSA Verified, affrontando direttamente la domanda sulla legalità del Dark Web, evidenzia proprio questa distinzione tra tecnologia utilizzata e condotta criminale.
Naturalmente questo non significa che qualsiasi contenuto o comportamento sia consentito. Frode, compravendita di beni illegali, accesso non autorizzato a sistemi, distribuzione di malware e altre attività possono costituire reati indipendentemente dal fatto che avvengano sul Surface Web, nel Deep Web o attraverso una darknet.
La tecnologia non crea un’eccezione alla legge.
Deep Web: rischi reali e precauzioni
Parlare genericamente dei “pericoli del Deep Web” produce un altro equivoco.
Accedere alla propria banca online non è intrinsecamente più rischioso perché la pagina appartiene al Web non indicizzato.
I rischi cambiano invece quando si visitano servizi sconosciuti, si seguono collegamenti di provenienza incerta, si scaricano file o si affidano dati e credenziali a soggetti non verificati.
Phishing, siti falsi e furto di credenziali
Un sito può imitare graficamente un servizio affidabile e cercare di rubare username, password o codici di autenticazione.
Il problema non riguarda solo il Dark Web.
Il phishing funziona benissimo anche attraverso email, SMS, social network e normali siti pubblici. La tecnica punta soprattutto a convincerti a fornire informazioni o a compiere un’azione utile all’attaccante.
Un lucchetto nel browser o una connessione HTTPS non dimostrano inoltre che il proprietario del dominio sia affidabile: indicano principalmente che la connessione con quel servizio utilizza determinate protezioni crittografiche e di autenticazione del canale.
Prima di inserire dati sensibili conviene quindi verificare dominio, provenienza del link, identità del servizio e azione che viene richiesta.
Malware e file provenienti da fonti non affidabili
Un download proveniente da un servizio sconosciuto può contenere malware proprio come un file scaricato dal Web pubblico.
Il rischio aumenta quando l’utente abbassa le normali cautele perché ritiene di trovarsi in un ambiente “speciale” o anonimo.
File eseguibili, documenti con contenuto attivo, archivi e installer ottenuti da fonti non verificate devono essere trattati con prudenza.
Se devi controllare un file o un URL sospetto, VirusTotal può fornire una seconda opinione, ma anche in questo caso zero rilevamenti non significano automaticamente che il contenuto sia sicuro.
Anonimato: browser privato, VPN e Tor non sono la stessa cosa
Tre strumenti vengono spesso confusi.
La navigazione privata del browser agisce soprattutto sui dati conservati localmente durante o dopo la sessione. Non rende invisibile il traffico al provider, al sito visitato o alla rete attraverso cui stai navigando.
Una VPN crea invece un percorso verso un server remoto e modifica quali soggetti possono osservare alcune parti della comunicazione. Sposta però anche una parte del modello di fiducia verso il provider VPN.
Tor distribuisce il percorso tra più relay e nasce per rendere più difficile collegare origine e destinazione.
Nessuno dei tre sistemi permette di ignorare ciò che fai a livello applicativo.
Se effettui il login con nome e cognome, invii il tuo indirizzo o comunichi volontariamente dati identificativi, il servizio può riconoscerti anche se non vede il tuo normale indirizzo IP.
Perché conoscere un indirizzo non rende affidabile un sito
Questo è particolarmente importante con gli onion service.
Il Tor Project segnala che gli indirizzi onion correnti sono lunghi e che anche un singolo errore impedisce di raggiungere il servizio previsto. La documentazione ufficiale sul troubleshooting degli onion service ricorda inoltre che i vecchi indirizzi v2 non sono più supportati.
Ma anche un indirizzo formalmente valido può portare a un servizio che non conosci.
Prima di fidarti devi ancora chiederti:
- da dove proviene l’indirizzo;
- chi controlla il servizio;
- se esiste una fonte affidabile che lo conferma;
- quali dati ti sta chiedendo;
- cosa stai per scaricare;
- perché dovresti considerarlo attendibile.
La privacy della rete e l’affidabilità del contenuto sono due proprietà differenti.
I falsi miti sul Deep Web
Il Deep Web è diventato terreno ideale per metafore, leggende e semplificazioni. Alcune hanno una funzione didattica, altre rendono più difficile capire il meccanismo reale.
“Deep Web e Dark Web sono la stessa cosa”
No.
Il Deep Web comprende in senso ampio contenuti che non fanno parte dell’indice pubblico dei motori. Il Dark Web è una porzione intenzionalmente nascosta raggiungibile attraverso tecnologie e darknet specifiche.
Una webmail privata e un onion service non sono tecnicamente la stessa cosa soltanto perché nessuno dei due compare nella normale ricerca Google.
“Per entrare nel Deep Web serve Tor”
No.
Se apri l’home banking, accedi alla webmail o utilizzi un’applicazione SaaS protetta da login, stai già interagendo con contenuti che non devono essere pubblicamente indicizzati.
Tor è pertinente quando vuoi utilizzare la rete Tor e, in particolare, quando devi raggiungere gli onion service.
Confondere i due concetti è uno dei motivi per cui molte guide intitolate “come accedere al Deep Web” finiscono in realtà per spiegare come accedere al Dark Web.
“Esistono otto livelli segreti di Internet”
Online circolano diagrammi che dividono Internet in livelli sempre più profondi, con nomi come Bergie Web, Charter Web o Mariana’s Web.
Non rappresentano una tassonomia tecnica riconosciuta dell’architettura del Web.
Non esiste un protocollo che, superato il “livello 3”, faccia entrare l’utente in un nuovo strato segreto di Internet.
Le distinzioni tecnicamente utili riguardano piuttosto:
- accessibilità;
- indicizzazione;
- autenticazione;
- rete utilizzata;
- protocolli;
- autorizzazioni;
- esposizione pubblica o privata del servizio.
Le piramidi dei “livelli” funzionano bene come folklore Internet, molto meno come modello tecnico.
“Il Deep Web è esattamente il 90 o il 95% del Web”
Non disponiamo di un censimento globale e continuamente aggiornato che consenta di assegnare una percentuale così precisa.
Le stime che circolano vengono spesso ripetute da una fonte all’altra senza mantenere visibili metodologia, periodo e definizione utilizzata.
Il problema non è stabilire se il Deep Web sia grande. Lo è certamente.
Il problema è attribuire un numero molto preciso a un insieme che comprende database dinamici, account privati, sistemi chiusi, contenuti autenticati e risorse che possono essere generate soltanto dopo una query.
“Molto più del Web indicizzato” è una conclusione difendibile. “Esattamente il 95%” richiederebbe invece una misurazione che non abbiamo.
“Tor rende anonimi qualunque cosa facciamo”
Anche questo è falso.
Tor può nascondere l’indirizzo IP dell’utente alla destinazione e rendere più difficile collegare le due estremità della comunicazione. Non può però cancellare i dati che l’utente decide di fornire.
Se effettui il login al tuo account personale, scrivi il tuo nome, usi la tua email o scarichi e apri un file che comunica fuori dal circuito, il modello di privacy cambia.
L’anonimato non è un interruttore.
È il risultato dell’intera catena:
dispositivo → software → rete → account → comportamento → destinazione
Basta ignorarne un pezzo per ottenere un risultato molto diverso da quello immaginato.
Conclusione
Capire il Deep Web diventa molto più semplice quando si elimina l’idea del “secondo Internet” nascosto sotto quello normale.
Il Deep Web è soprattutto Web non indicizzato: aree personali, account, database, intranet, servizi protetti e contenuti che un motore generalista non può o non deve mostrare nelle proprie SERP.
Per accedervi, nella maggior parte dei casi, utilizzi già gli strumenti di tutti i giorni: un browser, un URL, una ricerca interna e le credenziali appropriate.
Il Dark Web risponde invece a un modello differente. Utilizza darknet e sistemi progettati per rendere intenzionalmente meno visibili utenti o servizi; gli onion service di Tor ne sono l’esempio più conosciuto.
È questa la distinzione da portarsi dietro:
Deep Web significa soprattutto mancata indicizzazione. Dark Web significa accesso attraverso infrastrutture intenzionalmente nascoste. Tor è una tecnologia di rete, non un sinonimo di nessuno dei due.
Una volta separati questi tre concetti, spariscono anche buona parte dei falsi miti: non servono “livelli segreti”, percentuali spettacolari o directory misteriose per capire come funziona davvero la parte del Web che i motori di ricerca non mostrano.