
La SEO tecnica comprende gli interventi che permettono ai motori di ricerca di trovare, recuperare, elaborare e indicizzare correttamente le pagine di un sito. È la parte della SEO che lavora soprattutto su crawling, rendering, indicizzazione, architettura, status HTTP, canonicalizzazione, performance e altri segnali tecnici.
La distinzione importante è questa: rendere una pagina tecnicamente accessibile non significa farla automaticamente posizionare. Prima Google deve poterla scoprire e processare; poi deve decidere se indicizzarla e, per una determinata ricerca, se considerarla abbastanza pertinente e utile da mostrarla. Nella documentazione su come funziona la Ricerca Google, Google descrive infatti tre grandi fasi — scansione, indicizzazione e pubblicazione dei risultati — e precisa che né la scansione né l’indicizzazione sono garantite.
Per questo una buona analisi di SEO tecnica non dovrebbe partire da una checklist di cinquanta controlli trattati tutti allo stesso modo. Dovrebbe partire da una domanda più concreta: che cosa sta impedendo a questa pagina, a questo template o a questa parte del sito di arrivare correttamente al punto in cui il ranking può diventare un problema?
È il modello che useremo in questa guida:
scoperta → crawling → rendering → indicizzazione → canonicalizzazione → serving e ranking
Se vuoi partire dal quadro complessivo prima di entrare negli aspetti infrastrutturali, la guida alla SEO distingue queste fasi dalle attività on-page, off-page e strategiche.
Cos’è la SEO tecnica e a cosa serve
La SEO tecnica è l’area dell’ottimizzazione organica che interviene sulle condizioni tecniche con cui un motore di ricerca accede e interpreta un sito.
In termini pratici, serve a ridurre ostacoli come pagine irraggiungibili, risposte HTTP errate, direttive di indicizzazione incoerenti, canonical contraddittorie, architetture che nascondono contenuti importanti, rendering JavaScript problematico o performance insufficienti.
Google riduce i propri requisiti tecnici minimi per la Ricerca a tre condizioni sorprendentemente semplici: Googlebot non deve essere bloccato, la pagina deve restituire una risposta HTTP 200 valida e deve contenere contenuti indicizzabili. Soddisfare questi requisiti rende una pagina idonea all’indicizzazione, non garantisce che Google la indicizzi o la posizioni.
Questo punto aiuta anche a non trasformare la disciplina tecnica in una collezione di rituali SEO.
Un sito può avere una sitemap perfetta e non meritare una posizione migliore. Può avere ottimi Core Web Vitals e un contenuto non pertinente. Può avere un contenuto eccellente ma una direttiva noindex che lo esclude dalla Ricerca.
La diagnosi viene prima della correzione.
SEO tecnica, SEO on-page e SEO off-page: dove passa il confine
Le categorie servono a organizzare il lavoro, non a creare compartimenti stagni.
| Area | Problema principale | Esempi |
|---|---|---|
| SEO tecnica | Il motore riesce a trovare, recuperare, elaborare e gestire correttamente la pagina? | crawling, canonical, robots, sitemap, rendering, status HTTP, redirect, performance |
| SEO on-page | La pagina rende chiari argomento, intento e contenuto? | title, heading, testo, immagini, struttura informativa |
| SEO off-page | Quali segnali e relazioni esistono fuori dal sito? | backlink, citazioni, digital PR, reputazione |
La SEO on-page entra nel merito dell’ottimizzazione della singola pagina; la SEO off-page riguarda invece segnali e attività esterne.
Il confine non è sempre perfetto. I link interni, per esempio, sono contemporaneamente elemento editoriale, architetturale e tecnico. La domanda utile non è quindi “in quale casella metto questo intervento?”, ma quale problema sto cercando di risolvere?
Come Google trova, elabora e indicizza una pagina
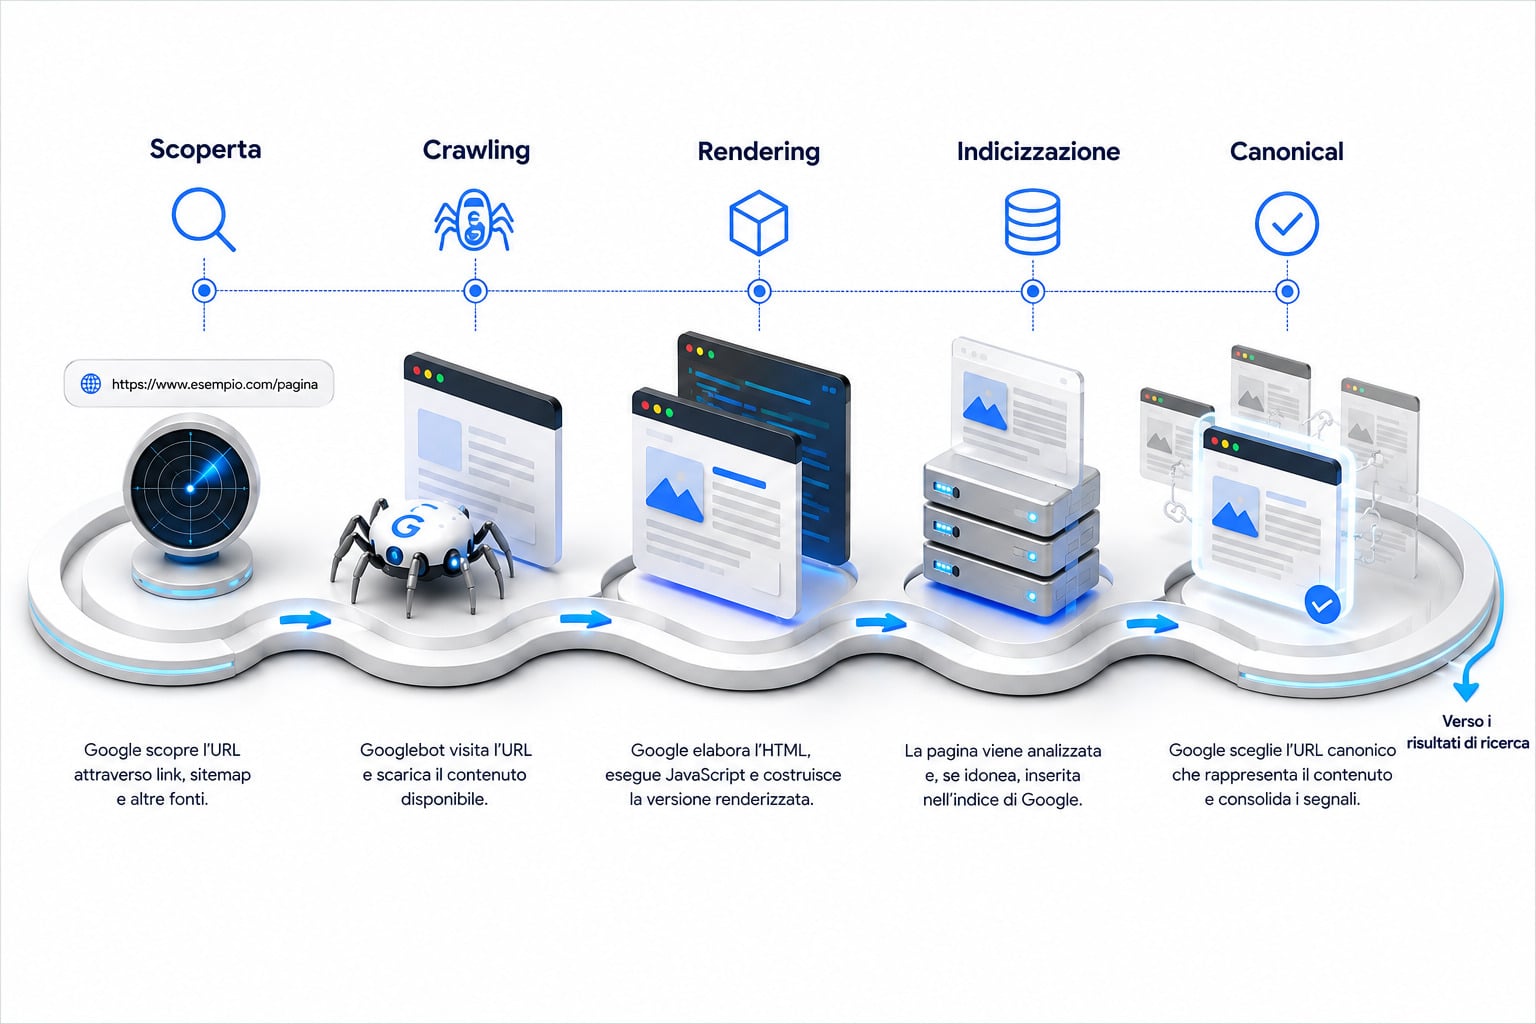
Capire il percorso di una pagina è più utile che memorizzare singole best practice.
Una pagina non passa direttamente da “pubblicata” a “posizionata”. Esistono passaggi distinti, e un problema in uno dei primi può rendere irrilevanti molte ottimizzazioni successive.
Discovery e crawling: trovare un URL non significa indicizzarlo
Google deve innanzitutto conoscere l’esistenza dell’URL.
Può scoprirlo attraverso link presenti su pagine già note, navigazione interna, sitemap e altre fonti. Una volta scoperto, Googlebot può decidere di recuperarlo. Google stabilisce algoritmicamente quali siti sottoporre a scansione, con quale frequenza e quanti URL recuperare.
Qui l’architettura interna conta molto.
Se una pagina strategica esiste nella sitemap ma nessuna pagina significativa del sito la collega, la sua situazione non è equivalente a quella di una risorsa integrata naturalmente nella navigazione e nel cluster editoriale.
Una sitemap può aiutare Google a conoscere un URL, ma non sostituisce una buona struttura interna e non garantisce né scansione né indicizzazione. Nella propria documentazione sulle sitemap, Google precisa inoltre che, quando le pagine sono collegate correttamente, riesce normalmente a trovare gran parte dei contenuti anche attraverso i link.
Per approfondire questo strumento senza confonderlo con un comando di indicizzazione, trovi una guida dedicata alle sitemap XML.
Rendering: il contenuto deve esistere anche per il crawler
Nei siti semplici gran parte del contenuto utile è già presente nella risposta HTML iniziale.
Con applicazioni e framework JavaScript la situazione può diventare più complessa. Nella guida di base alla SEO per JavaScript, Google descrive il processamento delle web app attraverso crawling, rendering e indicizzazione. Durante il rendering utilizza un ambiente basato su Chromium per eseguire JavaScript e ottenere l’HTML elaborato.
Il fatto che Google possa eseguire JavaScript non significa però che ogni implementazione sia automaticamente sicura dal punto di vista della ricerca.
Se il contenuto principale compare soltanto dopo una chiamata che fallisce, una risorsa necessaria è bloccata, un link non viene costruito in modo scansionabile o l’HTML renderizzato non contiene ciò che dovrebbe, il problema diventa tecnico.
Per questo, quando sospetti un problema JavaScript, non basta guardare la pagina nel tuo browser: devi verificare che cosa riceve e renderizza Google.
Indicizzazione: una pagina scansionata può comunque non entrare nell’indice
Dopo il recupero e l’elaborazione, Google analizza i contenuti della pagina e decide come trattarli nel proprio indice.
È qui che diventa utile una distinzione da mantenere per tutta la guida:
pagina scoperta ≠ pagina scansionata ≠ pagina indicizzata ≠ pagina posizionata
Una pagina può essere perfettamente raggiungibile ma avere una direttiva che ne impedisce l’indicizzazione. Può essere processata e non venire scelta come canonical. Può essere indicizzata ma non avere sufficiente pertinenza per la query che interessa.
La guida Creativemotions sull’indicizzazione Google approfondisce proprio le differenze fra questi stati.
Canonicalizzazione: Google deve capire quale versione rappresenta il contenuto
Quando più URL contengono materiale identico o molto simile, Google può raggrupparli e selezionare un URL rappresentativo, cioè il canonical.
Il tag rel="canonical" è uno dei segnali utilizzabili per indicare la propria preferenza, insieme ad altri elementi come redirect e presenza nella sitemap. Come spiega la documentazione Google sulla canonicalizzazione degli URL, non è però un ordine assoluto: Google può scegliere una canonical diversa quando i segnali disponibili portano a un’altra conclusione.
Questa precisazione cambia il modo in cui si affrontano molti problemi.
Se dichiari A come canonical ma la navigazione interna punta prevalentemente a B, la sitemap contiene B e altre configurazioni sostengono ancora B, il problema non si risolve semplicemente “mettendo un canonical”.
Serve coerenza fra i segnali.
Le principali aree della SEO tecnica
Una guida di SEO tecnica diventa poco utile quando trasforma ogni elemento del sito in un fattore SEO da ottimizzare.
Conviene invece identificare le aree in cui un errore può modificare concretamente accesso, elaborazione, consolidamento o esperienza della pagina.
Architettura del sito e link interni
L’architettura stabilisce come le risorse sono organizzate e collegate fra loro.
Per un crawler, un link HTML scansionabile è un percorso verso un altro URL. Per l’utente è una promessa: cliccandolo deve trovare un approfondimento coerente con il contesto.
Una struttura interna efficace rende raggiungibili le pagine importanti senza costringerle a vivere isolate. Questo non significa che ogni pagina debba trovarsi a un numero arbitrario di clic dalla home: significa che la gerarchia dovrebbe riflettere l’importanza e le relazioni reali fra i contenuti.
Il problema tipico non è soltanto la pagina completamente orfana. Può esistere anche una pagina formalmente collegata, ma soltanto da archivi secondari o da contesti semanticamente deboli.
In un audit di SEO tecnica controllerei quindi insieme discovery, profondità, contesto dei link e ruolo della pagina nel cluster.
Status HTTP, errori e redirect
I codici di stato HTTP comunicano che cosa è successo quando un crawler richiede una risorsa.
Una pagina che deve essere disponibile e indicizzabile dovrebbe normalmente restituire 200. Un URL rimosso può richiedere una risposta 404 o 410; uno spostamento permanente può richiedere un redirect permanente verso la destinazione corretta.
Il problema nasce quando la risposta tecnica racconta una storia diversa dalla realtà.
Una pagina di errore che restituisce 200, una catena di redirect inutilmente lunga oppure migliaia di link interni che puntano ancora a URL reindirizzati aumentano ambiguità e lavoro non necessario.
Quando un contenuto cambia definitivamente indirizzo, la guida ai redirect 301 approfondisce implementazione e casi d’uso.
Sitemap XML, robots.txt, meta robots e X-Robots-Tag
Questi strumenti vengono spesso nominati insieme, ma svolgono funzioni differenti.
Il file robots.txt regola principalmente l’accesso dei crawler agli URL. Google chiarisce nella propria guida al robots.txt che non è il metodo corretto per escludere una pagina web dai risultati: un URL bloccato può comunque essere conosciuto attraverso altri link e, in determinate condizioni, apparire senza che Google ne abbia eseguito la scansione.
Se vuoi impedire l’indicizzazione, il controllo appropriato è normalmente noindex, attraverso meta robots o intestazione HTTP. Affinché Google possa leggere la direttiva, però, il crawler deve poter accedere alla risorsa: la documentazione su come bloccare l’indicizzazione con noindex spiega perché bloccare contemporaneamente l’URL in robots.txt può impedire a Google di vedere la direttiva.
La guida al robots.txt entra nel dettaglio di sintassi, WordPress e casi pratici.
La sitemap svolge ancora un’altra funzione: fornisce a Google informazioni sugli URL che ritieni importanti e può facilitare la scoperta, soprattutto in siti grandi, nuovi o complessi. Non è un elenco che obbliga Google a indicizzare ogni voce.
Canonical, duplicati e proliferazione degli URL
I duplicati non nascono soltanto perché qualcuno copia una pagina.
Un ecommerce può produrre varianti tramite filtri e ordinamenti. Un CMS può generare URL diversi per contenuti equivalenti. Parametri, versioni HTTP/HTTPS, ambienti di staging erroneamente accessibili o strutture di navigazione incoerenti possono moltiplicare gli indirizzi riferiti allo stesso contenuto.
Il compito non è quindi “aggiungere il canonical ovunque”.
Prima devi capire quali URL devono realmente esistere, quali devono essere scansionabili, quali devono essere indicizzabili e quali versioni devono consolidarsi.
A quel punto redirect, canonical, sitemap, link interni e gestione dei parametri devono raccontare una storia coerente.
Rendering JavaScript e contenuti generati lato client
La JavaScript SEO diventa importante quando il funzionamento dell’applicazione modifica ciò che Google può recuperare o interpretare.
Google è in grado di eseguire JavaScript, ma consiglia comunque di verificare l’HTML renderizzato e segnala che il rendering lato server o il pre-rendering possono restare soluzioni valide per rendere i contenuti disponibili in modo più diretto a utenti e crawler.
Il criterio che userei è semplice: non chiederti se il sito “usa JavaScript”; chiediti se il contenuto, i link, i canonical e le altre informazioni necessarie esistono correttamente quando Google elabora la pagina.
È una domanda diagnostica molto più utile.
Performance, Core Web Vitals e mobile
Velocità e stabilità non dovrebbero essere trattate come un interruttore che decide da solo il ranking.
Nella documentazione dedicata all’esperienza sulle pagine e ai Core Web Vitals, Google conferma che i Core Web Vitals vengono utilizzati dai propri sistemi di ranking, ma chiarisce anche che un buon risultato nei report non garantisce le prime posizioni e che inseguire un punteggio perfetto esclusivamente per SEO può essere un cattivo impiego delle risorse.
Qui serve giudizio.
Se il sito mostra un LCP problematico perché l’immagine principale pesa diversi megabyte, correggere il problema può migliorare concretamente l’esperienza. Se invece stai spendendo giorni per passare da un risultato già buono a un punteggio sintetico perfetto mentre esistono pagine non indicizzabili, la priorità è probabilmente sbagliata.
Per la diagnosi puoi approfondire i Core Web Vitals e usare strumenti come PageSpeed Insights e Google Lighthouse, ricordando che misurano aspetti specifici e non sostituiscono un audit SEO completo.
Dati strutturati: enhancement, non requisito universale
I dati strutturati forniscono informazioni esplicite sul significato di determinati contenuti e, come spiega l’introduzione ufficiale ai dati strutturati di Google, possono rendere una pagina idonea a specifiche presentazioni avanzate nella Ricerca.
Non sono però un requisito tecnico da applicare indiscriminatamente a qualsiasi URL.
La decisione corretta parte dalla feature supportata e dal contenuto reale della pagina. Se esiste un tipo di markup pertinente, può essere utile implementarlo e validarlo. Aggiungere schema senza una funzione concreta oppure marcare informazioni non presenti realmente nella pagina crea invece complessità senza un vantaggio editoriale chiaro.
Quali problemi tecnici correggere prima
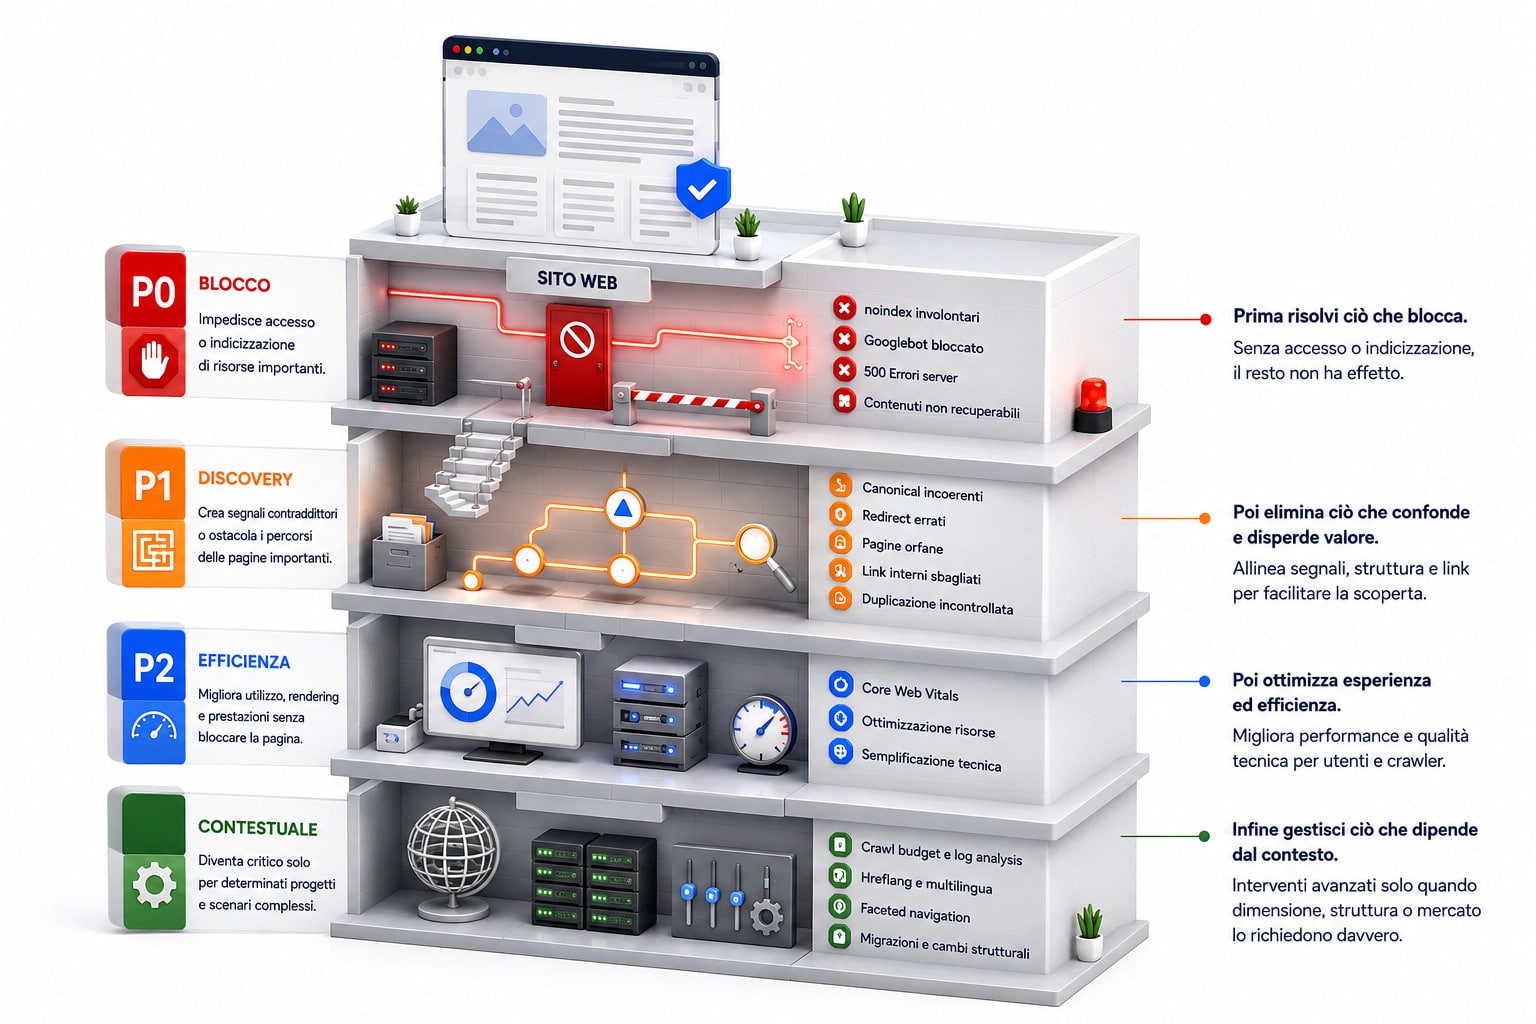
Questa è la parte di un audit di SEO tecnica in cui una checklist generica mostra i suoi limiti.
Un noindex accidentale sulla principale categoria ecommerce e cinque kilobyte di JavaScript eliminabili non hanno la stessa priorità.
Uso quindi una matrice operativa. Non è una classificazione ufficiale di Google e non è un punteggio di ranking: serve a decidere l’ordine degli interventi.
| Priorità operativa | Tipo di problema | Esempi | Decisione |
| P0 — blocco | Impedisce accesso o indicizzazione di risorse che dovrebbero essere visibili | noindex involontario, Googlebot bloccato, errori server persistenti, contenuto principale irrecuperabile | Correggere prima |
| P1 — consolidamento e discovery | Crea segnali contraddittori o ostacola percorsi importanti | canonical incoerenti, redirect errati, pagine orfane, link interni sbagliati, duplicazione incontrollata | Alta priorità |
| P2 — esperienza ed efficienza | Migliora utilizzo, rendering o prestazioni senza bloccare completamente la pagina | Core Web Vitals, ottimizzazione delle risorse, semplificazione tecnica | Valutare impatto e scala |
| Contestuale | Diventa critico solo per determinati progetti | crawl budget, log analysis approfondita, hreflang, faceted navigation, migrazioni | Priorità in base al sito |
Questa gerarchia evita uno degli errori più comuni degli audit automatici: trattare la quantità di warning come se coincidesse con la gravità del problema.
Un report con 5.000 segnalazioni può contenere un problema sistemico replicato su 5.000 URL. Un report con un solo errore può invece riguardare la pagina che genera gran parte del fatturato.
Il conteggio viene dopo l’impatto.
Robots.txt, noindex, canonical e sitemap: quale usare per quale problema
Quattro strumenti vengono spesso confusi perché tutti sembrano dire qualcosa a Google sugli URL. In realtà rispondono a domande differenti.
| Obiettivo | Strumento principale | Cosa fa | Cosa non fa |
| Limitare il crawling | robots.txt | Regola l’accesso del crawler | Non è un metodo affidabile per rimuovere una pagina dalla Ricerca |
| Impedire l’indicizzazione | noindex | Dice ai motori compatibili di non indicizzare la risorsa | Richiede che il crawler possa vedere la direttiva |
| Consolidare versioni equivalenti | canonicalizzazione | Esprime la versione preferita fra URL duplicati/simili | Non obbliga Google a scegliere quella URL |
| Facilitare discovery e aggiornamenti | sitemap | Elenca URL che consideri importanti | Non garantisce crawling, indexing o ranking |
Le differenze fra robots e noindex sono documentate esplicitamente da Google.
La canonicalizzazione è invece un processo in cui Google considera più segnali e può scegliere una versione diversa da quella indicata dal sito.
La decisione pratica diventa molto più semplice quando parti dall’obiettivo.
Se vuoi che una pagina sparisca dall’indice, non partire da robots.txt. Se hai due URL equivalenti che devono restare accessibili, non usare noindex senza prima chiederti quale relazione vuoi costruire fra loro. Se vuoi far conoscere URL importanti, la sitemap può aiutare, ma non sostituisce i link interni.
Come fare un’analisi SEO tecnica passo dopo passo
Un audit di SEO tecnica efficace dovrebbe partire dal sito reale e dalle domande che devi risolvere, non dal numero di controlli offerti dal software.
Definisci quali URL dovrebbero essere trovati e indicizzati
Prima ancora di avviare un crawler, costruisci un inventario logico.
Quali template devono generare pagine organiche? Quali categorie devono essere indicizzate? Quali filtri sono semplici strumenti di navigazione? Quali pagine sono state rimosse? Quali URL sono duplicati intenzionali e quali accidentali?
Senza questa fase, il crawler può dirti che esistono 30.000 URL, ma non può decidere autonomamente quali dei 30.000 dovrebbero esistere nell’indice.
È la differenza fra raccolta dati e diagnosi.
Verifica Search Console e il comportamento osservato da Google
Search Console deve entrare presto nell’analisi perché risponde a una domanda diversa da quella di un crawler di terze parti: mostra informazioni provenienti dai sistemi Google.
Per una singola pagina, lo strumento Controllo URL di Google Search Console permette di verificare lo stato indicizzato, l’indicizzabilità, la canonical selezionata da Google e una versione renderizzata della pagina.
Questo rende possibile confrontare tre livelli:
come pensi che la pagina sia configurata → cosa mostra il crawler → cosa Google dichiara di aver elaborato
Le divergenze fra questi livelli sono spesso più interessanti del singolo warning.
Esegui un crawl e confrontalo con l’inventario reale
Un crawler tecnico è estremamente utile per ricostruire struttura, status code, title, canonical, direttive, link, profondità e numerosi altri segnali.
Creativemotions ha una guida specifica a Screaming Frog se vuoi approfondire l’utilizzo dello spider.
Il limite da ricordare è però importante: un crawler SEO non è Googlebot.
Sta simulando una scansione secondo la configurazione che gli hai dato. Non conosce le decisioni interne di Google, la sua domanda di crawling o tutti i segnali utilizzati per indicizzazione e ranking.
Per questo non userei mai la formula “Screaming Frog dice che la pagina è indicizzabile, quindi Google la indicizzerà”.
Il dato corretto è più limitato: il crawler non ha individuato, nel proprio test, un blocco che renda la pagina non indicizzabile.
Controlla rendering, canonical e segnali contraddittori
Una pagina dovrebbe essere analizzata come sistema.
Controlla la risposta HTML iniziale, ciò che appare dopo il rendering, il canonical dichiarato, le direttive robots, i link, lo status HTTP e la sitemap.
Quando questi elementi sono coerenti, la diagnosi è relativamente semplice.
Quando non lo sono, la domanda da fare è: quale versione e quale comportamento sto realmente suggerendo al motore?
Nei siti JavaScript questo controllo diventa particolarmente importante perché canonical o contenuti generati dinamicamente possono apparire in momenti diversi del processo. Google raccomanda di mantenere segnali di canonicalizzazione chiari e coerenti anche nelle implementazioni JavaScript.
Misura le performance senza trasformare Lighthouse in un ranking score
PageSpeed Insights, Lighthouse e Search Console possono mostrare prospettive differenti sulle prestazioni.
Il dato di campo descrive esperienze realmente misurate su utenti Chrome idonei; il dato di laboratorio simula invece determinate condizioni. Entrambi sono utili, ma rispondono a domande diverse.
In un audit partirei quindi dal problema concreto: la pagina è lenta per gli utenti reali? Il template presenta un collo di bottiglia ripetuto? È un problema di server, immagini, JavaScript, font, CSS o priorità delle risorse?
Solo dopo sceglierei l’intervento.
Il punteggio sintetico dello strumento viene dopo la causa.
Usa i log server quando possono rispondere a una domanda reale
La log analysis è una delle tecniche più potenti della SEO tecnica avanzata perché permette di osservare le richieste realmente arrivate al server.
Ma non è obbligatoria in ogni audit.
Diventa particolarmente utile quando vuoi capire quali sezioni Googlebot sta visitando, con quale frequenza, quali status incontra e quanto crawling viene consumato da famiglie di URL poco utili.
Su un piccolo sito con poche centinaia di pagine e nessun problema di scansione evidente, aprire un progetto di log analysis può avere meno valore di risolvere prima un problema di architettura già visibile.
Correggi, valida e misura nuovamente
L’audit non termina quando viene prodotto un PDF.
Una correzione tecnica deve essere implementata, testata e poi verificata sul sito pubblicato.
Se rimuovi un noindex, controlla che sia realmente scomparso dalla risposta finale. Se modifichi canonical e link interni, verifica che i segnali siano allineati. Se sistemi un redirect, assicurati che il nuovo percorso funzioni e che i link interni puntino direttamente alla destinazione.
Quando il problema è su una singola URL importante, Controllo URL permette anche di testare la versione pubblicata e richiedere una nuova indicizzazione, fermo restando che la richiesta non ne garantisce l’inclusione nell’indice.
Se vuoi trasformare questa procedura in un’analisi professionale dell’intero sito, la pagina dedicata all’audit SEO descrive il servizio Creativemotions.
Strumenti per la SEO tecnica: cosa mostrano e cosa non possono dirti
Non esiste un singolo software capace di dirti “la SEO tecnica del sito è corretta”.
Gli strumenti di SEO tecnica osservano parti differenti dello stesso sistema.
| Strumento | Utile soprattutto per | Limite da ricordare |
| Google Search Console | indicizzazione, segnali osservati da Google, performance organica | non sostituisce un crawl completo |
| Controllo URL | diagnosi della singola pagina e rendering | non rappresenta ogni decisione futura di ranking |
| Screaming Frog | crawl tecnico, link, status, canonical, direttive, architettura | simula un crawler, non replica Googlebot |
| PageSpeed Insights | dati di campo e laboratorio sulle performance | non è un audit SEO generale |
| Lighthouse | diagnosi di performance e qualità tecnica in ambiente di laboratorio | il punteggio non è un ranking score |
| Rich Results Test | validazione delle implementazioni supportate per risultati avanzati | markup valido non garantisce la comparsa della feature |
| Log server | richieste realmente ricevute dal server | richiede interpretazione e spesso molto volume di dati |
La scelta dello strumento dovrebbe quindi seguire la domanda.
Se vuoi sapere quale canonical Google ha selezionato per una pagina, usa una fonte Google come Controllo URL. Se vuoi mappare 50.000 collegamenti interni, uno spider è più efficiente. Se vuoi sapere quali URL Googlebot sta realmente richiedendo al server, i log diventano la fonte appropriata.
Tool diverso → evidenza diversa.
Quando la SEO tecnica diventa davvero avanzata
Sul piano della SEO tecnica, molti siti possono risolvere gran parte dei problemi lavorando correttamente su crawling, indicizzazione, architettura, redirect, canonical e performance.
Altri progetti hanno una complessità strutturale che cambia completamente la diagnosi.
Crawl budget nei siti grandi o molto dinamici
Il crawl budget è uno dei concetti più sovrautilizzati della technical SEO.
Google presenta la propria guida alla gestione del crawl budget come avanzata e destinata soprattutto a siti molto grandi, a siti con oltre circa diecimila pagine che cambiano quotidianamente o a progetti con una quantità significativa di URL segnalati come scoperti ma non indicizzati. Precisa inoltre che le soglie sono approssimative, non regole rigide.
Quindi non ottimizzerei il crawl budget per default su ogni sito.
Su un blog relativamente contenuto in cui le nuove pagine vengono normalmente scansionate senza difficoltà, è spesso più utile mantenere una sitemap aggiornata e controllare i problemi reali di indicizzazione.
Se invece gestisci centinaia di migliaia di combinazioni di filtri e URL, il problema può cambiare radicalmente. La guida sul crawl budget approfondisce proprio questi scenari.
Ecommerce e faceted navigation
Filtri per colore, taglia, prezzo, marca, disponibilità e ordinamento possono produrre una quantità enorme di combinazioni URL.
Non esiste una soluzione universale del tipo “metti canonical su tutti i filtri”.
Alcune combinazioni possono soddisfare una reale domanda di ricerca; altre hanno soltanto funzione di navigazione; altre ancora duplicano quasi completamente categorie esistenti.
Prima della soluzione tecnica serve quindi una decisione di ownership:
quali pagine meritano di esistere come landing organiche?
Solo dopo puoi progettare link, crawling, canonicalizzazione e indicizzazione in modo coerente.
Siti JavaScript complessi
SPA, rendering client-side, componenti dinamici e routing JavaScript richiedono attenzione quando influenzano contenuto, URL e collegamenti.
Il controllo non dovrebbe fermarsi alla frase “Google esegue JavaScript”.
Devi verificare il risultato.
Google indica esplicitamente che, se un contenuto non è presente nell’HTML renderizzato che riesce a elaborare, non può indicizzarlo.
Questa è una delle situazioni in cui Controllo URL, rendering e confronto fra HTML iniziale e DOM elaborato diventano particolarmente utili.
Siti multilingua e hreflang
hreflang serve a indicare relazioni fra versioni linguistiche o regionali di una pagina.
Nelle linee guida sulle versioni localizzate delle pagine, Google supporta implementazioni tramite HTML, intestazioni HTTP o sitemap e considera i tre metodi equivalenti dal punto di vista della Ricerca. Usarli contemporaneamente non fornisce un vantaggio aggiuntivo e può aumentare la complessità di manutenzione.
Un errore comune è trattare hreflang come se decidesse automaticamente la lingua della pagina. Google specifica invece che utilizza i propri sistemi per determinarla.
In progetti internazionali la sfida è quindi mantenere URL, canonical e varianti linguistiche coerenti, non accumulare tag.
Migrazioni e modifiche strutturali
Una migrazione concentra nello stesso momento molti elementi tecnici: URL, redirect, canonical, sitemap, link interni, template, rendering e infrastruttura.
È proprio il tipo di progetto in cui gli errori piccoli possono moltiplicarsi rapidamente.
Qui la strategia più sicura non è “sistemiamo dopo ciò che Google segnalerà”, ma preparare una corrispondenza fra vecchi e nuovi URL, aggiornare i collegamenti interni e testare l’ambiente prima del passaggio definitivo. Anche le indicazioni ufficiali di Google per le migrazioni con modifica degli URL insistono sulla preparazione della mappatura e dei redirect prima dello spostamento.
La SEO tecnica, in questo scenario, diventa soprattutto gestione controllata del cambiamento.
SEO tecnica e ricerca con AI: cosa cambia davvero
AI Overview e AI Mode non cancellano le fondamenta tecniche della Ricerca.
Nella propria guida all’ottimizzazione per le funzionalità di AI generativa nella Ricerca, Google ha chiarito che le normali best practice SEO continuano a essere pertinenti anche per AI Overview e AI Mode e che una pagina deve comunque essere indicizzata e idonea a comparire nella Ricerca. La documentazione ribadisce inoltre crawling, JavaScript SEO, duplicati e page experience come elementi tecnici da gestire normalmente.
Questo ridimensiona parecchio l’idea che serva una nuova “SEO tecnica per l’AI” completamente separata.
Per Google non serve costruire file speciali o markup inventati esclusivamente per AI Overview. Serve soprattutto assicurarsi che i sistemi possano accedere ai contenuti e che il sito continui a rispettare le normali basi tecniche.
In altre parole:
una pagina che Google non riesce a recuperare o indicizzare non diventa improvvisamente più accessibile perché la ricerca utilizza l’AI.
Le superfici cambiano. Le fondamenta restano.
Checklist SEO tecnica: controlli essenziali e controlli contestuali
- Verifica che le pagine organiche importanti restituiscano lo status HTTP corretto e siano accessibili a Googlebot.
- Controlla che
robots.txt, meta robots e X-Robots-Tag non introducano blocchi involontari. - Confronta le pagine che vuoi indicizzare con ciò che Search Console mostra realmente.
- Verifica canonical dichiarati, canonical selezionati da Google e coerenza dei segnali interni.
- Controlla che sitemap e link interni puntino alle versioni corrette degli URL.
- Individua pagine orfane, redirect interni, catene, errori e percorsi incoerenti.
- Verifica il rendering quando JavaScript genera contenuti, link o informazioni essenziali.
- Controlla Core Web Vitals e performance dando priorità ai problemi reali degli utenti, non al punteggio perfetto.
- Implementa dati strutturati soltanto quando esiste una feature pertinente e il markup rappresenta il contenuto visibile.
- Nei siti multilingua, valida reciprocità e coerenza delle implementazioni
hreflang. - Analizza crawl budget e log in profondità quando dimensione, frequenza di aggiornamento o problemi di scansione lo giustificano.
- Dopo ogni intervento importante, verifica nuovamente il comportamento della versione pubblicata.
La checklist funziona solo se la leggi in questo ordine: prima ciò che può impedire alla pagina di essere elaborata, poi ciò che consolida i segnali, infine ciò che migliora efficienza ed esperienza.
Non partirei mai dall’errore più facile da correggere soltanto perché il software lo mette in cima al report.
Conclusione
La SEO tecnica non è la disciplina che “convince Google a premiare un sito”. È il lavoro che elimina gli ostacoli fra il contenuto e i sistemi che devono scoprirlo, recuperarlo, elaborarlo e inserirlo correttamente nel contesto della ricerca.
La priorità più importante è distinguere le fasi.
Se Googlebot non può accedere a una pagina che dovrebbe posizionarsi, risolvi l’accesso. Se la pagina è accessibile ma esclusa dall’indice, indaga l’indicizzazione. Se esistono versioni duplicate e segnali incoerenti, lavora sulla canonicalizzazione e sull’architettura. Se tutto questo funziona, puoi affrontare performance, enhancement e ottimizzazioni più sofisticate con un criterio molto più solido.
E soprattutto, non trasformare ogni sito in un progetto enterprise.
Crawl budget, log analysis avanzata, faceted navigation e JavaScript SEO possono essere decisivi quando il contesto li rende tali. Su altri siti il risultato migliore arriva invece correggendo poche fondamenta: status corretti, pagine accessibili, architettura chiara, direttive coerenti e contenuti realmente indicizzabili.
È questo il principio che rende utile un audit tecnico: non trovare il maggior numero possibile di errori, ma capire quali errori stanno realmente limitando il sito e in quale ordine vale la pena risolverli.