
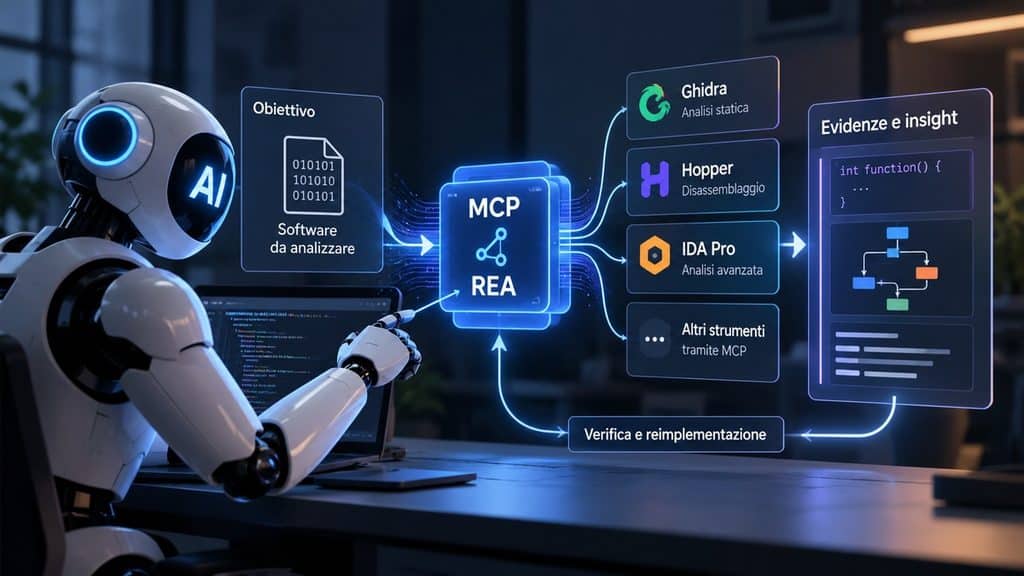
Reverse Engineer Anything, abbreviato REA, è un progetto open source che collega un coding agent a strumenti di analisi software e gli permette di indagare come funziona un programma partendo dal software distribuito, non necessariamente dal suo codice sorgente. REA agisce come strato operativo tra l’agente e gli strumenti di analisi: rende interrogabili binari, applicazioni JavaScript ed Electron, assembly .NET, APK, siti web e altri target e restituisce evidenze che l’agente può usare nel proprio lavoro.
Il progetto si muove molto velocemente. Al 28 ottobre 2026, la release più recente verificata è rea-agents 6.8.0, pubblicata il 25 ottobre. Le versioni 6.x hanno ampliato in poche settimane target, provider e workflow, fino a includere anche la costruzione di ambienti locali derivati da catture di rete e scenari browser. Per questo una guida utile deve separare ciò che è strutturale da requisiti e feature che possono cambiare rapidamente.
La domanda più interessante, quindi, non è se REA “possa clonare qualunque software”. È capire come funziona REA, quali prove può realmente recuperare, dove entra l’AI e dove restano necessari competenza tecnica, verifica e autorizzazione. È su questa distinzione che il reverse engineering con AI diventa uno strumento serio invece di una promessa virale.
Cos’è Reverse Engineer Anything e perché se ne parla adesso
REA porta un cambiamento pratico nel modo in cui un agente AI può lavorare su software già compilato o distribuito. Prima un modello poteva ragionare sul codice che gli fornivi, suggerire comandi o commentare l’output di un decompilatore. Con REA, invece, l’agente può usare un’interfaccia strutturata per richiedere direttamente analisi, seguire riferimenti, recuperare pseudocodice o osservazioni di runtime e decidere quale domanda porre dopo.
Questo spiega anche perché il progetto abbia attirato attenzione oltre la nicchia del reverse engineering. La SERP italiana di ottobre 2026 è piena di titoli su app “smontate” dall’AI, software ricostruiti e timori di cloni. Hardware Upgrade e Tom’s Hardware hanno raccontato il fenomeno mettendo REA in relazione con Ghidra, Hopper, IDA e coding agent; Agenda Digitale ha invece evidenziato che l’equazione “AI + reverse engineering = copia legale del software” è troppo semplicistica.
REA non è un modello AI e non è un decompilatore
Il modo più utile per capire come funziona REA è separare i livelli.
Il primo livello è il coding agent. Può essere, per esempio, Claude Code, Cursor, Gemini CLI oppure OpenAI Codex. L’agente riceve l’obiettivo, decide quali strumenti usare, legge i risultati e porta avanti il ciclo di indagine.
Il secondo livello è REA, che espone all’agente i workflow e gli strumenti di reverse engineering. Il progetto usa MCP per questa integrazione: non sostituisce il modello né l’applicazione agentica, ma rende disponibili capacità di analisi in una forma che l’agente può chiamare. Se vuoi capire quel livello di interoperabilità senza confonderlo con l’intelligenza dell’agente, nella guida agli MCP Server trovi la distinzione tra host, client, server e sistema sottostante.
Il terzo livello è costituito dai motori e dai provider che fanno l’analisi concreta. Per i binari nativi REA può appoggiarsi a strumenti come Hopper, Ghidra o IDA; per JavaScript ed Electron dispone invece anche di analisi statica che non richiede un motore nativo. La documentazione ufficiale è esplicita su questo punto: REA collega l’agente agli strumenti e restituisce evidenze, ma non trasforma un LLM in un decompilatore universale.
Questa distinzione è importante anche rispetto alla categoria più ampia degli agenti AI. L’autonomia non nasce da REA in sé: nasce dal ciclo in cui l’agente osserva un risultato, decide cosa approfondire, invoca un altro strumento e aggiorna la propria ipotesi.
Cosa cambia rispetto al reverse engineering tradizionale
Il reverse engineering tradizionale non consiste semplicemente nell’aprire un eseguibile e premere “decompila”. Un analista deve individuare entry point, stringhe, funzioni interessanti, call graph, dati, dipendenze e comportamenti; deve distinguere ciò che il tool ha ricostruito da ciò che è ancora un’ipotesi e spesso deve tornare più volte sugli stessi punti.
REA prova a spostare parte di questo lavoro di navigazione dentro un loop agentico. L’agente può chiedere dove viene gestito un certo comportamento, ricevere funzioni e riferimenti, approfondire una chiamata, confrontare un risultato con un’altra evidenza e arrivare a una spiegazione o a un’implementazione di prova. Il progetto ufficiale descrive proprio questo ciclo: l’agente interroga REA tramite MCP, REA restituisce risultati con evidenze e l’agente usa quei risultati per porre domande successive, spiegare il comportamento oppure scrivere e testare un’implementazione.
Il vantaggio potenziale non è quindi “l’AI conosce il binario”. È ridurre il costo operativo di esplorazione e correlazione delle evidenze, soprattutto quando la domanda è ben circoscritta. Questo può rendere accessibili attività prima molto lente, ma non elimina gli errori del decompilatore, le assunzioni del modello o la necessità di conoscere abbastanza il dominio da capire quando una ricostruzione non torna.
Perché la storia dei “cloni software con l’AI” è solo una parte del fenomeno
Il termine “clone” mescola almeno tre operazioni diverse: capire una funzionalità, riprodurne il comportamento e ricostruire un intero prodotto. REA è soprattutto interessante nei primi due passaggi, perché può aiutare l’agente a raccogliere prove su una funzione e a trasformarle in una specifica o in una reimplementazione da verificare. Estendere lo stesso risultato a un prodotto intero è un problema di scala, copertura e validazione molto diverso.
Anche i casi pubblicati dal progetto vanno letti in questa chiave. Nel caso DX-Ball viene ricostruita una specifica funzione di sound pan e confrontata con l’implementazione originale; nel caso Notion viene seguito il percorso della clipboard attraverso i componenti Electron. Sono esempi di ricostruzione verificabile di comportamenti circoscritti, non una dimostrazione che un’applicazione complessa possa essere clonata automaticamente da un singolo prompt.
Come funziona REA: agente AI, MCP e strumenti di reverse engineering
Il modello mentale più corretto per capire Reverse Engineer Anything è una catena: obiettivo → agente → REA → strumento di analisi → evidenze → agente → verifica. Il valore di REA sta nel rendere questa catena abbastanza strutturata da permettere all’agente di chiedere informazioni specifiche e ricevere risultati con contesto, riferimenti e limiti, invece di lavorare su un dump casuale incollato nella chat.
È anche il motivo per cui conviene distinguere l’architettura dal modello usato. Cambiare LLM può modificare la qualità dell’interpretazione; cambiare provider di reverse engineering può modificare il tipo o la qualità dell’evidenza disponibile. REA si trova in mezzo e coordina i due mondi.
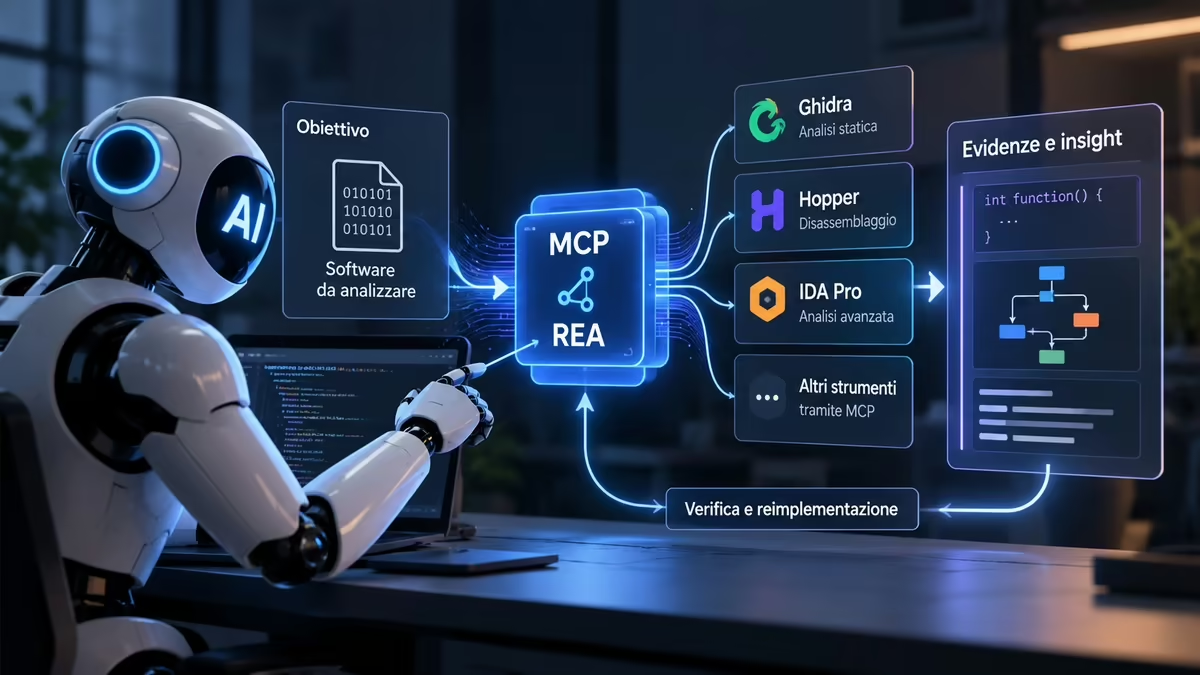
Il flusso dall’obiettivo alle evidenze
Il sito ufficiale del progetto sintetizza il meccanismo in tre momenti: l’agente formula una richiesta, REA interroga il programma o il provider appropriato e restituisce codice, riferimenti o osservazioni di runtime; l’agente usa poi quel risultato per scegliere l’analisi successiva o passare a una possibile reimplementazione.
La caratteristica utile è che l’output resta collegato all’artefatto analizzato. Funzioni, riferimenti, istruzioni, file, catture e osservazioni di runtime diventano punti su cui l’agente può tornare durante l’indagine, invece di lavorare su una descrizione astratta del software. Le regole per trasformare queste evidenze in un workflow verificabile vengono affrontate più avanti, nella sezione dedicata all’uso operativo.
Il ruolo di Ghidra, Hopper, IDA e degli altri provider
Per i binari nativi, REA può usare un motore di analisi esistente. La documentazione corrente elenca Hopper, Ghidra e IDA come provider principali per ottenere pseudocodice, assembly, stringhe, simboli, chiamate e riferimenti. Sono strumenti che già svolgono il lavoro di disassemblaggio e decompilazione; REA aggiunge un livello attraverso cui l’agente può interrogarli e mantenere il filo dell’indagine.
Questo significa che la qualità della risposta dipende anche dalla qualità dell’analisi sottostante. Un decompilatore può ricostruire una rappresentazione leggibile, ma nomi originali, tipi, commenti, macro e struttura architetturale possono essere parzialmente o completamente persi nella compilazione. L’agente non può recuperare informazioni che non sono più presenti solo perché sa fare domande in linguaggio naturale.
REA, inoltre, non è limitato a questi tre strumenti. La release corrente documenta provider e ispezioni specializzate per vari formati; alcune analisi sono integrate, altre dipendono da tool installati dall’utente. Questa modularità è un vantaggio, ma rende sbagliato parlare di “compatibilità universale”: ogni target ha prerequisiti e limiti propri.
Cosa fa l’agente AI sopra i risultati di REA
Il coding agent svolge il lavoro di coordinamento e interpretazione. Decide quale strumento interrogare, collega i risultati ottenuti e stabilisce se serva un’altra analisi oppure se ci siano elementi sufficienti per passare alla spiegazione o alla scrittura di codice.
Questo è il passaggio che avvicina REA agli strumenti di coding agentico, ma non va confuso con il vibe coding. Nel vibe coding il punto di partenza può essere una specifica espressa in linguaggio naturale e il software viene generato progressivamente. Con REA, invece, l’agente parte da un artefatto o un comportamento esistente che deve essere compreso attraverso evidenze. I due flussi possono incontrarsi nella fase di implementazione, ma arrivano a quel punto da direzioni diverse.
Cosa resta locale e quali dati possono raggiungere il provider del modello
REA dichiara che l’analisi del target viene eseguita localmente. Questo non equivale però a dire che “tutto resta sul computer”. I risultati degli strumenti vengono consegnati all’agente e il modello usato dall’agente può essere gestito da un provider esterno con proprie politiche su dati, logging e retention. La FAQ ufficiale fa esattamente questa distinzione.
Per un progetto personale la differenza può sembrare secondaria; in azienda è un requisito di architettura. Un binario proprietario potrebbe restare locale mentre pseudocodice, stringhe, nomi di funzioni o frammenti di configurazione arrivano al servizio del modello. Prima di usare REA su software confidenziale bisogna quindi valutare non solo dove gira il decompilatore, ma l’intero percorso dei dati fino al modello.
La stessa cautela vale per credenziali, file di configurazione e catture di rete. “Analisi locale” descrive il luogo in cui REA esegue determinati tool; non sostituisce una data-flow review del coding agent e del provider scelto.
Cosa può analizzare Reverse Engineer Anything
La superficie di REA è ormai molto più ampia dei soli eseguibili desktop. Il README corrente distingue target, tipo di evidenza restituita e requisiti necessari. Questa distinzione è utile perché impedisce di trattare un APK Android, un’app Electron, un firmware e un binario nativo come se fossero lo stesso problema tecnico.
La tabella seguente sintetizza le categorie più rilevanti senza trasformare l’inventario ufficiale, che cambia rapidamente, in una lista destinata a invecchiare.
| Target | Evidenze tipiche | Dipendenze principali |
|---|---|---|
| Binari nativi | pseudocodice, assembly, stringhe, simboli, chiamate, riferimenti | Hopper, Ghidra o IDA per l’analisi profonda |
| JavaScript / Electron | moduli, import, route, IPC, relazioni tra bundle | analisi statica REA; non richiede un decompilatore nativo |
| .NET e formati gestiti | metadati, tipi, metodi e relazioni disponibili nell’artefatto | dipende dal formato e dal workflow |
| APK / Android | manifest, risorse, componenti e altri artefatti analizzabili | tool Android specifici quando necessari |
| Browser e siti web | script caricati, struttura e osservazioni di runtime/rete | connessione browser o catture controllate |
| Firmware, archivi e formati specializzati | struttura, componenti, metadati e artefatti estratti | dipende dal formato e dai provider disponibili |
Binari nativi e librerie
È il caso più vicino all’immagine classica del reverse engineering. Un eseguibile PE, ELF o Mach-O contiene codice macchina, dati, metadati e strutture che un analista cerca di trasformare in un modello comprensibile.
REA può chiedere al provider di analisi funzioni specifiche, recuperare pseudocodice o assembly, cercare stringhe e riferimenti, seguire call relationship e raccogliere evidenze attorno a un comportamento. Il risultato migliore non è necessariamente “una versione C perfetta” della funzione, ma un insieme di indizi sufficienti a stabilire cosa fa e come verificarlo.
Per questo la scelta del provider conta. Formati, architetture e supporto host variano; la documentazione ufficiale rimanda a guide separate per Hopper, Ghidra, IDA e altri strumenti.
Applicazioni JavaScript ed Electron
JavaScript ed Electron sono diversi perché buona parte della logica può rimanere in una forma molto più vicina al codice applicativo rispetto a un binario nativo. Un’app Electron può contenere bundle, moduli, preload script, route, canali IPC e dipendenze native che REA può mappare senza avviare un decompilatore nativo.
Il progetto mostra questo approccio nel caso Notion: l’indagine segue la clipboard dal renderer al preload e quindi al processo principale attraverso il canale IPC. Qui il valore non è “decompilare” nel senso tradizionale, ma ricostruire il percorso di una funzionalità attraverso più componenti.
Questa categoria è anche un buon esempio di perché la parola reverse engineering sia più ampia della decompilazione. A volte la domanda è trovare un algoritmo in assembly; altre volte è capire come un evento passa tra moduli già relativamente leggibili.
APK, .NET, firmware, siti web e altri target
Il README corrente include molte altre famiglie: Android, assembly .NET, formati di firmware, database SQLite, WebAssembly, artefatti di modelli, binari Go e Rust, catture di processo e altre sorgenti di evidenza. Le release 6.x hanno continuato ad aggiungere copertura e modalità di ispezione.
Non significa che REA disponga dello stesso livello di profondità per ogni elemento. Alcuni target vengono analizzati con parser integrati, altri richiedono software esterno, altri ancora permettono soprattutto triage, metadati o osservazioni di runtime. La domanda corretta non è quindi “REA supporta questo file?”, ma:
quale evidenza può ottenere da questo target, con quale provider e con quali limiti?
Questa formula evita un errore frequente nelle guide ai tool AI: scambiare la presenza di un formato nella documentazione per la capacità di ricostruirne automaticamente tutta la semantica.
Cosa restituisce realmente: pseudocodice, assembly, riferimenti ed evidenze
Un output di reverse engineering può trovarsi a diversi livelli di astrazione. L’assembly è vicino alle istruzioni effettivamente eseguite; il pseudocodice tenta di renderle più leggibili; stringhe e riferimenti aiutano a trovare punti di interesse; metadati e grafi aiutano a capire relazioni; le osservazioni di runtime mostrano cosa è accaduto in una determinata esecuzione.
Nessuno di questi elementi, preso isolatamente, equivale alla “verità completa” sul programma. Un riferimento può suggerire una relazione senza dimostrare quando viene eseguita. Il pseudocodice può rendere leggibile una funzione ma perdere semantica originaria. Una cattura runtime dimostra ciò che è successo in quel test, non tutti i percorsi possibili.
Il valore di REA sta quindi soprattutto nella possibilità di comporre evidenze eterogenee e mantenere visibile il limite di ciascuna. È una prospettiva meno spettacolare del “clona qualsiasi app”, ma è anche molto più vicina a come funziona un’indagine tecnica affidabile.
Cosa REA può ricostruire e cosa invece non può recuperare
Con Reverse Engineer Anything, la distinzione più importante è tra recuperare informazioni, inferire un comportamento e ricreare un’implementazione. Se questi tre passaggi vengono compressi in uno solo, qualunque demo convincente rischia di sembrare più potente di ciò che dimostra davvero.
REA può rendere molto più rapido il percorso dall’artefatto finito a una spiegazione verificabile. Non può però annullare la perdita di informazione introdotta dalla compilazione, rendere visibile ciò che esiste soltanto su un server remoto o concedere diritti su codice e asset di terzi.
Perché il pseudocodice non è il sorgente originale
Quando un programma nativo viene compilato, molte informazioni utili allo sviluppatore non devono necessariamente sopravvivere nel binario. Commenti, nomi descrittivi delle variabili, struttura originale dei file, alcuni tipi, macro e scelte sintattiche possono scomparire o essere trasformati dalle ottimizzazioni del compilatore.
Un decompilatore lavora quindi al contrario: parte dalle istruzioni e prova a produrre una rappresentazione ad alto livello semanticamente utile. È una ricostruzione, non un viaggio nel tempo.
La documentazione di REA è prudente: per l’analisi nativa parla di pseudocodice e assembly, non di “codice sorgente originale recuperato”.
Questa differenza ha una conseguenza pratica. Se l’agente produce una funzione elegante con nomi chiari, non devi assumere che quei nomi o quella struttura esistessero nel progetto originario. Possono essere una normalizzazione del decompilatore o una scelta dell’AI per rendere comprensibile ciò che ha inferito.
Ricostruire una funzione non significa clonare un’intera applicazione
Una funzionalità circoscritta può avere pochi input, una logica riconoscibile e un criterio di verifica netto. Un’applicazione completa contiene invece interfaccia, stato, storage, servizi remoti, aggiornamenti, formati, autenticazione, telemetria, error handling, edge case, dipendenze, asset e anni di decisioni accumulate.
La complessità non cresce soltanto perché aumentano le righe di codice. Cresce perché aumentano le relazioni che devono essere comprese e verificate.
Gli studi recenti sugli agenti di reverse engineering confermano che la scala resta un problema. Un confronto del 2026 tra analisti umani e agenti LLM ha trovato modelli di frontiera competitivi su due task compatti, ma ha anche osservato una strategia agentica molto orientata a recuperare grandi quantità di informazioni e un rapido consumo della context window sui binari più grandi. Gli autori concludono che scalare richiede navigazione migliore, retrieval selettivo e stato persistente, non semplicemente finestre di contesto più grandi.
La domanda “può ricostruire questa funzione?” e “può sostituire questa suite software?” appartengono quindi a ordini di grandezza differenti.
Comportamento, implementazione e asset: tre cose diverse
Supponiamo di osservare che un programma, dato lo stesso input, produce sempre lo stesso output. Possiamo descrivere quel comportamento. Se capiamo la regola che lo produce, possiamo scrivere una nostra implementazione. Ma il prodotto originale comprende anche espressioni e asset: codice, testi, immagini, suoni, manuali, layout e altri elementi che possono avere tutele autonome.
È qui che la discussione tecnica incontra quella giuridica. Una cosa è capire un’idea o una funzionalità; un’altra è copiare la forma espressiva del codice o materiali protetti. La Corte di giustizia dell’Unione europea, nella causa SAS Institute contro World Programming, ha chiarito che la funzionalità di un programma, il linguaggio di programmazione e il formato dei file di dati usati per sfruttare certe funzioni non costituiscono in quanto tali una forma di espressione protetta dal copyright sui programmi. Questo non rende automaticamente lecita qualunque copia: codice, manuali e altre espressioni creative restano un problema distinto.
Per un progetto serio conviene quindi definire prima che cosa vuoi rendere interoperabile o riprodurre come comportamento e quali elementi, invece, non devono essere copiati.
Come installare e configurare REA
Installare Reverse Engineer Anything è semplice soltanto se si separa il setup dalla configurazione del motore di analisi. REA può registrare il proprio server MCP e le istruzioni del workflow nel coding agent, ma il target che vuoi analizzare determina quali dipendenze aggiuntive servono.
Inoltre, i requisiti stanno cambiando rapidamente. Le versioni di Node.js indicate da articoli pubblicati anche pochi giorni prima possono essere già superate. I valori che seguono sono quelli verificati nella documentazione ufficiale di installazione il 28 ottobre 2026 e vanno ricontrollati prima della pubblicazione o di un futuro aggiornamento.
Requisiti e release corrente
La documentazione corrente richiede Node.js 22.x da 22.23.4, Node.js 24.x da 24.22.1 oppure Node.js 26.12.1 o successivo, insieme a npm. Le dipendenze ulteriori cambiano in base al target.
La release più recente verificata è rea-agents 6.8.0 del 25 ottobre 2026. La velocità delle release è già un motivo sufficiente per evitare tutorial che presentano una versione come se fosse definitiva.
C’è anche un punto di sicurezza da non trascurare: il README ufficiale invita a installare REA soltanto dal repository morluto/rea, dal sito ufficiale rea.tools o dal pacchetto npm rea-agents. La SERP contiene numerosi domini e repository con nomi molto simili; un README copiato non rende ufficiale una distribuzione.
Collegare REA a un coding agent
Il setup ufficiale può essere avviato con <code>npx rea-agents@latest setup</code>. La procedura rileva o permette di selezionare gli agenti, mostra le modifiche proposte e chiede approvazione prima di aggiornare la configurazione; al termine è necessario riavviare l’agente indicato.
Questa fase non “installa l’intelligenza” di REA. Registra l’accesso MCP e le istruzioni che permettono al coding agent di capire quali strumenti ha a disposizione e come inserirli nel proprio workflow.
Tra i client citati dalla documentazione corrente compaiono Claude Code, Codex, Cursor, Gemini CLI e Grok Build. Altri client possono essere registrati manualmente se supportano server MCP locali.
Quando servono Ghidra, Hopper o IDA
Se vuoi analizzare profondamente un binario nativo, REA ha bisogno di un provider adeguato. La documentazione indica Hopper, Ghidra o IDA per questa categoria. Al contrario, l’analisi statica di JavaScript ed Electron e alcuni altri workflow possono funzionare senza un motore di analisi nativo.
Questo cambia anche costi e licenze. REA è distribuito con codice proprio sotto licenza MIT, ma non concede licenze per software di terzi. IDA Pro, Hopper, JEB e altri strumenti commerciali devono essere ottenuti e usati secondo le condizioni dei rispettivi vendor.
La scelta dovrebbe quindi partire dal target, non dall’idea che “più tool collego, meglio è”. Un provider in più aggiunge dipendenze, configurazione e possibili differenze di output. Serve quando produce un’evidenza che il workflow richiede.
Come verificare che l’ambiente sia configurato correttamente
Il controllo più utile non è chiedere all’agente “REA funziona?”. È verificare separatamente registrazione del client, disponibilità del provider e capacità di completare un piccolo task controllato.
La documentazione mette a disposizione la diagnostica <code>rea doctor –json</code> e distingue i readiness check per agenti e motori di analisi. Il setup stesso esegue controlli finali e segnala quali agenti, tool e workflow sono stati verificati.
Per il primo test conviene usare un target piccolo, di cui possiedi il codice o per cui hai autorizzazione, e formulare una domanda con una risposta già verificabile. In questo modo controlli contemporaneamente tre cose: che REA raggiunga lo strumento, che l’agente sappia usare l’evidenza e che la spiegazione finale possa essere confrontata con una ground truth.
Un setup “verde” dimostra che i componenti comunicano. Non dimostra ancora che l’agente sappia fare bene reverse engineering su qualunque progetto.
Come usare REA in un workflow di reverse engineering verificabile
Il modo più robusto di usare REA non è chiedere il risultato finale in un solo passaggio. È costruire un’indagine in cui ogni salto di astrazione resta controllabile. In pratica, l’agente dovrebbe passare da una domanda specifica a evidenze identificabili, quindi da quelle evidenze a un’ipotesi e infine a una verifica indipendente.
Questo approccio riduce due rischi opposti: fermarsi troppo presto a un dump tecnico che nessuno interpreta, oppure lasciare che il modello trasformi alcuni indizi in una spiegazione sicura ma non dimostrata.
Partire da una domanda circoscritta
“Come funziona l’esportazione CSV?”, “dove viene calcolata questa percentuale?” oppure “quale funzione decide il percorso di salvataggio?” sono domande migliori di “spiegami tutta l’applicazione”.
Una domanda circoscritta crea un criterio di completamento. L’agente può cercare un entry point, seguire chiamate, confrontare input e output e dichiarare quando ha evidenza sufficiente. Se l’obiettivo è troppo grande, non esiste un punto naturale in cui smettere di raccogliere contesto.
Gli esempi ufficiali di REA seguono proprio questa logica: il comportamento percentuale di Calculator, la velocità del gioco del dinosauro, il sound pan di DX-Ball, il bridge della clipboard di Notion.
Questo non è un limite artificiale imposto per rendere le demo più facili. È un principio di ricerca: più è chiara la domanda, più è chiaro quale evidenza può confermarla o smentirla.
Separare fatti, inferenze e informazioni ancora sconosciute
Un buon report dovrebbe avere almeno tre stati concettuali.
Fatto: l’evidenza mostra direttamente una certa istruzione, stringa, chiamata, route o comportamento osservato.
Inferenza: più evidenze suggeriscono una spiegazione, ma manca ancora una verifica diretta.
Sconosciuto: l’informazione non è disponibile nel target, non è stata analizzata oppure richiederebbe un’altra fonte.
Questa separazione è particolarmente importante con gli LLM perché il modello è ottimizzato per produrre una risposta coerente. La coerenza linguistica può nascondere il passaggio da ciò che è stato trovato a ciò che sembra plausibile.
REA cerca di ridurre il problema restituendo evidenze e limiti insieme ai risultati, ma la disciplina finale resta nel workflow dell’agente e nella review umana.
Verificare una ricostruzione contro il comportamento originale
Se l’obiettivo è reimplementare una funzione, la verifica dovrebbe essere definita prima di fidarsi del codice generato.
Per una funzione numerica può significare confrontare molti input e output. Per un parser può significare usare fixture note. Per un flusso applicativo può significare registrare lo stesso scenario nell’originale e nella nuova implementazione e confrontare gli effetti osservabili.
Il caso DX-Ball pubblicato da REA mostra bene il principio: la funzione ricostruita non viene dichiarata corretta perché “sembra uguale”, ma viene confrontata con migliaia di casi dell’x86 originale e, per quella funzione specifica, anche con il risultato compilato. È un caso first-party del progetto, non una prova generale sulle prestazioni di REA, ma illustra bene cosa significa chiudere il ciclo con un controllo.
Il test dovrebbe quindi essere trattato come parte del reverse engineering, non come verifica cosmetica da fare alla fine.
Quando fermarsi invece di chiedere all’agente di “clonare tutto”
Ci sono situazioni in cui continuare ad allargare lo scope riduce la qualità invece di aumentarla.
Se una parte fondamentale vive su un backend non disponibile, il client può mostrare soltanto il contratto osservabile. Se un comportamento dipende da dati o servizi proprietari, il binario locale non contiene necessariamente la risposta. Se l’agente continua a saturare il contesto senza convergere, aggiungere altre funzioni può rendere più difficile distinguere le piste utili dal rumore.
Il punto di arresto dovrebbe essere definito dal risultato che vuoi ottenere: una specifica interoperabile, una spiegazione tecnica, una funzione equivalente, un formato compatibile, una diagnosi di sicurezza. Quando quel risultato è supportato da evidenze e test, estendere l’analisi all’intero prodotto può essere soltanto costo aggiuntivo.
È anche un buon confine legale e operativo: l’obiettivo dichiarato determina quali parti è realmente necessario analizzare.
Limiti e rischi del reverse engineering con AI
Il rischio più grande del reverse engineering con AI è trattare l’agente come se fosse un analista infallibile solo perché può invocare strumenti professionali. Tool access e competenza non sono la stessa cosa. REA può migliorare l’accesso all’evidenza; l’interpretazione resta soggetta agli errori del modello, alla qualità del decompilatore, alla copertura del target e al modo in cui l’agente gestisce il proprio contesto.
Nel 2026 stanno arrivando anche benchmark e studi specifici sugli agenti di reverse engineering. Sono ancora lavori recenti, spesso preprint, quindi vanno letti per quello che misurano e non trasformati in verdetti universali.
Errori del modello e interpretazioni sbagliate del codice
Il framework Reveree ha valutato nove modelli su 88 challenge di reverse engineering e non si è limitato a misurare se l’agente catturava la flag: ha analizzato le fasi del processo e il comportamento dell’agente. Gli autori riportano che il modello di base pesa più della strategia di prompting e che molti fallimenti si concentrano proprio nelle fasi di comprensione; più budget o persistenza non recuperano automaticamente questi errori.
La lezione pratica è importante: se l’agente ha costruito un modello mentale sbagliato della funzione, permettergli altre cinquanta chiamate agli strumenti può soltanto produrre più evidenze interpretate attraverso la stessa ipotesi fragile.
Per questo la review umana è più utile nei punti di cambio di ipotesi che alla fine del processo. Conviene controllare presto se l’agente ha identificato la funzione giusta, se sta seguendo il percorso corretto e se le sue conclusioni dipendono da un’unica evidenza ambigua.
Context window e difficoltà dei software grandi
Il già citato studio “Humans vs. Machines” ha osservato che gli agenti forti possono raggiungere una comprensione competitiva con gli umani su task compatti, ma adottano spesso una strategia diversa: recuperano informazioni in modo ampio e tendono a tornare meno sulle funzioni già ispezionate. Gli autori chiamano questo comportamento “greedy fetching”.
Su un programma piccolo può funzionare bene. Su software più grande, accumulare pseudocodice, assembly, stringhe e grafi consuma rapidamente la context window. Il problema non si risolve semplicemente aumentando i token disponibili: serve selezionare meglio cosa mantenere, costruire stato persistente e poter ritornare sulle evidenze senza reinserire ogni volta tutto il programma.
Questo spiega perché “analizza l’intera applicazione” è un prompt debole anche quando tecnicamente possibile. Il collo di bottiglia si sposta dall’accesso agli strumenti alla gestione dell’attenzione dell’agente.
Prompt injection e input costruiti per ingannare gli agenti di analisi
C’è poi un rischio specifico che nel reverse engineering tradizionale non esisteva nello stesso modo: il software analizzato può contenere testo progettato per influenzare il modello.
Due lavori del 2026 hanno studiato prompt injection contro agenti di software reverse engineering. Uno mostra che stringhe inserite nel programma possono apparire nell’output del decompilatore e indurre l’LLM a interpretare male il binario; l’altro esplora sia tecniche di attacco sia metodi di rilevamento e offuscamento di queste istruzioni avversarie.
Il punto non è che qualunque stringa in un binario possa “hackerare” automaticamente REA. È che un agente deve trattare il contenuto del target come dati non attendibili, anche quando quei dati assomigliano a istruzioni in linguaggio naturale.
In un workflow di sicurezza questo cambia il threat model: il campione non è soltanto qualcosa da capire, può tentare di manipolare il sistema che lo sta analizzando. Sandbox, separazione tra dati e istruzioni, limitazione dei tool e approvazioni umane diventano quindi parte dell’ambiente di analisi.
Costi, dipendenze e licenze degli strumenti esterni
REA è open source e il codice del progetto è distribuito sotto licenza MIT, ma questo non rende gratuito l’intero stack.
Un’analisi può coinvolgere:
- un coding agent e il relativo piano o consumo API;
- grandi quantità di contesto, soprattutto sui binari complessi;
- Ghidra, che è open source, oppure tool commerciali come IDA Pro, Hopper o JEB;
- ambienti di test, VM o sandbox;
- tempo umano per verificare risultati e costruire test.
La documentazione di REA specifica inoltre che le licenze dei tool commerciali restano separate e che il progetto non fornisce chiavi, attivazioni o diritti d’uso.
Il costo reale di un workflow non va quindi misurato con “quanto costa REA?”, ma con quanto costa ottenere e verificare l’evidenza necessaria per quel target.
Reverse engineering con AI: cosa è consentito in Italia e nell’Unione Europea
Sul piano giuridico non esiste una risposta universale del tipo “il reverse engineering è legale” o “è vietato”. Contano chi usa il software, quali operazioni compie, per quale scopo, quali informazioni ottiene e come le riutilizza. Inoltre possono entrare in gioco contratto, segreti commerciali, misure tecnologiche, marchi, brevetti, accesso a sistemi e altri diritti oltre al copyright sul programma.
Questa sezione serve quindi a costruire una mappa di base, non è consulenza legale. Per un progetto commerciale o un caso dubbio, soprattutto se riguarda software di terzi, protezioni tecniche o distribuzione di un prodotto concorrente, serve una valutazione sul caso concreto.
Osservare, studiare e testare il funzionamento di un programma
La Direttiva 2009/24/CE sulla tutela giuridica dei programmi per elaboratore prevede che una persona avente il diritto di utilizzare una copia possa osservare, studiare o sperimentare il funzionamento del programma per determinare le idee e i principi alla base dei suoi elementi, quando compie operazioni che ha il diritto di effettuare. È il contenuto dell’articolo 5, paragrafo 3.
La disciplina italiana sui programmi per elaboratore è contenuta nella legge sul diritto d’autore, negli articoli 64-bis, 64-ter e 64-quater; l’inserimento di queste disposizioni deriva dal decreto legislativo 518/1992 di attuazione della disciplina europea. Normattiva riporta la sezione dedicata ai programmi per elaboratore e il testo vigente della legge.
Il punto da non perdere è il requisito iniziale: non è una licenza generale a studiare qualunque copia ottenuta in qualunque modo. La norma parla della persona che ha il diritto di utilizzare il programma e collega l’osservazione alle operazioni che può legittimamente effettuare.
Quando entra in gioco la decompilazione per interoperabilità
La decompilazione ha una disciplina più specifica. L’articolo 6 della Direttiva 2009/24/CE consente, a determinate condizioni, gli atti di riproduzione del codice e traduzione della sua forma quando sono indispensabili per ottenere le informazioni necessarie all’interoperabilità di un programma creato autonomamente con altri programmi.
Le condizioni contano quanto l’eccezione: gli atti devono essere compiuti da chi ha diritto a usare la copia o per suo conto; le informazioni necessarie non devono essere già facilmente disponibili; l’attività deve restare limitata alle parti necessarie all’interoperabilità. La direttiva restringe inoltre l’uso delle informazioni ottenute e vieta di impiegarle per sviluppare, produrre o commercializzare un programma sostanzialmente simile nella sua espressione o per altri atti che violino il diritto d’autore.
È quindi sbagliato trasformare “esiste un’eccezione per interoperabilità” in “posso decompilare tutto ciò che voglio e farne un concorrente”. L’eccezione ha uno scopo e condizioni precise.
Perché conoscere una funzionalità non autorizza automaticamente a copiarne codice e asset
La Direttiva 2009/24/CE distingue l’espressione del programma dalle idee e dai principi che ne sono alla base. La Corte di giustizia, nel caso SAS Institute, ha inoltre stabilito che funzionalità, linguaggio di programmazione e formato dei file di dati, considerati in quanto tali, non costituiscono una forma di espressione del programma protetta dal copyright specifico sul software.
Questa distinzione è molto rilevante per REA. Capire che una funzione applica una certa regola e riscrivere autonomamente quella regola è una questione diversa dal copiare porzioni di codice, testi, grafiche, suoni, manuali o altri elementi espressivi protetti.
La stessa sentenza precisa che la riproduzione di elementi protetti può comunque violare il copyright quando si copia l’espressione creativa. In altre parole, compatibilità funzionale e copia dell’espressione non sono sinonimi.
Per questo un clean-room workflow ben progettato cerca di trasformare l’osservazione in requisiti e comportamenti verificabili, mantenendo separata la nuova implementazione dagli elementi protetti che non devono essere riprodotti.
DRM, licenze, accessi non autorizzati e altri confini da non confondere
Copyright sul codice, licenza contrattuale, misure tecnologiche di protezione e autorizzazione ad accedere a un sistema sono piani diversi. Un’eccezione prevista dalla disciplina software non equivale automaticamente al diritto di eludere DRM, aggirare autenticazione, manomettere servizi online o usare credenziali che non possiedi.
Lo stesso progetto REA limita esplicitamente il proprio uso a ricerca lecita, formazione, interoperabilità, software preservation e analisi di software che possiedi o sei autorizzato a esaminare. La documentazione precisa inoltre che le licenze dei tool commerciali devono essere rispettate.
Prima di un’analisi reale conviene quindi rispondere a tre domande separate:
- ho il diritto di usare o esaminare questa copia?
- le operazioni tecniche che voglio compiere sono consentite nel mio scenario?
- come userò e distribuirò le informazioni o il software che produrrò?
Se una delle tre risposte è incerta, il problema non si risolve cambiando prompt.
REA sostituisce davvero un reverse engineer?
No, almeno non nel senso forte del termine. Il cambiamento più credibile è una diversa divisione del lavoro: REA e il coding agent comprimono il tempo necessario per interrogare strumenti, attraversare artefatti e collegare risultati; l’analista resta responsabile delle domande che contano, dei criteri di verifica e delle decisioni che richiedono contesto tecnico o giuridico.
Questo sposta il valore dell’esperto. Meno tempo può essere speso in passaggi meccanici di navigazione e più tempo nella scelta del perimetro, nella valutazione delle prove e nel decidere quando un risultato è abbastanza solido da essere utilizzato.
Cosa l’AI accelera realmente
L’AI accelera soprattutto le attività iterative: localizzare una funzione candidata, attraversare caller e riferimenti, confrontare artefatti e riportare nell’indagine ciò che emerge dagli strumenti. Un agente può mantenere questo ciclo senza costringere l’utente a trasferire manualmente ogni output tra decompilatore, terminale e ambiente di sviluppo.
Il beneficio è quindi operativo: riduce il costo dei passaggi intermedi. Non sostituisce però il criterio con cui si decide quali passaggi meritino attenzione, tema che diventa centrale quando il software cresce o le evidenze sono ambigue.
Dove servono ancora competenza tecnica e verifica umana
La competenza umana resta decisiva quando l’evidenza non determina da sola la conclusione: scegliere il target corretto, riconoscere artefatti del decompilatore, individuare dipendenze esterne non visibili nel campione e stabilire quale test possa davvero smentire un’ipotesi.
C’è inoltre una decisione che l’agente non può ricavare dal binario: se il risultato ottenuto sia appropriato per lo scopo del progetto. Un’implementazione tecnicamente funzionante può essere comunque inadatta per licenza, sicurezza, manutenzione o architettura. È qui che la competenza smette di essere solo capacità di analisi e diventa giudizio.
Il vero cambiamento: rendere più economica l’analisi, non eliminare la difficoltà
Il vero effetto di REA è economico prima ancora che tecnico: abbassa il costo marginale di esplorare una funzione, confrontare un comportamento o costruire una proof of concept perché una parte della navigazione tra strumenti può essere delegata all’agente.
Questo può portare il reverse engineering dentro più decisioni di prodotto: compatibilità, migrazione, software preservation, audit di applicazioni legacy, comprensione di formati e ricostruzione di funzioni possono essere valutati prima e con un investimento iniziale più basso. La difficoltà non scompare; cambia il punto in cui diventa conveniente affrontarla.
È probabilmente questo, più dei “cloni in un prompt”, il cambiamento destinato a durare.
Conclusione
Reverse Engineer Anything rende praticabile un modo diverso di affrontare l’analisi del software: il coding agent può interrogare strumenti specialistici, seguire le evidenze e trasformare una domanda tecnica in una sequenza di verifiche invece di lavorare soltanto sul codice che gli viene fornito.
Per provarlo in modo sensato, partirei da software tuo o da un progetto per cui hai autorizzazione, scegliendo una funzione piccola con una ground truth conoscibile. Definisci prima la domanda e il test di accettazione, poi lascia che l’agente raccolga le prove necessarie. Se il workflow produce risultati verificabili su quel perimetro, puoi allargarlo gradualmente.
Il punto non è chiedere all’AI di “clonare tutto”, ma capire quando questo approccio riduce davvero il costo dell’analisi senza abbassarne il livello di verifica. È su questo terreno che REA diventa uno strumento utile, e non soltanto una demo impressionante.