
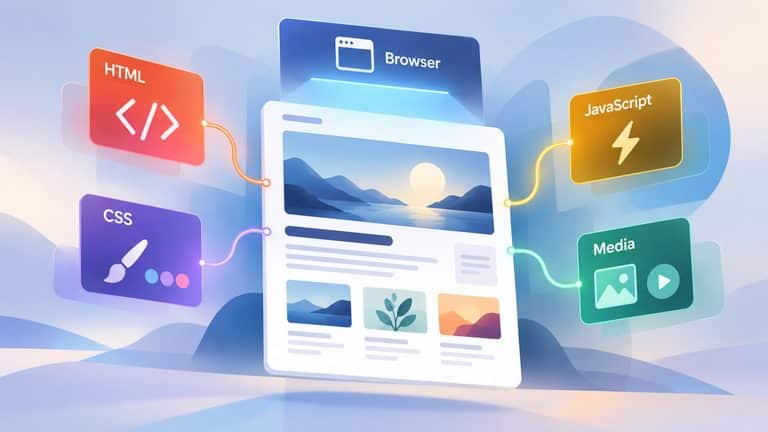
Una pagina web è un documento o una risorsa del World Wide Web che può essere visualizzata e utilizzata attraverso un browser. Può contenere testo, immagini, link, video, moduli e componenti interattivi, ma ciò che vedi sullo schermo è spesso il risultato della combinazione di più risorse recuperate ed elaborate dal browser.
È utile chiarirlo subito perché pagina web, sito web, browser, URL e Internet non indicano la stessa cosa.
Una pagina è la singola risorsa che stai consultando. Il sito è l’insieme organizzato a cui quella pagina può appartenere. L’URL permette di identificarla o raggiungerla. Il web server risponde alla richiesta. Il browser riceve le risorse e costruisce ciò che vedi.
Il Web, a sua volta, utilizza Internet come infrastruttura di comunicazione, ma non coincide con Internet.
Capire davvero una pagina web significa quindi comprendere questa catena, non imparare soltanto una definizione.
Cos’è una pagina web
Nel significato più comune, una pagina web è un documento pubblicato o reso accessibile attraverso le tecnologie del Web e visualizzabile con un browser.
Una normale pagina parte spesso da un documento HTML, ma non significa che tutto ciò che osservi sia contenuto in un unico file. Il documento può richiamare fogli di stile, script, immagini, font, video e dati provenienti da altre risorse.
Il browser recupera ciò che serve, interpreta le informazioni ricevute e costruisce la rappresentazione finale con cui puoi interagire.
Anche MDN Web Docs utilizza questa distinzione: la pagina web è il documento visualizzato dal browser, mentre un sito raccoglie e collega pagine e altre risorse.
La definizione tecnica spiegata in modo semplice
Immagina di stare leggendo un articolo online.
Quell’articolo è una pagina web.
Il menu in alto può collegarlo ad altre pagine. Un’immagine può essere un file separato. Il carattere tipografico può essere scaricato da un’altra risorsa. Un pulsante può attivare del codice JavaScript.
Per l’utente tutto appare come un’unica pagina, ma tecnicamente il browser può avere recuperato diversi elementi per costruirla.
Il modello più utile è quindi:
documento principale → risorse collegate → interpretazione del browser → pagina visualizzata
Questo spiega anche perché il sorgente iniziale e ciò che appare alla fine sullo schermo non devono essere necessariamente identici.
Web page, webpage e pagina Internet: cosa significano
Web page e webpage indicano la stessa cosa: una pagina del Web.
In italiano si usa normalmente pagina web. È ancora frequente incontrare anche “pagina Internet”, soprattutto nel linguaggio comune, ma l’espressione è meno precisa.
Internet è infatti l’infrastruttura di rete su cui funzionano molti servizi diversi. Il World Wide Web è uno di questi servizi.
Una pagina web appartiene quindi al Web, anche se per raggiungerla normalmente utilizzi una connessione Internet.
Pagina web e sito web: qual è la differenza
Una pagina web e un sito web sono collegati, ma non sono sinonimi.
La pagina è una singola risorsa consultabile. Il sito organizza pagine, risorse e percorsi sotto un progetto comune.
La differenza tra pagina web e sito web riguarda quindi soprattutto il livello a cui stiamo guardando: la prima è una singola unità consultabile, il secondo è il sistema che organizza più unità e risorse correlate.
Prendiamo Creativemotions.
Questo articolo è una pagina web. Anche la homepage, una pagina di servizio e un altro articolo sono pagine differenti. Nel loro insieme, insieme alle altre risorse e alla navigazione che le collega, formano il sito.
| Elemento | Che cos’è | Esempio |
|---|---|---|
| Pagina web | singolo documento o risorsa consultabile nel Web | un articolo, una pagina servizio, una scheda prodotto |
| Sito web | insieme organizzato di pagine e risorse correlate | blog, sito aziendale, ecommerce |
| Homepage | pagina che normalmente svolge il ruolo di ingresso principale del sito | pagina iniziale di un dominio |
| URL | indirizzo utilizzato per identificare o raggiungere una risorsa | indirizzo di questo articolo |
Questa distinzione diventa importante quando si progetta la struttura di un sito web: non basta creare molte pagine. Bisogna decidere quale funzione svolge ciascuna e come devono essere collegate.
Una pagina è una risorsa, il sito organizza più risorse correlate
Pensare al sito come a una semplice “pagina molto grande” porta facilmente a confondere i livelli.
Una guida, una pagina Contatti e una scheda prodotto possono avere layout, contenuti e obiettivi diversi. Restano però parte dello stesso progetto perché condividono dominio, identità, navigazione e relazioni.
La pagina rappresenta quindi un’unità di contenuto o di esperienza.
Il sito rappresenta il sistema che organizza quelle unità.
I link sono uno dei meccanismi che rendono questa struttura navigabile: collegano una risorsa a un’altra e permettono al lettore di spostarsi nel Web senza dover conoscere in anticipo ogni indirizzo.
Il caso particolare dei siti one-page
La distinzione “pagina = una, sito = molte” è utile per iniziare, ma non è una regola assoluta.
Esistono siti one-page in cui gran parte o tutto il contenuto principale è organizzato nello stesso documento e la navigazione porta a sezioni differenti della pagina.
Esistono inoltre le single-page application, o SPA, nelle quali una singola pagina può essere aggiornata dinamicamente mentre l’utente utilizza l’applicazione.
Questo non annulla la differenza tra sito e pagina. Dimostra piuttosto che l’architettura tecnica del Web è più flessibile della classica sequenza homepage → pagine interne.
Come funziona una pagina web: dall’URL allo schermo
Quando inserisci un indirizzo nella barra del browser o attivi un collegamento, non stai semplicemente “aprendo un file”.
Inizia una sequenza di operazioni che coinvolge indirizzamento, rete, server, documenti e browser.
Per capire come funziona una pagina web conviene seguire questa sequenza dall’indirizzo digitato fino al risultato costruito dal browser.
In forma semplificata:
URL → richiesta → server → risposta e risorse → browser → pagina utilizzabile
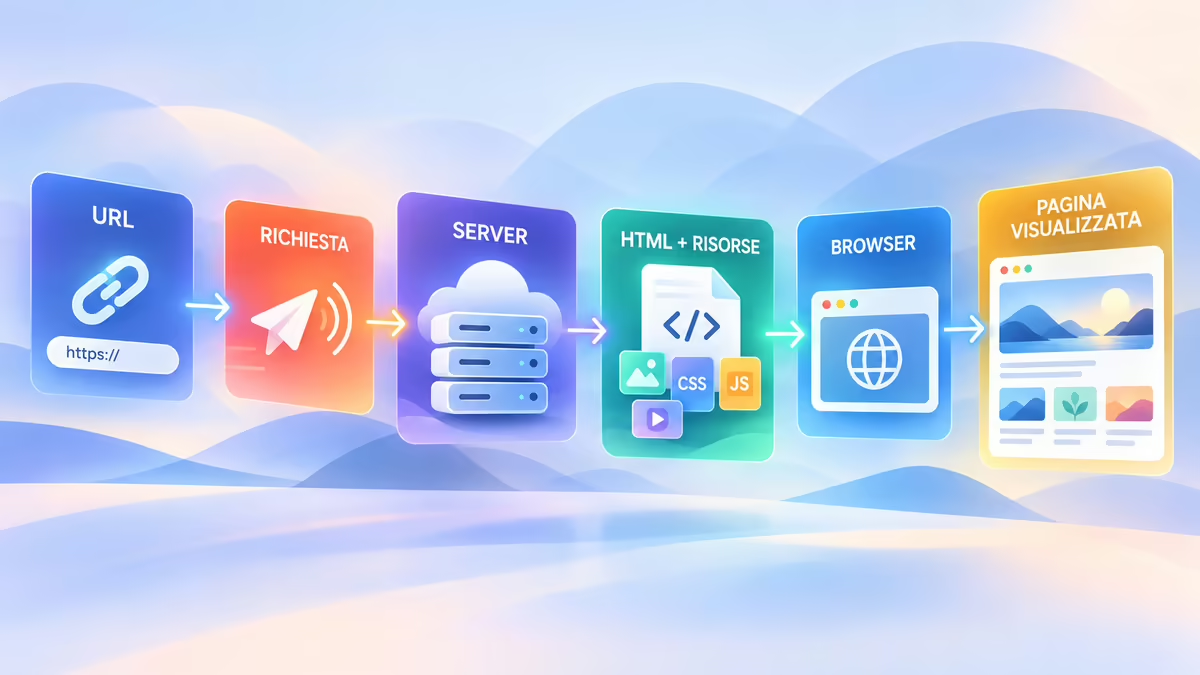
MDN descrive lo stesso modello client-server nella guida dedicata a come funziona il Web.
L’URL identifica la risorsa richiesta
Il primo elemento da distinguere è l’indirizzo.
Un URL permette al browser di capire quale risorsa deve raggiungere e quale meccanismo usare per richiederla.
Un indirizzo può contenere, tra gli altri elementi:
- lo schema, normalmente
https; - il dominio;
- il percorso della risorsa;
- eventuali altri componenti, quando necessari.
Il punto importante è non confondere indirizzo e contenuto.
L’URL identifica la destinazione; non è la pagina stessa.
Due concetti possono sembrare equivalenti quando navighiamo normalmente, perché digitiamo un URL e subito vediamo una pagina. Tecnicamente, però, fra le due cose esiste un processo di richiesta e risposta.
Il web server riceve la richiesta e invia la risposta
Una volta individuato il sistema che gestisce la destinazione, il browser può comunicare con il web server tramite HTTP o HTTPS.
Il server riceve la richiesta e determina come rispondere.
In un caso semplice potrebbe inviare un documento HTML già disponibile.
In altri casi la risposta può essere costruita attraverso un’applicazione, un CMS, un database, una cache o diversi sistemi che collaborano tra loro.
Per l’utente la differenza può essere invisibile: fa clic e riceve la pagina.
Dal lato tecnico, invece, la stessa esperienza visiva può essere prodotta attraverso architetture molto differenti.
Il browser recupera le risorse e costruisce la pagina visualizzata
Ricevere il documento principale non conclude necessariamente il lavoro.
Il browser può scoprire al suo interno riferimenti a:
- fogli di stile;
- script;
- immagini;
- font;
- video;
- altre risorse.
Può quindi effettuare ulteriori richieste, analizzare il documento, applicare gli stili ed eseguire il codice necessario.
Nel caso di un documento HTML, il browser costruisce una rappresentazione strutturata chiamata DOM, Document Object Model. CSS e altri meccanismi contribuiscono alla presentazione, mentre JavaScript può leggere e modificare il documento, reagire alle azioni dell’utente o recuperare nuovi dati.
È per questo che una pagina web non coincide necessariamente con un singolo file scaricato una volta sola.
Una pagina moderna può continuare a cambiare anche dopo il primo caricamento.
Da cosa è composta una pagina web
Non tutte le pagine utilizzano esattamente le stesse tecnologie, ma nel Web moderno incontrerai molto spesso tre livelli: HTML, CSS e JavaScript.
Tra gli elementi di una pagina web bisogna però considerare anche immagini, font, video, dati e altre risorse che il documento può richiamare durante il caricamento.
Non sono elementi alternativi che svolgono tutti lo stesso compito. Hanno ruoli differenti.
HTML: struttura e significato del documento
HTML descrive la struttura e il significato dei contenuti.
Attraverso gli elementi HTML il documento può indicare che una parte è un titolo, un paragrafo, un link, un’immagine, una sezione, una lista o un modulo.
Un esempio minimale potrebbe essere:
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <title>La mia pagina</title>
</head>
<body>
  <h1>Pagina di esempio</h1>
  <p>Questo è un paragrafo.</p>
</body>
</html>
Non è l’aspetto grafico a definire il significato di questi elementi. HTML fornisce prima di tutto struttura e semantica.
Lo standard di riferimento viene mantenuto come HTML Living Standard: non è quindi molto utile ragionare oggi come se il Web fosse fermo a una singola “versione finale di HTML5”.
CSS: presentazione e layout
Il CSS controlla principalmente la presentazione del documento.
Può stabilire colori, dimensioni, spaziature, griglie, allineamenti, comportamento responsive e numerosi altri aspetti dell’interfaccia.
Una distinzione semplice ma importante è:
HTML descrive cosa rappresentano i contenuti; CSS controlla come vengono presentati.
Separare questi ruoli rende il documento più comprensibile e permette di adattare la stessa struttura a schermi e contesti differenti.
JavaScript, immagini, font e altre risorse
JavaScript aggiunge logica e comportamento.
Può reagire a un clic, modificare il DOM, aggiornare una parte della pagina, validare un modulo o comunicare con servizi remoti senza richiedere necessariamente un caricamento completo del documento.
Ma HTML, CSS e JavaScript non esauriscono tutto ciò che una pagina può utilizzare.
Una pagina può richiamare anche immagini, video, file audio, font, icone e dati recuperati da API.
Queste risorse possono provenire dallo stesso server del documento oppure, quando l’architettura lo prevede, da altri sistemi.
Il risultato che vedi nel browser è quindi spesso la composizione di risorse con ruoli diversi, non il contenuto di un unico file monolitico.
Head e body: informazioni del documento e contenuto
Nei normali documenti HTML trovi due aree fondamentali: head e body.
Il head contiene informazioni e riferimenti relativi al documento: per esempio il titolo, alcuni metadati, collegamenti a fogli di stile o altri elementi necessari alla pagina.
Il body contiene invece il corpo del documento e la struttura dei contenuti che costituiscono l’esperienza principale della pagina.
Non significa che tutto ciò che si trova nel head sia irrilevante per ciò che appare a schermo. Un foglio CSS richiamato dal head, per esempio, può trasformare completamente la presentazione del body.
La distinzione riguarda il ruolo strutturale degli elementi, non la loro importanza.
Pagina web statica e dinamica: cosa cambia davvero
Le espressioni pagina statica e pagina dinamica vengono spesso spiegate male.
“Statica” non significa necessariamente che sullo schermo non si muova nulla.
“Dinamica” non significa semplicemente che ci siano animazioni.
La differenza utile riguarda soprattutto come viene prodotto e aggiornato il contenuto.
Cosa significa pagina statica
Nel modello più semplice, una pagina statica viene servita partendo da contenuti già preparati.
Il server non deve costruire ogni volta il documento interrogando un database o eseguendo una logica applicativa per decidere il contenuto principale della risposta.
Questo non impedisce alla pagina di usare CSS o JavaScript.
Puoi quindi avere una pagina consegnata come file HTML già generato che contiene animazioni, menu interattivi o altri comportamenti eseguiti nel browser.
Statico non significa visivamente immobile.
Cosa significa pagina dinamica
In una pagina dinamica, parte del contenuto può essere prodotta, selezionata o modificata attraverso logica applicativa e dati.
Un CMS come WordPress, per esempio, può recuperare titolo, testo, autore e altre informazioni dal database e utilizzare un template per generare la risposta.
Anche dopo il caricamento, JavaScript può richiedere ulteriori dati e modificare soltanto una parte della pagina.
Il dinamismo può quindi esistere:
- sul server, prima che arrivi la risposta;
- nel browser, dopo il caricamento;
- in entrambi i punti.
Perché una pagina moderna può combinare più modalità
Molti progetti reali non appartengono perfettamente a una sola categoria.
Una pagina può essere generata in anticipo e distribuita come contenuto statico, per poi recuperare informazioni aggiornate nel browser.
Un’altra può essere costruita sul server a ogni richiesta ma includere immagini e fogli CSS già memorizzati in cache.
Un’applicazione può combinare rendering lato server, codice eseguito nel browser e API.
Per capire come funziona una pagina moderna è quindi più utile chiedersi quale componente produce quale parte del risultato invece di fermarsi all’etichetta statico/dinamico.
Tipi di pagina web: esempi e funzioni diverse
Non esiste una tassonomia unica che obblighi tutti i siti a utilizzare gli stessi tipi di pagina.
Esistono però modelli ricorrenti perché rispondono a compiti diversi.
Homepage, pagine informative e articoli
La homepage svolge normalmente il ruolo di ingresso principale del sito. Può presentare il progetto, indirizzare verso le aree più importanti e aiutare l’utente a capire cosa può fare.
Le pagine informative approfondiscono invece un argomento relativamente stabile: chi siamo, contatti, informazioni su un servizio o documentazione.
Gli articoli appartengono normalmente a una struttura editoriale e possono essere organizzati tramite categorie, archivi e collegamenti ad altri contenuti.
La differenza importante non è il template utilizzato, ma il lavoro che la pagina deve svolgere per chi arriva.
Pagine di servizio, prodotto ed ecommerce
Una pagina di servizio deve far comprendere cosa viene offerto, per chi ha senso, quale problema affronta e quale passo può compiere l’utente.
In un ecommerce entrano invece in gioco schede prodotto, categorie, carrello, checkout e altre pagine o stati funzionali.
Anche quando due pagine sembrano graficamente simili, l’intento può essere molto differente.
Una pagina informativa deve soprattutto spiegare. Una scheda prodotto deve consentire anche di valutare e, quando appropriato, acquistare.
Landing page e applicazioni web
Una landing page viene normalmente progettata intorno a un obiettivo specifico: iscrizione, richiesta di contatto, download, acquisto o altra azione.
Una web application sposta ulteriormente il confine verso l’interazione.
Strumenti di posta elettronica, editor online, dashboard o sistemi gestionali possono funzionare nel browser e utilizzare le stesse fondamenta del Web, pur offrendo un’esperienza molto più vicina a quella di un’applicazione.
Per questo la parola “pagina” non descrive più soltanto documenti da leggere: nel Web moderno può diventare il punto di accesso a un’interfaccia complessa e continuamente aggiornata.
Domande frequenti sulle pagine web
Un sito web può essere composto da una sola pagina?
Sì.
Un sito one-page può concentrare i contenuti principali in un unico documento, spesso suddividendoli in sezioni raggiungibili attraverso la navigazione interna.
Esistono inoltre single-page application nelle quali l’interfaccia viene aggiornata dinamicamente senza il tradizionale caricamento di una nuova pagina completa a ogni interazione.
Questo non significa che ogni sito dovrebbe essere one-page: la scelta dipende dalla quantità di contenuti, dagli intenti che devono essere soddisfatti e dai percorsi che gli utenti devono compiere.
Ogni pagina web ha un URL?
Una risorsa pubblicata e raggiungibile nel Web viene normalmente identificata tramite un URL.
Non esiste però sempre una relazione perfetta “un URL = uno stato visivo”.
Una web application può modificare contenuti e interfaccia mantenendo lo stesso indirizzo, mentre uno stesso endpoint può produrre risultati differenti in base a dati, sessione, lingua o altri fattori.
L’URL resta un meccanismo fondamentale di identificazione e navigazione, ma non descrive necessariamente ogni possibile stato dell’interfaccia che il browser può mostrare.
Una pagina web può essere visualizzata senza connessione Internet?
In alcuni casi sì.
Un browser può mostrare risorse già disponibili localmente o conservate per l’utilizzo offline. Le applicazioni web possono inoltre implementare meccanismi che rendono disponibili determinate funzioni o contenuti anche quando la rete non è raggiungibile.
Questo non significa che qualsiasi pagina Internet possa essere aperta offline.
Se il browser deve recuperare dal server una risorsa che non possiede già e non esiste un meccanismo offline previsto, serve una connessione per ottenerla.
Conclusione
Capire una pagina web significa soprattutto smettere di considerarla come “quello che appare nella finestra del browser”.
Dietro quella schermata esiste una catena precisa: un URL identifica una risorsa, il browser effettua una richiesta, uno o più sistemi producono la risposta, vengono recuperate le risorse necessarie e il browser costruisce il documento con cui interagisci.
Questa distinzione rende molto più semplici anche concetti che altrimenti sembrano separati: HTML, CSS, JavaScript, URL, server, browser e link sono parti dello stesso meccanismo.
Se il tuo obiettivo non è soltanto capire la singola pagina ma trasformare più contenuti e funzioni in un progetto online coerente, il passo successivo è vedere come creare un sito web partendo da obiettivi, struttura e contenuti prima ancora di scegliere la tecnologia.