
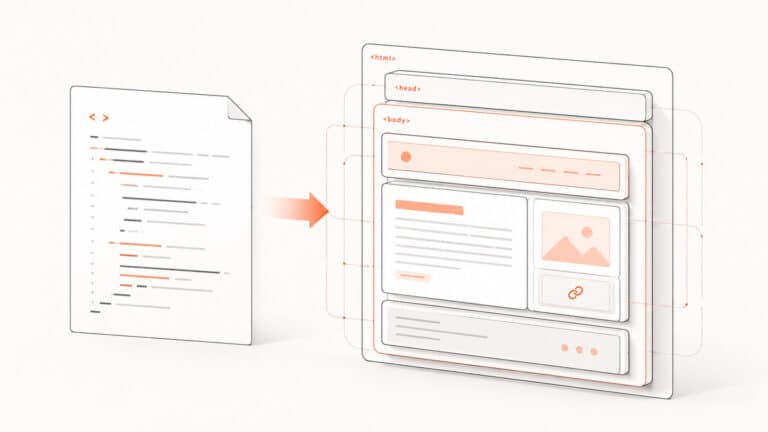
HTML è il linguaggio di markup utilizzato per descrivere la struttura e il significato dei contenuti di una pagina web. Titoli, paragrafi, link, immagini, moduli e molte altre parti di una pagina vengono rappresentati attraverso elementi HTML che il browser interpreta per costruire il documento.
La sigla HTML significa HyperText Markup Language, cioè linguaggio di markup per ipertesti. Non è un linguaggio di programmazione: non nasce per eseguire algoritmi, condizioni o calcoli, ma per descrivere che cosa rappresentano le diverse parti di un documento.
È una distinzione importante, perché HTML viene spesso confuso con tutto ciò che accade in una pagina web. In realtà lavora insieme ad altre tecnologie: CSS controlla principalmente presentazione e layout, mentre JavaScript permette di aggiungere logica e comportamenti interattivi.
Capire HTML significa quindi capire uno dei meccanismi fondamentali con cui funziona il web. In questa guida vedremo cosa significa HTML, a cosa serve, come sono costruiti elementi e attributi, cosa contiene un file .html, come il browser lo interpreta e perché oggi è più corretto parlare di HTML Living Standard che di una semplice “ultima versione HTML5”.
Cos’è HTML e cosa significa l’acronimo
HTML è l’acronimo di HyperText Markup Language.
La parola hypertext richiama la possibilità di collegare documenti e risorse attraverso link. È una delle idee alla base del World Wide Web: invece di leggere necessariamente un documento dall’inizio alla fine, puoi passare da una risorsa all’altra seguendo collegamenti ipertestuali.
La parte markup language descrive invece il modo in cui viene organizzato il contenuto. Il testo non viene lasciato come una sequenza indistinta di caratteri: viene “marcato” attraverso elementi che attribuiscono un significato alle sue diverse parti.
Per esempio:
<h1>Guida a HTML</h1>

<p>Questo è un paragrafo.</p>

<a href="https://example.com">Visita il sito</a>
<h1> indica un heading di primo livello, <p> un paragrafo e <a> un collegamento.
Il browser conosce le regole associate a questi elementi e può costruire una rappresentazione strutturata del documento.
HTML, quindi, non serve semplicemente a dire “metti questa frase qui” o “rendila grande”. Il suo compito principale è descrivere struttura e significato. La presentazione grafica è un livello distinto, normalmente gestito con CSS.
HTML è un linguaggio di programmazione?
No. HTML non è un linguaggio di programmazione: è un linguaggio di markup.
Un linguaggio di programmazione permette di esprimere logica attraverso concetti come variabili, condizioni, cicli, funzioni, tipi di dati e algoritmi. HTML non dispone di questi meccanismi.
Questo codice:
<p>Il mio primo paragrafo</p>
non dice al computer di eseguire un calcolo. Dichiara semplicemente che quella porzione di contenuto è un paragrafo.
JavaScript, al contrario, può eseguire istruzioni:
const prezzo = 10;
const quantita = 3;

console.log(prezzo * quantita);
Questo non significa che una pagina costruita con HTML debba essere “statica”. Un server può generare HTML dinamicamente e JavaScript può modificare il documento dopo il caricamento. La distinzione riguarda il ruolo del linguaggio, non il fatto che la pagina finale possa o meno cambiare.
È quindi più preciso dire che HTML descrive il documento, mentre altri linguaggi e sistemi possono generarlo, modificarlo o reagire alle azioni dell’utente.
Cos’è un file HTML e cosa significa l’estensione .html
Un file HTML è un normale file di testo che contiene markup HTML. L’estensione più comune è .html; storicamente si incontra anche .htm.
Un file chiamato:
index.html
può contenere, per esempio:
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <title>La mia pagina</title>
</head>
<body>
  <h1>Ciao!</h1>
  <p>Questa è la mia prima pagina HTML.</p>
</body>
</html>
Non serve un formato binario proprietario per aprirlo. Puoi modificarlo con un editor di testo e visualizzarlo con un browser.
L’estensione .html identifica quindi il formato del documento, ma il browser non si limita a mostrare il sorgente come testo: analizza il markup e ne costruisce una rappresentazione utilizzabile per creare la pagina.
A cosa serve HTML nel web
HTML serve a rappresentare la struttura dei contenuti e le relazioni fra le diverse parti di una pagina.
Con HTML puoi indicare, per esempio, che una frase è un titolo, che un’altra è un paragrafo, che una determinata risorsa è un’immagine, che un gruppo di voci costituisce una lista o che un testo deve collegarsi a un altro documento.
Questa struttura è utile contemporaneamente a diversi soggetti: browser, tecnologie assistive, motori di ricerca, strumenti di sviluppo e naturalmente persone che devono mantenere il codice.
Un documento HTML può anche indicare al browser altre risorse da recuperare, come fogli CSS, script JavaScript, immagini, font o file multimediali.
La pagina che vedi sullo schermo, quindi, non coincide necessariamente con un solo file HTML. Quel documento spesso costituisce il punto di partenza da cui il browser scopre e combina molte altre risorse.
Struttura e significato dei contenuti
Consideriamo queste due porzioni di markup:
<div>Guida a HTML</div>
<div>Come funziona un elemento HTML</div>
e:
<h1>Guida a HTML</h1>
<h2>Come funziona un elemento HTML</h2>
Visivamente potrebbero essere rese simili attraverso CSS, ma semanticamente non raccontano la stessa cosa.
Nel secondo caso stiamo dichiarando esplicitamente una relazione gerarchica fra il titolo principale e una sua sezione.
Lo stesso principio vale per elementi come:
<nav>
<main>
<article>
<section>
<aside>
<footer>
Questi elementi non esistono per “rendere più bello” il sito. Descrivono il ruolo di determinate parti del documento.
Naturalmente non è necessario trasformare ogni contenitore in un elemento semantico. <div> rimane perfettamente valido quando serve semplicemente un contenitore generico e non esiste un elemento più specifico adatto a quel contenuto.
HTML, CSS e JavaScript: tre ruoli diversi
HTML, CSS e JavaScript lavorano spesso insieme, ma risolvono problemi differenti.
| Tecnologia | Ruolo principale | Esempio |
|---|---|---|
| HTML | Struttura e significato del documento | Titoli, paragrafi, link, immagini, moduli |
| CSS | Presentazione e layout | Colori, font, spaziature, grid, responsive layout |
| JavaScript | Logica e comportamento | Eventi, aggiornamenti dinamici, interazioni |
La separazione non è sempre assoluta. HTML possiede comportamenti nativi, CSS oggi dispone di capacità molto avanzate e JavaScript può modificare sia struttura sia presentazione.
Come modello mentale, però, questa divisione è utile.
Un errore frequente consiste, per esempio, nel parlare di “HTML responsive”. HTML può includere informazioni necessarie a una corretta visualizzazione mobile, come il meta viewport, ma non è il markup HTML a progettare da solo un layout responsive: quella responsabilità ricade principalmente sul CSS e sulle decisioni di progettazione dell’interfaccia.
Come funziona HTML: elementi, tag e attributi
Per capire la sintassi HTML conviene distinguere tre parole che spesso vengono usate come sinonimi: tag, elemento e attributo.
Consideriamo:
<a href="https://example.com">Visita il sito</a>
L’intera struttura rappresenta un elemento a.
Il tag di apertura è:
<a href="https://example.com">
Il tag di chiusura è:
</a>
href è invece un attributo che fornisce un’informazione aggiuntiva all’elemento: in questo caso indica la destinazione del collegamento. La destinazione non deve essere necessariamente una normale pagina web: può anche utilizzare uno schema mailto per aprire la composizione di un messaggio email.
La distinzione può sembrare pignola quando stai imparando, ma diventa utile appena il codice cresce. Dire che “un tag contiene un altro tag” non sempre descrive correttamente ciò che avviene nel documento: ciò che viene organizzato in una gerarchia sono gli elementi.
La differenza tra tag, elemento e attributo
Un elemento può essere visto come l’unità semantica del documento.
Per esempio:
<p class="intro">Benvenuto nel sito.</p>
Qui:
<p class="intro"> è il tag di apertura, </p> è il tag di chiusura, class="intro" è un attributo e l’intera porzione <p class="intro">Benvenuto nel sito.</p> è l’elemento.
Gli attributi vengono scritti normalmente nel tag di apertura e modificano o specificano determinate caratteristiche dell’elemento.
Un’immagine, per esempio, può essere definita così:
<img src="foto.jpg" alt="Una spiaggia al tramonto">
src indica la risorsa da caricare; alt fornisce un’alternativa testuale all’immagine quando appropriato.
Tag di apertura, chiusura ed elementi void
Non tutti gli elementi HTML hanno un tag di chiusura.
Elementi come:
<img>
<br>
<input>
<meta>
<link>
appartengono alla categoria dei void elements: non possono contenere nodi figli e non devono avere un end tag.
È più corretto chiamarli in questo modo anziché “tag auto-chiudenti”.
Come chiarisce la documentazione MDN sui void elements, nella sintassi HTML i self-closing tag non esistono nello stesso senso in cui esistono in XML.
Per questo:
<img src="foto.jpg" alt="Foto">
è già completo.
Potresti incontrare anche:
<img src="foto.jpg" alt="Foto" />
ma nella sintassi HTML quella slash finale non “chiude” l’elemento: il parser HTML sostanzialmente la ignora in questo contesto.
Come funziona l’annidamento degli elementi
Gli elementi HTML possono essere contenuti gli uni negli altri.
Per esempio:
<article>
  <h2>Come funziona HTML</h2>
  <p>
    Puoi leggere anche la
    <a href="/guida/">nostra guida</a>.
  </p>
</article>
h2 e p sono figli di article; il link a è a sua volta contenuto nel paragrafo.
Questa gerarchia non è arbitraria. La specifica HTML definisce quali contenuti sono ammessi nei diversi elementi.
I browser sono molto tolleranti e cercano di recuperare anche documenti con markup imperfetto. Questo però non significa che ogni combinazione sia corretta: un errore di annidamento può far sì che il DOM costruito dal browser sia diverso da quello che avevi immaginato leggendo il sorgente.
Com’è fatta una pagina HTML
Una pagina HTML minima può essere sorprendentemente semplice:
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>La mia prima pagina HTML</title>
</head>
<body>
  <main>
    <h1>La mia prima pagina</h1>
    <p>Sto imparando HTML.</p>
  </main>
</body>
</html>
Questa piccola struttura introduce già gran parte del modello mentale necessario per orientarsi in un documento reale.
DOCTYPE, <html>, <head> e <body>
<!doctype html> compare all’inizio del documento.
Nelle vecchie generazioni di HTML le dichiarazioni doctype potevano essere molto più lunghe. Oggi quella forma semplice non serve a dichiarare “la versione HTML5”: viene utilizzata per far sì che i browser elaborino il documento secondo la modalità standard anziché ricadere nei vecchi comportamenti di compatibilità.
L’elemento <html> rappresenta la radice del documento. L’attributo:
lang="it"
indica la lingua principale del contenuto.
Dentro <head> vengono collocate informazioni e riferimenti che non costituiscono normalmente il contenuto principale mostrato nella pagina: il titolo del documento, metadata, collegamenti a fogli di stile e altre risorse.
<body> contiene invece ciò che appartiene al corpo della pagina.
<meta charset="utf-8"> dichiara la codifica dei caratteri.
La riga:
<meta name="viewport" content="width=device-width, initial-scale=1">
aiuta il browser a configurare correttamente il viewport sui dispositivi mobili. Non rende da sola il sito responsive: per adattare layout, spaziature, immagini e componenti alle varie dimensioni dello schermo serve una progettazione CSS adeguata.
Cosa fa il browser quando legge il documento
Quando riceve un documento HTML, il browser non si limita a leggere i tag dall’alto verso il basso e a “stamparli” sullo schermo.
Il markup viene analizzato e trasformato in una struttura ad albero. Questa rappresentazione è comunemente conosciuta come DOM, Document Object Model.
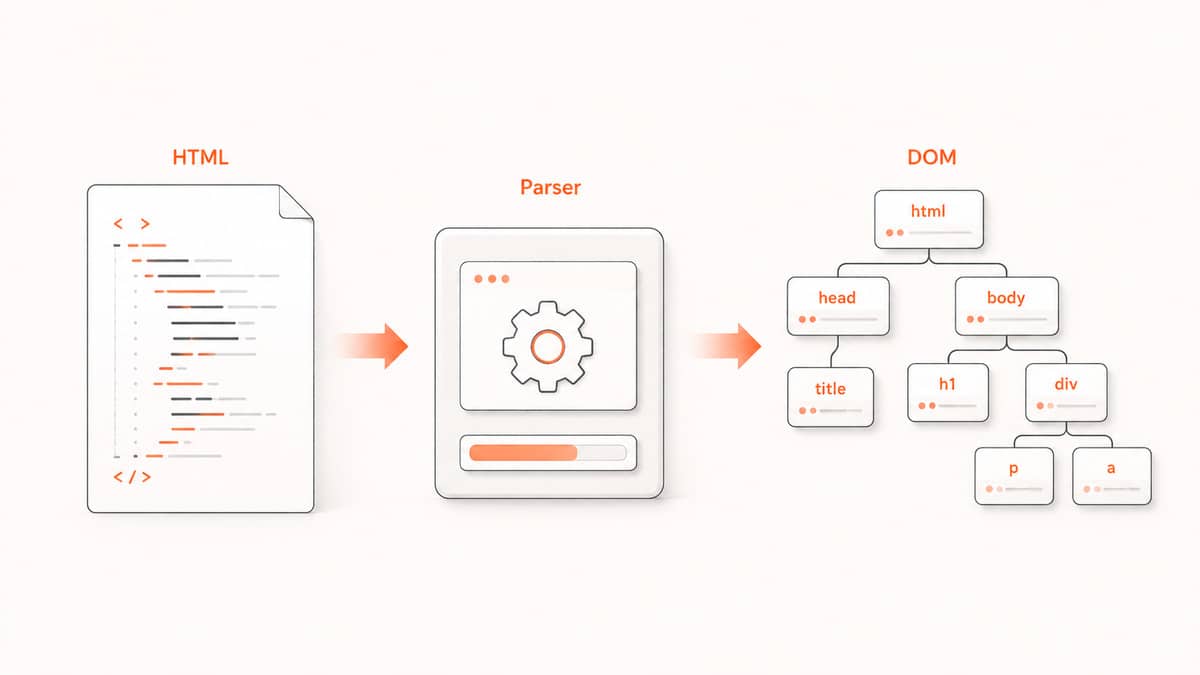
Se il documento contiene:
<body>
  <main>
    <h1>HTML</h1>
    <p>Una guida introduttiva.</p>
  </main>
</body>
il browser interpreta le relazioni fra gli elementi: main appartiene al body, mentre h1 e p appartengono a main.
Durante il caricamento possono poi entrare in gioco fogli CSS, font, immagini e script. JavaScript può anche modificare successivamente il DOM, aggiungendo, eliminando o modificando elementi.
Ecco perché HTML sorgente, DOM e pagina che vedi non sono sempre tre rappresentazioni identiche dello stesso contenuto.
Un esempio completo di pagina HTML
Mettiamo insieme i concetti essenziali:
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Il mio piccolo sito</title>
</head>

<body>
  <header>
    <p>Il mio sito</p>

    <nav aria-label="Navigazione principale">
      <a href="/">Home</a>
      <a href="/contatti.html">Contatti</a>
    </nav>
  </header>

  <main>
    <article>
      <h1>Come iniziare con HTML</h1>

      <p>
        HTML permette di descrivere la struttura e il significato
        dei contenuti di una pagina web.
      </p>

      <h2>Il primo esempio</h2>

      <p>Puoi creare una pagina anche con un normale editor di testo.</p>
    </article>
  </main>

  <footer>
    <p>Il mio sito web</p>
  </footer>
</body>
</html>
Qui non c’è ancora CSS e non c’è JavaScript. Eppure il documento possiede già una struttura comprensibile.
Possiamo riconoscere un’intestazione, una navigazione, il contenuto principale, un articolo e un footer. È esattamente questo il lavoro che HTML deve svolgere bene prima che arrivino gli altri livelli della pagina.
HTML semantico, accessibilità e SEO
Per HTML semantico si intende l’uso di elementi coerenti con il significato e la funzione del contenuto.
Se una parte della pagina contiene la navigazione principale, per esempio, <nav> comunica più informazione di un contenitore generico usato soltanto perché è facile applicargli una classe CSS.
Se abbiamo il contenuto principale della pagina, <main> descrive il suo ruolo meglio di:
<div class="main">
Questo non rende <div> sbagliato. Significa semplicemente che, quando esiste un elemento appropriato, utilizzarlo può rendere il documento più espressivo.
Gli elementi semantici possono essere particolarmente utili alle tecnologie assistive e aiutano sviluppatori e strumenti a comprendere l’organizzazione del documento.
Perché gli elementi semantici aiutano a capire la struttura
Un markup ben progettato esprime relazioni che altrimenti dovrebbero essere dedotte esclusivamente dalla grafica.
Una persona vedente può intuire che una scritta molto grande rappresenta il titolo principale. Un software non dovrebbe però essere costretto a dedurlo dalle dimensioni del font se esiste <h1> proprio per dichiararne il ruolo.
Lo stesso principio vale per navigazioni, articoli, sezioni, pulsanti e controlli dei moduli.
La semantica non riguarda quindi una ricerca ossessiva del “tag perfetto”. È un modo per far coincidere, per quanto possibile, il significato del contenuto con il markup utilizzato per rappresentarlo.
Cosa significa davvero per Google e cosa non significa
Qui è utile eliminare un equivoco frequente.
Usare HTML semantico non equivale automaticamente a ottenere posizioni migliori su Google.
La documentazione corrente di Google Search Central afferma che non è necessario avere HTML semanticamente perfetto perché Google riesca a comprendere una pagina, pur consigliando l’uso del markup semantico quando possibile, anche per facilitare la navigazione attraverso tecnologie come gli screen reader.
Il vantaggio concreto sta quindi soprattutto nel produrre documenti più chiari, accessibili e comprensibili, non nel trattare <article>, <section> o <nav> come interruttori di ranking.
Alcune parti del markup hanno naturalmente implicazioni specifiche per Search: link, titoli, immagini, metadata e structured data possono fornire informazioni utilizzate dai sistemi di ricerca. Ma da questo non deriva la regola “più tag semantici = più ranking”.
HTML5 oggi: dallo standard “a versione” all’HTML Living Standard
Per molti anni abbiamo imparato HTML attraverso numeri di versione: HTML 4, XHTML, HTML5.
HTML5 è stato un passaggio fondamentale nella storia del web. Ha consolidato nuovi elementi semantici, audio e video nativi, nuove capacità dei form e un insieme molto più ampio di funzionalità per le applicazioni web moderne.
Oggi, però, non è corretto pensare a HTML come a un linguaggio fermo a una “ultima versione HTML5”.
La specifica normativa mantenuta da WHATWG è pubblicata come HTML Living Standard: uno standard vivente che viene aggiornato continuamente invece di procedere soltanto attraverso grandi versioni numerate separate da anni.
Il termine “HTML5” continua naturalmente a essere usato. Può indicare la generazione moderna di HTML o, in modo più generico, l’insieme delle tecnologie web affermatesi con quella fase.
Se però vuoi sapere che cosa prevede HTML oggi, il riferimento non è una vecchia fotografia numerata dello standard ma il Living Standard corrente.
Per questo conviene separare due domande:
“Che cosa ha introdotto storicamente HTML5?” è una domanda sulla sua evoluzione.
“Qual è lo standard HTML corrente?” è invece una domanda sulla specifica mantenuta oggi.
Se ti interessa soprattutto il passaggio storico, puoi approfondire le differenze tra HTML e HTML5.
Come creare e verificare il tuo primo file HTML
Non hai bisogno di un ambiente di sviluppo complesso per fare il primo esperimento. Basta un editor capace di salvare testo semplice e un browser.
- Crea un nuovo file di testo e chiamalo
index.html. Assicurati che l’estensione reale sia.htmle non, per esempio,index.html.txt. - Inserisci una struttura minima, come l’esempio con
<!doctype html>,<html>,<head>e<body>visto in precedenza. - Salva il documento e aprilo nel browser. Per iniziare puoi fare doppio clic sul file; quando passerai a CSS, JavaScript, moduli o richieste di rete sarà spesso più pratico lavorare attraverso un server di sviluppo locale.
- Modifica il markup e controlla il risultato. Puoi usare gli strumenti per sviluppatori del browser per osservare il DOM e un validatore per individuare errori sintattici o strutturali.
Per scrivere codice con evidenziazione della sintassi, completamento automatico e strumenti più comodi puoi usare uno degli editor HTML disponibili per il tuo sistema operativo.
Salvare un file .html e aprirlo nel browser
Prova con questo esempio:
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <title>Esperimento HTML</title>
</head>
<body>
  <h1>Funziona!</h1>
  <p>Questa pagina arriva da un file HTML creato da me.</p>
</body>
</html>
Dopo averlo salvato come index.html, aprilo nel browser.
Vedrai un titolo e un paragrafo. A questo punto cambia il contenuto di <h1>, salva nuovamente il file e ricarica la pagina.
È un esercizio molto semplice, ma rende immediatamente evidente la relazione fra markup scritto nel file, struttura interpretata dal browser e risultato visualizzato.
Validare il markup e individuare gli errori
I browser sono progettati per gestire una grande quantità di HTML imperfetto. Una pagina può quindi sembrare funzionare anche in presenza di errori.
Per controllare il markup puoi utilizzare il W3C Markup Validation Service, che segnala problemi di conformità e sintassi.
La validazione è uno strumento diagnostico, non un voto sulla qualità complessiva del sito.
Una pagina formalmente valida può essere poco accessibile, difficile da usare o semanticamente debole. Allo stesso modo, un singolo errore di validazione non significa automaticamente che la pagina sia inutilizzabile.
Il valore del controllo consiste soprattutto nel trovare errori che possono nascondere problemi reali: elementi inseriti nel punto sbagliato, attributi non validi, tag non chiusi correttamente o strutture diverse da quelle che intendevi creare.
Conclusione
Capire HTML non significa memorizzare decine di tag. Significa soprattutto comprendere come un documento web viene descritto attraverso elementi, attributi e relazioni gerarchiche.
HTML assegna struttura e significato ai contenuti. CSS decide come presentarli. JavaScript può aggiungere logica e modificarli durante l’esecuzione. Il browser mette insieme questi livelli e costruisce la pagina con cui l’utente interagisce.
C’è anche un aggiornamento concettuale da ricordare: HTML non va più interpretato come una tecnologia arrivata a una versione finale chiamata HTML5. HTML5 resta una tappa fondamentale e un termine ancora diffusissimo, ma lo standard corrente è un Living Standard che continua a evolversi.
Se vuoi impararlo, il passo successivo non è leggere un’altra lista di tag: crea un piccolo file .html, aprilo nel browser, osserva il DOM, sbaglia qualcosa e prova a capire cosa ha costruito realmente il parser.
Quando invece il problema non è imparare il markup ma decidere come costruire un progetto reale, entrano in gioco architettura, CMS, manutenzione, performance e obiettivi del sito. In quel caso può esserti utile il confronto tra WordPress e HTML; per un progetto aziendale completo puoi invece partire dal servizio di realizzazione siti web.