
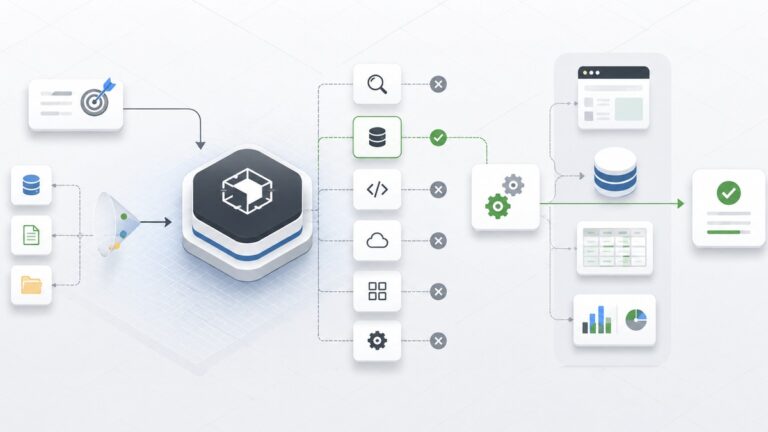
Gli agenti AI, o AI agents, sono sistemi software che utilizzano l’intelligenza artificiale per perseguire un obiettivo, decidere quali passaggi eseguire e interagire con strumenti o sistemi esterni con un certo grado di autonomia.
La differenza rispetto a un normale chatbot non è quindi semplicemente la qualità del modello utilizzato. Un chatbot può rispondere a una domanda e fermarsi. Un agente può invece ricevere un obiettivo, capire quali informazioni gli servono, scegliere uno strumento, eseguire un’azione, osservare il risultato e decidere cosa fare dopo.
È questo passaggio dalla generazione di una risposta all’esecuzione di un processo che rende gli agenti interessanti, ma anche più difficili da progettare e mettere in sicurezza.
Non tutte le automazioni che utilizzano un Large Language Model sono però agenti. In molti casi un workflow tradizionale resta più prevedibile, economico e semplice da controllare.
Capire dove passa questo confine è il punto di partenza per valutare correttamente gli agents AI.
Cosa sono gli agenti AI e cosa li rende davvero “agentici”
Un agente AI è un sistema al quale viene assegnato un obiettivo e che può determinare almeno una parte del percorso necessario per raggiungerlo.
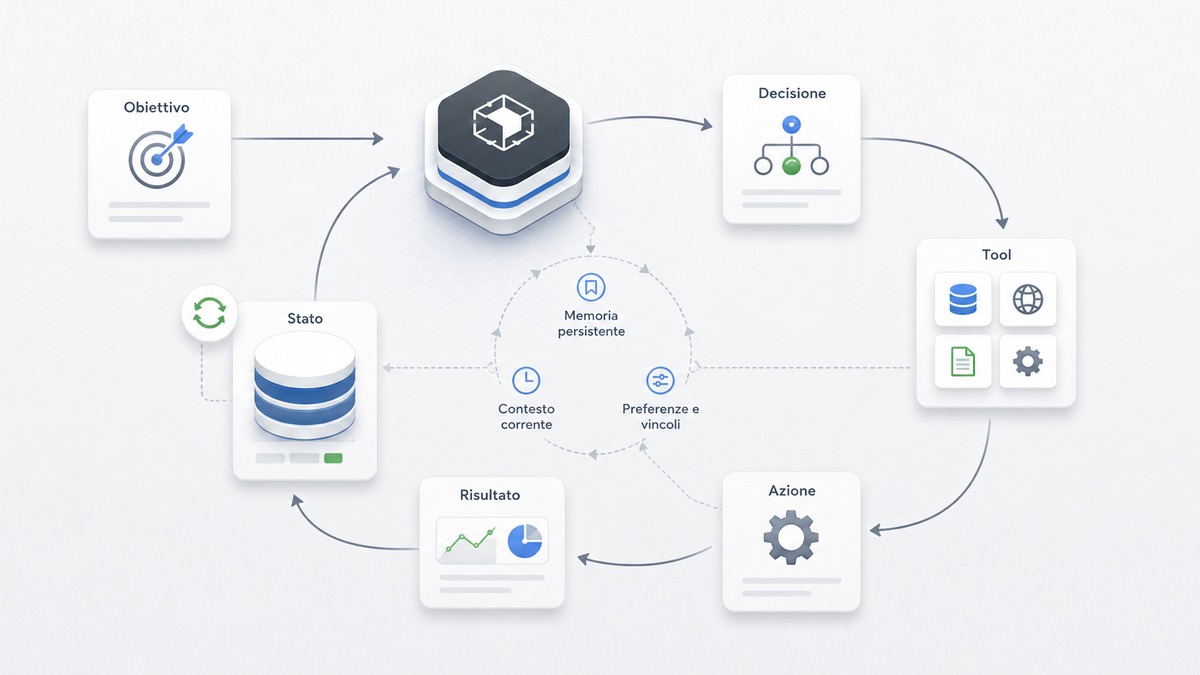
Il modello linguistico può rappresentare il motore di ragionamento dell’agente, ma un LLM da solo non costituisce necessariamente un agente. Per passare dalla semplice generazione di testo a un comportamento agentico servono normalmente altri componenti: istruzioni, contesto, strumenti, stato del processo e una logica che permetta di ripetere il ciclo decisione → azione → osservazione.
Una rappresentazione semplificata può essere questa:
obiettivo → analisi del contesto → scelta dell'azione → utilizzo di uno strumento → osservazione del risultato → aggiornamento dello stato → nuova decisione
Il ciclo termina quando l’obiettivo viene raggiunto, quando interviene una condizione di stop oppure quando è necessaria l’approvazione di una persona.
Questa definizione è più utile di formule generiche come “software che pensa da solo”, perché mostra anche dove nasce l’autonomia: non necessariamente nel modello, ma nel sistema che gli permette di scegliere e ripetere azioni.
AI agent vs chatbot, assistente AI e workflow automatizzato
Chatbot, assistenti, workflow e agenti possono utilizzare lo stesso modello di base. La differenza sta soprattutto nel modo in cui viene controllata l’esecuzione.
Anche la natura del modello sottostante è una scelta separata dall’architettura agentica. Un agente può infatti utilizzare un servizio proprietario oppure un modello open source o open-weight eseguito su infrastruttura controllata: cambiano licenze, possibilità di deployment, costi e governance, ma questo non rende da solo il sistema più o meno agentico.
| Sistema | Chi decide il prossimo passo? | Uso di strumenti | Autonomia | Scenario tipico |
|---|---|---|---|---|
| Chatbot | soprattutto l’utente | possibile ma non necessario | bassa | domande e risposte |
| Assistente AI | utente + logica dell’applicazione | spesso presente | bassa/media | supporto all’utente |
| Workflow | flusso definito in anticipo | sì | limitata dal workflow | processi prevedibili |
| Agente AI | il sistema entro limiti definiti | elemento centrale | media/alta | task aperti e multi-step |
La distinzione non è assoluta.
Un chatbot può acquisire capacità agentiche se può utilizzare strumenti e decidere autonomamente una sequenza di azioni. Allo stesso modo, un workflow può contenere uno o più passaggi affidati a un agente.
La domanda utile non è quindi “questa interfaccia sembra un chatbot?”, ma:
chi decide cosa deve succedere dopo?
Questa distinzione aiuta anche nella scelta del prodotto. Non tutti i problemi richiedono un agente: a volte basta un assistente generalista, altre volte serve un tool verticale o un workflow deterministico. Se vuoi partire dal task e confrontare le diverse categorie disponibili, nella guida agli AI tools e strumenti di intelligenza artificiale trovi una mappa orientata alla scelta pratica.
Prendi un processo di assistenza clienti.
Un chatbot tradizionale può leggere una domanda e spiegare come modificare un ordine. Un workflow può riconoscere una richiesta specifica e avviare sempre la stessa sequenza di controlli. Un agente potrebbe invece identificare il problema, consultare l’ordine, verificare la policy applicabile, chiedere informazioni mancanti e scegliere lo strumento appropriato per procedere.
Più libertà decisionale concedi al sistema, più aumentano però anche le cose che devono essere controllate.
Questa evoluzione si vede anche nei prodotti destinati agli utenti finali. Microsoft Copilot, per esempio, non si limita più alla chat: esperienze come Cowork e Tasks introducono pianificazione, utilizzo di strumenti ed esecuzione di attività, mantenendo però controlli e approvazioni nei passaggi in cui un’azione può avere conseguenze reali.
AI agent e Agentic AI: agente singolo e sistema agentico non sono la stessa cosa
AI agent e Agentic AI vengono spesso usati come sinonimi, ma è utile mantenerli concettualmente distinti.
Un AI agent è una specifica entità software incaricata di perseguire un obiettivo.
Agentic AI descrive invece più ampiamente sistemi e architetture in cui capacità come pianificazione, uso degli strumenti, memoria, autonomia e coordinamento vengono integrate nel processo.
Non esiste una tassonomia universale applicata nello stesso modo da tutti i vendor. Nella pratica, però, questa distinzione aiuta a evitare un equivoco frequente: un’applicazione agentica può comprendere più agenti, workflow deterministici, database, sistemi di controllo e componenti software tradizionali.
L’agente è quindi una parte dell’architettura, non necessariamente l’intera applicazione.
Come funziona un AI agent: dall’obiettivo all’azione
Per capire perché gli agenti possono fare qualcosa che un normale chatbot non fa, conviene separare i componenti del sistema.
Il modello riceve informazioni e produce decisioni, ma intorno al modello esiste un’infrastruttura che governa strumenti, stato, autorizzazioni e ciclo di esecuzione.
Modello, istruzioni e contesto
Il modello interpreta il task e decide come affrontarlo in base alle informazioni disponibili.
Le istruzioni definiscono ruolo, obiettivi, vincoli e comportamento previsto. Il contesto contiene invece le informazioni necessarie per prendere una decisione: conversazione, documenti, dati recuperati da una knowledge base, output precedenti o risultati prodotti dagli strumenti.
Sono due livelli diversi.
Dire a un agente “gestisci le richieste di assistenza” definisce un obiettivo molto ampio. Fornirgli policy, storico del cliente e dati dell’ordine gli consente invece di ragionare sul caso concreto.
Il contesto deve inoltre essere gestito con attenzione. Inserire indiscriminatamente sempre più dati non rende automaticamente migliore un agente: può aumentare rumore, costi e possibilità di utilizzare informazioni sbagliate o non pertinenti.
Pianificazione, tool calling, memoria e stato
Un agente diventa operativo quando può fare qualcosa oltre a generare testo.
Gli strumenti possono essere semplici funzioni interne oppure collegamenti verso API, database, motori di ricerca, filesystem, browser, CRM, ecommerce e altri servizi.
Un agente incaricato di analizzare un ordine potrebbe, per esempio:
- recuperare i dati dell’ordine;
- controllare lo stato della spedizione;
- leggere le regole applicabili;
- determinare le possibili azioni;
- richiedere un’approvazione se l’operazione supera una determinata soglia;
- aggiornare il sistema;
- comunicare il risultato all’utente.
Il tool calling permette al modello di decidere quale funzione utilizzare e con quali parametri, mentre l’applicazione mantiene il controllo sull’esecuzione effettiva.
Memoria e stato risolvono un altro problema.
Un processo composto da diversi passaggi deve sapere cosa è già successo. Lo stato può comprendere risultati intermedi, decisioni prese, strumenti utilizzati e dati necessari per continuare il task.
La memoria persistente può essere utile quando un agente deve conservare informazioni fra sessioni diverse, ma non è un requisito da aggiungere automaticamente. Più memoria significa anche più dati da governare e una nuova superficie di rischio.
Azione, osservazione, verifica e nuovo ciclo
Il comportamento agentico emerge soprattutto dal loop.
Supponiamo di chiedere a un agente di trovare tre fornitori compatibili con determinati requisiti.
Il sistema potrebbe:
analizzare i requisiti → cercare le informazioni → confrontare i risultati → accorgersi che manca un dato → eseguire una seconda ricerca → eliminare un candidato → produrre il risultato
Il percorso non è stato necessariamente programmato in anticipo passo per passo.
Il sistema osserva ciò che è successo e usa quel risultato per scegliere il passaggio successivo.
Questo è anche il motivo per cui la verifica del risultato diventa fondamentale. Se l’osservazione è sbagliata, il dato è contaminato o un tool restituisce informazioni incomplete, l’errore può propagarsi nelle decisioni successive.
Un agente affidabile non dovrebbe quindi essere progettato solo attorno alla domanda “sa completare il task?”, ma anche attorno a:
- come sappiamo che lo ha completato correttamente?
- quali azioni può eseguire?
- quali richiedono approvazione?
- quando deve fermarsi?
- cosa succede se uno strumento fallisce?
- quali informazioni devono essere registrate?
È qui che un prototipo interessante comincia a diventare un sistema utilizzabile.
Tipi di agenti AI: una classificazione utile
Non esiste un solo modo per classificare gli agenti intelligenti.
Le tassonomie classiche dell’intelligenza artificiale distinguono agenti riflessi, basati su modello, orientati agli obiettivi o all’utilità. Le architetture moderne basate su LLM vengono però spesso descritte anche in base a specializzazione, autonomia e modalità di orchestrazione.
Per orientarsi oggi è utile mantenere entrambe le prospettive senza confonderle.
Single-agent, multi-agent e agenti specializzati
Un sistema single-agent assegna il task principale a un singolo agente, che utilizza direttamente gli strumenti necessari.
È spesso il punto di partenza più semplice: meno passaggi di coordinamento, meno contesto duplicato e una catena decisionale più facile da osservare.
Un sistema multi-agent suddivide invece il lavoro fra agenti differenti.
Un agente può occuparsi della ricerca, uno dell’analisi e un altro della verifica. Oppure un agente principale può decidere quando delegare parti del problema a specialisti.
Questa configurazione è utile quando i ruoli sono realmente differenti oppure quando determinate attività possono essere svolte in parallelo.
Non bisogna però interpretarla come un’evoluzione automaticamente superiore.
Aggiungere agenti introduce:
- nuove comunicazioni;
- nuovi punti di errore;
- maggiore consumo di risorse;
- più stato da mantenere;
- problemi di coordinamento;
- possibilità che un errore venga trasmesso ad altri componenti.
Un’architettura multi-agent ha quindi senso quando la specializzazione o il parallelismo compensano realmente questa complessità.
Agenti reattivi, goal-based e utility-based: cosa resta utile della tassonomia classica
La classificazione tradizionale degli agenti conserva ancora valore come modello mentale.
Un agente reattivo risponde allo stato corrente dell’ambiente secondo regole o comportamenti relativamente immediati.
Un agente goal-based valuta invece le azioni in funzione di un obiettivo da raggiungere.
Un agente utility-based aggiunge un criterio di utilità, cercando non soltanto una soluzione possibile ma quella che massimizza una determinata funzione o preferenza.
I moderni sistemi basati su modelli linguistici non entrano necessariamente in una sola di queste categorie. Possono combinare comportamento reattivo, pianificazione, funzioni di valutazione e strumenti differenti.
Per questo non utilizzerei la tassonomia classica come una sequenza evolutiva del tipo:
reattivo → deliberativo → multi-agent → intelligenza superiore
Sono dimensioni differenti.
Un sistema single-agent ben progettato può essere molto più adatto a un task concreto di una complessa rete multi-agent.
MCP, A2A e framework: come si collegano agenti, strumenti e altri agenti
Quando un agente deve uscire dalla conversazione e agire sull’ambiente, emergono due problemi distinti:
- come accede a dati e strumenti?
- come comunica con altri agenti?
MCP e A2A affrontano principalmente questi due livelli e non vanno considerati semplicemente due protocolli concorrenti.
MCP: collegare un agente a dati e strumenti
Il Model Context Protocol (MCP) è uno standard aperto pensato per collegare applicazioni AI a sistemi esterni.
Un server MCP può mettere a disposizione elementi come:
- strumenti;
- risorse e dati;
- prompt o workflow riutilizzabili.
Questo permette a un’applicazione compatibile di scoprire in modo standardizzato ciò che un sistema esterno rende disponibile.
Immagina un gestionale aziendale.
Senza uno standard comune, ogni applicazione AI potrebbe aver bisogno di una propria integrazione personalizzata per leggere clienti, cercare documenti o aggiornare un record.
Con MCP, queste capacità possono essere esposte secondo un’interfaccia condivisa.
Sul piano concettuale:
agente → client MCP → server MCP → dati / API / strumenti
MCP non rende automaticamente sicura un’azione e non sostituisce autorizzazioni, autenticazione o validazione.
Se esponi a un agente uno strumento capace di cancellare un record, modificare un sito o inviare un pagamento, il problema fondamentale resta stabilire chi può utilizzarlo, in quali condizioni e con quali limiti.
Su Creativemotions trovi una guida specifica a MCP Server e Model Context Protocol e un approfondimento dedicato a WordPress MCP e agenti AI.
A2A: comunicazione e delega tra agenti
A2A, Agent2Agent, affronta un problema diverso: consentire ad agenti differenti di scoprirsi, comunicare e collaborare attraverso un protocollo condiviso.
Una semplificazione utile è:
MCP collega l’agente alle capacità. A2A collega un agente a un altro agente.
In un ecosistema complesso potresti quindi avere:
agente principale → A2A → agente specializzato
mentre ciascun agente può utilizzare:
agente → MCP → strumenti e dati
I due livelli possono convivere.
Questa separazione diventa particolarmente interessante quando agenti realizzati da team o piattaforme differenti devono collaborare senza conoscere tutti i dettagli della rispettiva implementazione interna.
| Aspetto | MCP | A2A |
|---|---|---|
| Relazione principale | AI ↔ strumenti/dati | agente ↔ agente |
| Problema | integrazione con sistemi esterni | interoperabilità e collaborazione |
| Esempio | consultare un database | delegare un task a un altro agente |
| Possono convivere? | sì | sì |
Non significa che ogni progetto debba utilizzarli entrambi. Per molte applicazioni un normale tool calling o una API ben definita sono sufficienti.
Framework e SDK: esempi, non una classifica
Intorno agli agenti è cresciuto un ecosistema di SDK e framework che gestiscono parti del problema come strumenti, stato, handoff, tracing, orchestrazione ed evaluation.
Alcuni esempi sono:
- OpenAI Agents SDK, per costruire agenti, strumenti, handoff, approvazioni e tracing;
- Google Agent Development Kit (ADK), per progettare, testare, valutare e distribuire sistemi agentici;
- Claude Agent SDK, che porta in applicazioni personalizzate il modello di agent harness utilizzato nell’ecosistema Claude;
- Microsoft Agent Framework, che riunisce il percorso maturato attraverso AutoGen e Semantic Kernel.
Questi strumenti non sono equivalenti e questa non è una classifica.
La scelta di un framework viene dopo la definizione del problema.
Prima conviene capire:
task → grado di autonomia necessario → strumenti → stato → autorizzazioni → verifica → orchestrazione
Solo a quel punto ha senso chiedersi quale framework riduca realmente il lavoro di implementazione.
Partire dal framework e cercare successivamente un problema da risolvere è uno dei modi più semplici per costruire un’architettura inutilmente complessa.
Cosa possono fare gli agenti AI: esempi e casi d’uso
Gli agents AI diventano interessanti soprattutto nei task in cui non basta produrre una singola risposta.
Il vantaggio emerge quando il sistema deve osservare una situazione, decidere come procedere e utilizzare strumenti differenti durante l’esecuzione.
Customer service e processi aziendali
Nel customer service un agente può andare oltre la generazione di una risposta.
Con i permessi corretti potrebbe:
- identificare il cliente;
- recuperare un ordine;
- consultare una knowledge base;
- verificare la policy pertinente;
- raccogliere informazioni mancanti;
- proporre un’azione;
- eseguire operazioni autorizzate;
- trasferire il caso a un operatore.
La parte decisiva è l’integrazione con il processo.
Se il sistema si limita a riscrivere una FAQ in forma conversazionale, stiamo usando principalmente AI generativa.
Se può interrogare sistemi diversi e scegliere dinamicamente il percorso necessario per risolvere il problema, il comportamento diventa molto più agentico.
Lo stesso principio può essere applicato alla gestione di documenti, alla ricerca interna, alla preparazione di report o all’elaborazione di richieste che richiedono più sistemi.
Coding, ricerca e automazione operativa
Lo sviluppo software è uno degli scenari in cui il concetto è facile da visualizzare.
Un normale assistente può suggerire una funzione.
Un coding agent può invece:
leggere il repository → cercare i file pertinenti → modificare il codice → eseguire test → osservare l'errore → correggere → rieseguire
La differenza è ancora una volta il loop. Un esempio concreto è Codex, il coding agent di OpenAI che può lavorare sul repository, modificare i file, eseguire test e verificare il risultato prima della review.
Lo stesso vale per la ricerca.
Un agente può costruire una strategia, interrogare più fonti, accorgersi che manca un’informazione, eseguire ulteriori ricerche e successivamente sintetizzare i risultati.
Anche in questo caso l’autonomia non elimina la necessità di verificare fonti e conclusioni.
Un agente può eseguire molte più operazioni di un chatbot; può quindi anche propagare molto più velocemente una supposizione sbagliata.
Ecommerce e WordPress: quando l’agente può agire sul sistema
WordPress e WooCommerce mostrano bene la differenza fra “AI dentro un sito” e agente operativo.
Un chatbot integrato in WordPress può rispondere alle domande dei visitatori.
Un agente collegato a capacità controllate potrebbe invece essere autorizzato a:
- recuperare informazioni;
- analizzare lo stato del sito;
- creare una bozza;
- modificare determinati contenuti;
- interrogare dati ecommerce;
- eseguire azioni consentite.
L’infrastruttura WordPress sta diventando particolarmente interessante perché sistemi come la Abilities API consentono di descrivere capacità disponibili in modo più strutturato. Ho approfondito questo livello nella guida alla WordPress Abilities API.
Sul versante ecommerce, il tema diventa ancora più delicato perché un agente può arrivare vicino a catalogo, carrello, ordini e checkout. Nell’approfondimento su WooCommerce e agenti AI analizzo proprio il passaggio dalla semplice generazione di contenuti a un commercio in cui software agentici possono interagire con le funzioni del negozio.
Non ogni processo deve però essere trasformato in un agente.
Per molte automazioni, una piattaforma a workflow come n8n continua a offrire un vantaggio preciso: il flusso rimane visibile e determinabile in anticipo.
Quando un agente AI conviene e quando un workflow è migliore
Una delle domande più utili non è “cosa può fare un agente?”, ma quando vale realmente la pena concedere autonomia al sistema.
Gli agenti sono particolarmente interessanti quando non puoi definire in anticipo ogni passaggio necessario per risolvere il task.
I task in cui autonomia, strumenti e pianificazione aggiungono valore
Un agente ha più senso quando il lavoro presenta diverse di queste caratteristiche:
- l’obiettivo è chiaro ma il percorso può cambiare;
- il task richiede più passaggi;
- le informazioni necessarie vengono scoperte durante l’esecuzione;
- bisogna scegliere fra strumenti differenti;
- possono verificarsi errori recuperabili;
- il sistema deve adattarsi ai risultati intermedi;
- il problema è sufficientemente variabile da rendere difficile programmare ogni percorso.
Un’attività di ricerca complessa ne è un esempio.
Non sai necessariamente in anticipo quante ricerche serviranno, quali fonti saranno sufficienti o quale nuovo problema emergerà dal primo risultato.
Qui la capacità di osservare e modificare il piano aggiunge valore.
Quando l’autonomia aumenta costi e rischi senza migliorare il risultato
Se il processo è stabile e completamente prevedibile, un agente può essere la soluzione sbagliata.
Supponiamo che ogni nuovo ordine debba generare:
fattura → aggiornamento CRM → email → registrazione nel gestionale
Non serve necessariamente un modello che decida ogni volta quale passaggio eseguire.
Un workflow deterministico è più facile da:
- testare;
- osservare;
- riprodurre;
- mettere in sicurezza;
- correggere;
- stimare in termini di costi e tempi.
Puoi eventualmente inserire l’AI in un singolo punto, per esempio per classificare il contenuto di una richiesta, mantenendo deterministico tutto il resto.
Questa architettura ibrida è spesso più sensata di un sistema completamente autonomo.
Una buona regola progettuale è:
usa l’autonomia dove l’incertezza del task la richiede; usa software deterministico dove conosci già la procedura.
Più autonomia non equivale automaticamente a più intelligenza o a un risultato migliore.
Rischi e sicurezza degli agenti AI
Un chatbot che genera una risposta sbagliata produce un problema informativo.
Un agente che interpreta male una richiesta e possiede strumenti operativi può invece trasformare quell’errore in un’azione.
È questa differenza a rendere la sicurezza degli agenti diversa dalla sola sicurezza del modello.
Il rischio dipende dalla combinazione:
modello + dati + strumenti + identità + privilegi + memoria + orchestrazione + ambiente
Prompt injection, tool misuse, privilegi e data leakage
La prompt injection cerca di influenzare il comportamento del modello attraverso istruzioni inserite negli input che il sistema elabora.
Negli agenti il problema può diventare ancora più serio perché l’input non arriva necessariamente soltanto dall’utente.
Un agente può leggere:
- una pagina web;
- un’email;
- un documento;
- un ticket;
- un risultato di ricerca;
- contenuti recuperati da sistemi esterni.
Un’istruzione malevola può quindi trovarsi nei dati che l’agente considera semplicemente materiale da analizzare.
Se quell’agente dispone anche di strumenti potenti, la compromissione può trasformarsi in tool misuse: utilizzo legittimo di una funzione nel contesto sbagliato o con parametri pericolosi.
Da qui deriva una regola fondamentale:
il modello non dovrebbe diventare il sistema di autorizzazione.
Dire nel prompt “non cancellare mai dati importanti” non equivale a rimuovere tecnicamente il permesso di cancellarli.
Least privilege, sandbox, human-in-the-loop, logging ed evaluation
Una progettazione prudente parte dal principio del least privilege: l’agente riceve soltanto le capacità necessarie per il task.
Se deve leggere un catalogo non dovrebbe automaticamente poterlo modificare.
Se deve preparare un rimborso può essere preferibile permettergli di proporre l’operazione lasciando l’esecuzione finale a un operatore.
Il controllo può essere distribuito su più livelli:
Permessi tecnici. Limitare strumenti, account, dati e operazioni accessibili.
Approvazione umana. Le azioni ad alto impatto possono richiedere conferma prima dell’esecuzione.
Sandbox. Codice e operazioni rischiose possono essere eseguiti in ambienti isolati.
Validazione. Parametri e risultati dei tool vanno controllati fuori dal modello dove possibile.
Limiti operativi. Numero massimo di passaggi, costi, timeout e condizioni di stop evitano loop incontrollati.
Logging e tracing. Registrare decisioni, strumenti e risultati consente di capire cosa sia realmente accaduto.
Evaluation. Un agente va valutato sul risultato e sul percorso seguito, non soltanto sull’ultima risposta testuale.
Le evaluation sono particolarmente importanti perché due esecuzioni possono produrre lo stesso output attraverso comportamenti molto diversi. Un agente può arrivare alla risposta corretta dopo aver chiamato uno strumento che non avrebbe dovuto utilizzare.
In produzione conta anche questo.
Multi-agent: delega, fiducia e nuovi confini di sicurezza
Aggiungere più agenti non elimina i problemi di sicurezza.
Li redistribuisce.
Quando un agente delega un task a un altro, entrano in gioco nuove domande:
- come viene identificato l’altro agente?
- quali informazioni può ricevere?
- quali risultati consideriamo affidabili?
- può delegare ulteriormente?
- con quali privilegi opera?
- cosa succede se comunica informazioni manipolate?
Un errore può inoltre propagarsi.
Se l’agente A produce un’informazione sbagliata, B la utilizza per prendere una decisione e C esegue l’azione, il problema diventa una cascata di fiducia.
Per questo nei sistemi multi-agent non basta osservare ogni componente isolatamente. Bisogna verificare anche le relazioni, le deleghe e i confini di autorizzazione fra agenti.
Lo stesso vale per memoria e stato.
Una memoria utile può permettere al sistema di lavorare meglio nel tempo, ma un’informazione contaminata che persiste può influenzare molte esecuzioni successive.
L’aumento dell’autonomia deve quindi essere accompagnato da un aumento proporzionato della capacità di controllo.
AI Act e governance: cosa cambia per chi utilizza agenti AI in Europa
L’etichetta “AI agent” non determina da sola quali obblighi normativi si applicano a un sistema.
L’Artificial Intelligence Act dell’Unione europea utilizza un approccio basato sul rischio e distingue ruoli, sistemi e casi d’uso.
Questo significa che la domanda corretta non è:
“gli agenti AI sono soggetti all’AI Act?”
È piuttosto:
che sistema stiamo utilizzando, per quale scopo, con quale ruolo e quali conseguenze produce?
Un agente incaricato di organizzare documenti interni presenta un profilo molto diverso da un sistema utilizzato in un contesto regolamentato o in una decisione capace di incidere significativamente sulle persone.
Il rischio dipende dal sistema e dal caso d’uso, non dall’etichetta “AI agent”
Lo stesso modello può essere utilizzato in applicazioni con rischi molto differenti.
Bisogna quindi guardare a:
- funzione del sistema;
- settore;
- dati trattati;
- grado di autonomia;
- conseguenze delle azioni;
- ruolo dell’organizzazione;
- eventuale classificazione normativa applicabile.
Inoltre, un’applicazione agentica può essere composta da molti elementi.
Il modello potrebbe essere fornito da un soggetto, l’orchestrazione sviluppata da un altro e il sistema finale utilizzato da una terza organizzazione.
La governance deve riflettere questa catena reale e non fermarsi al nome commerciale del prodotto.
Supervisione, responsabilità e documentazione
Anche al di fuori dei casi che attivano obblighi specifici, alcune domande restano utili per qualsiasi organizzazione:
chi è responsabile del sistema?
chi autorizza gli strumenti?
quali azioni possono essere eseguite autonomamente?
quali richiedono supervisione?
come vengono registrate le operazioni?
come viene gestito un errore?
come viene modificato o disattivato l’agente?
Sono domande di governance prima ancora che di compliance.
Un agente non diventa una nuova entità aziendale responsabile delle proprie azioni solo perché prende decisioni durante un workflow.
L’autonomia tecnica non elimina la necessità di definire responsabilità organizzative, controlli e procedure di escalation.
Per progetti soggetti a requisiti normativi specifici, la classificazione va naturalmente effettuata sul caso concreto e sulla normativa applicabile, non sulla base di una guida generale.
Conclusione
Gli agenti AI diventano davvero interessanti quando passano dalla semplice generazione di una risposta alla capacità di perseguire un obiettivo attraverso un ciclo di decisioni, strumenti e osservazioni.
Questo permette di affrontare problemi che un workflow rigido gestisce male: ricerca aperta, attività multi-step, ambienti variabili e processi nei quali il percorso emerge mentre il sistema lavora.
Ma proprio qui si trova anche il limite più importante.
Ogni incremento dell’autonomia aumenta ciò che il sistema può fare e, di conseguenza, ciò che può fare male. Tool, memoria, protocolli e multi-agent non sono quindi caratteristiche da aggiungere perché rendono l’architettura più sofisticata: hanno senso soltanto quando risolvono un problema concreto.
Per un processo prevedibile sceglierei ancora un workflow deterministico. Per un task aperto, che richiede decisioni dinamiche e utilizzo di più strumenti, valuterei un agente. Nei sistemi più delicati utilizzerei invece un modello ibrido, lasciando autonomia sui passaggi reversibili e introducendo controlli tecnici o approvazione umana quando l’azione produce effetti importanti.
La domanda decisiva, quindi, non è quanto possa diventare autonomo un agente.
È quanta autonomia serve davvero per risolvere meglio quel problema senza perdere controllo sul sistema.