

Quando si parla di AI opensource, il primo errore è pensare che significhi semplicemente “intelligenza artificiale gratuita da scaricare”. Non è così.
Un sistema può essere gratuito ma proprietario. Può rendere disponibili i pesi del modello senza essere completamente open source. Può avere codice aperto ma dipendere da un modello distribuito con una licenza diversa. E un modello che puoi eseguire sul tuo computer non diventa automaticamente open source solo perché funziona senza cloud.
La distinzione conta perché determina cosa puoi studiare, modificare, ridistribuire e utilizzare commercialmente, ma anche quanto controllo hai sui dati, sull’infrastruttura e sul comportamento del sistema.
In questa guida vediamo quindi cosa significa davvero AI open source, quali modelli aperti o open-weight vale la pena conoscere, quali strumenti permettono di eseguirli in locale e come scegliere senza confondere apertura, gratuità e libertà d’uso.
Se stai cercando invece una panoramica trasversale di assistenti, generatori, piattaforme creative e software specializzati, la nostra guida agli AI tools affronta un intento diverso: qui il centro della questione è quanto è realmente aperto il sistema AI e quanto controllo ti lascia.
Cos’è davvero l’AI open source
Per capire cosa significa davvero AI opensource, conviene partire da una definizione più rigorosa del semplice “posso scaricare il modello”.
La Open Source AI Definition della Open Source Initiative individua quattro libertà fondamentali: poter usare, studiare, modificare e condividere un sistema AI. Per esercitarle realmente deve essere disponibile anche la forma necessaria per effettuare modifiche, compresi gli elementi pertinenti relativi a codice, parametri e informazioni sui dati.
Questo cambia parecchio il modo in cui dobbiamo leggere la parola “open”.
Un file con i pesi di un modello pubblicato online è molto utile, ma non basta da solo a dimostrare che l’intero sistema soddisfi una definizione completa di Open Source AI.
AI open source, open-weight e gratuita non sono la stessa cosa
Le tre categorie vengono spesso mescolate, ma rispondono a domande differenti.
| Termine | Cosa significa in pratica | Cosa non garantisce |
|---|---|---|
| Open source AI | il sistema viene distribuito con libertà e materiali sufficienti per usarlo, studiarlo, modificarlo e condividerlo | che sia economico da eseguire o automaticamente sicuro |
| Open-weight | i pesi addestrati sono pubblicamente disponibili secondo i termini della relativa licenza | disponibilità completa di dati, pipeline e materiali di training |
| Gratuito | non paghi necessariamente per ottenere il modello o utilizzare una determinata modalità | libertà di modifica, redistribuzione o assenza di costi hardware |
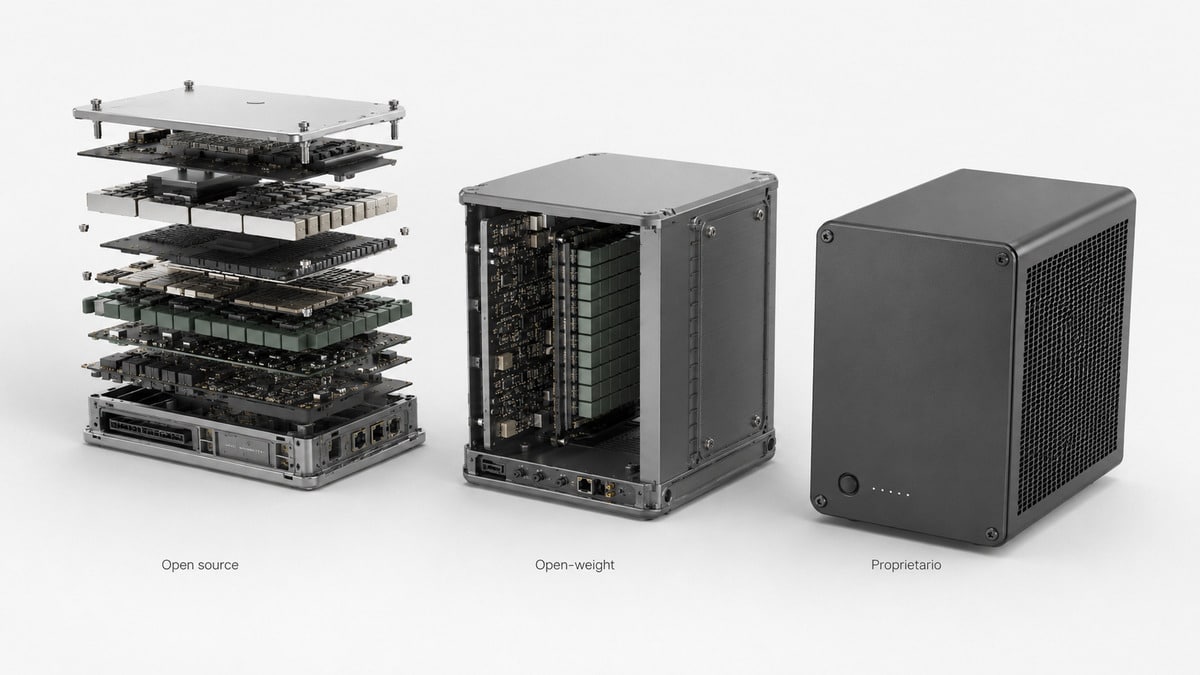
Un esempio molto chiaro viene dagli stessi modelli gpt-oss: OpenAI li definisce open-weight. I pesi possono essere scaricati e utilizzati secondo Apache 2.0 e la relativa usage policy, ma OpenAI distingue esplicitamente questa condizione dall’etichetta generica “open source”.
Inoltre il download dei pesi non elimina i costi di calcolo, storage o hosting.
Puoi approfondire direttamente nella documentazione OpenAI sui modelli open-weight.
“Gratis”, “pesi aperti” e “open source” descrivono quindi proprietà diverse.
Modello, pesi, runtime e AI tool: quattro livelli differenti
Un’altra confusione frequente nasce dal chiamare “AI open source” qualunque applicazione che utilizzi un modello scaricabile.
In realtà è più utile separare lo stack:
modello → pesi → runtime di inferenza → applicazione/interfaccia
Il modello definisce architettura e comportamento appreso.
I pesi contengono i parametri ottenuti durante l’addestramento.
Il runtime è il software che carica il modello e ne esegue l’inferenza.
L’AI tool è il prodotto attraverso cui interagisci con quelle capacità.
Questo significa che puoi utilizzare un runtime open source con un modello distribuito sotto una licenza completamente diversa.
Per capire meglio la distinzione generale tra modello, sistema e applicazione puoi partire anche dalla nostra guida su cos’è e come funziona l’intelligenza artificiale.
AI open source e AI proprietaria: cosa cambia davvero
La differenza interessante non è stabilire quale approccio sia “migliore” in assoluto. Bisogna capire quale forma di controllo ti serve e quale complessità sei disposto a gestire.
| Criterio | Modelli aperti / open-weight | Servizi proprietari gestiti |
|---|---|---|
| Accesso ai pesi | spesso disponibile | normalmente no |
| Esecuzione locale | possibile per molti modelli | spesso non disponibile |
| Personalizzazione | ampia, compatibilmente con licenza e competenze | dipende dalle API e dalle funzioni offerte |
| Infrastruttura | a carico tuo o del provider scelto | gestita dal vendor |
| Aggiornamenti | devi gestire versioni e deployment | normalmente gestiti dal servizio |
| Privacy | può aumentare il controllo se tutto resta locale | i dati transitano attraverso il servizio secondo condizioni e configurazione |
| Costi | hardware, energia, hosting, manutenzione | abbonamento o consumo API |
| Supporto | community, vendor o team interno | normalmente incluso nell’offerta commerciale |
| Licenza | va verificata modello per modello | prevalgono termini di servizio e contratto |
| Portabilità | spesso maggiore | può esserci maggiore dipendenza dal provider |
Il vantaggio più concreto dell’esecuzione locale è il controllo sull’infrastruttura. Puoi scegliere dove risiede il modello, quale versione utilizzare, come integrarlo e quali dati fornirgli.
Ma locale non significa automaticamente privato.
Se l’applicazione utilizza una ricerca web, un’API remota, servizi di telemetria, plugin esterni o altri componenti cloud, parte dei dati può comunque uscire dal computer. La privacy va quindi verificata sull’intero percorso del dato, non sul solo modello.
Allo stesso modo, open source non significa “nessun vendor lock-in”. Puoi sostituire più facilmente alcuni componenti, ma puoi comunque diventare dipendente da una particolare GPU, libreria, formato, pipeline o infrastruttura.
I modelli AI opensource da conoscere
Il mercato dell’AI opensource non può più essere descritto con un’unica lista di “migliori modelli”: i livelli di apertura sono molto differenti.
Questa tabella serve proprio a evitare di mettere nello stesso contenitore modelli con condizioni diverse.
| Famiglia | Come classificarla | Licenza / condizione rilevante | Perché è interessante |
|---|---|---|---|
| Olmo | fully open | stack e model flow aperti | ricerca, auditabilità e studio del training |
| Qwen | open-weight | diverse release con licenze permissive | ecosistema molto ampio e modelli di varie dimensioni |
| DeepSeek | open model / pesi disponibili | condizioni da verificare sulla singola release | reasoning, coding e workflow agentici |
| gpt-oss | open-weight | Apache 2.0 + usage policy | reasoning e deployment controllato |
| Llama | open-weight / source-available | Llama Community License | ecosistema e compatibilità molto ampi |
| Gemma | open-weight | condizioni definite nella model card della release | modelli compatti, multimodalità e multilingua |
| Mistral open models | dipende dal singolo modello | licenza variabile tra le release | scelta ampia per sviluppo e deployment |
La classificazione non sostituisce la lettura della licenza del singolo modello. Il nome della famiglia non basta: versioni differenti dello stesso vendor possono avere condizioni diverse.
Olmo: cosa significa davvero “fully open”
Olmo è probabilmente il caso più utile quando vuoi capire la differenza tra un modello con pesi scaricabili e un progetto costruito esplicitamente intorno all’apertura dell’intero processo.
Ai2 presenta Olmo come una famiglia progettata intorno alla completa apertura del model flow, pubblicando non soltanto i pesi finali ma anche materiali utili per ricostruire e studiare il percorso di training.
Questo rende possibile analizzare come il modello è arrivato al risultato finale e intervenire in fasi differenti del processo.
Se il tuo obiettivo è ricerca, riproducibilità o studio dei meccanismi di addestramento, questo livello di apertura vale più di qualche punto in più ottenuto da un modello meno trasparente su un benchmark.
Qwen: uno degli ecosistemi open-model più rilevanti
Qwen è interessante non soltanto per le prestazioni dei singoli modelli, ma per l’ecosistema che si è formato intorno alla famiglia.
Le analisi dell’ecosistema Hugging Face mostrano quanto Qwen sia diventato importante come base per modelli derivati e quanto i modelli relativamente piccoli continuino a essere centrali nell’inferenza locale.
La combinazione tra diverse dimensioni, forte supporto multilingue e disponibilità di modelli utilizzabili con runtime locali rende Qwen una famiglia da considerare quando vuoi bilanciare capacità e requisiti hardware.
La documentazione ufficiale Qwen rimane il punto da verificare per modello, licenza e requisiti della release che intendi utilizzare.
DeepSeek: apertura e modelli orientati al reasoning
DeepSeek merita una categoria distinta perché l’interesse non riguarda soltanto il chatbot pubblico.
La famiglia comprende modelli i cui pesi sono pubblicati e progetti orientati a reasoning, coding e tool use.
Se vuoi approfondire l’ecosistema, le differenze tra modelli e il servizio gestito, abbiamo una guida dedicata a DeepSeek: qui ci interessa soprattutto usarlo come esempio di quanto sia necessario distinguere modello scaricabile, servizio online e licenza della specifica release.
gpt-oss: un esempio chiaro di modello open-weight
gpt-oss è utile anche dal punto di vista didattico perché OpenAI usa esplicitamente la definizione open-weight.
I pesi possono essere eseguiti su infrastruttura controllata dall’utente e sono distribuiti con Apache 2.0 insieme alla relativa policy di utilizzo.
La documentazione indica inoltre la possibilità di utilizzare questi modelli con diversi runtime e stack diffusi nell’ecosistema locale.
È quindi un buon esempio di modello molto aperto sul piano dell’utilizzo dei pesi senza trasformare automaticamente “open-weight” in sinonimo di “fully open”.
Llama, Gemma e Mistral: leggere sempre la licenza, non il marketing
Llama ha contribuito enormemente alla diffusione dell’inferenza locale, ma le release della famiglia utilizzano una licenza community specifica di Meta, con condizioni proprie.
Per questo è più corretto verificarne i termini nella licenza ufficiale pubblicata da Meta invece di descrivere automaticamente tutta la famiglia come equivalente a un software sotto licenza open source OSI.
Google presenta Gemma come famiglia di modelli aperti, ma anche qui la scelta professionale deve partire dalla model card e dalla licenza della variante effettivamente utilizzata. La documentazione Gemma raccoglie specifiche e condizioni aggiornate.
Mistral richiede la stessa attenzione perché la licenza dipende dal singolo modello. L’azienda stessa distingue le condizioni delle diverse release: prima di usare una variante in un prodotto conviene quindi verificare la documentazione Mistral sulle licenze dei modelli open.
Quale modello scegliere in base a quello che devi fare
La scelta dovrebbe partire dal lavoro, non dalla classifica del momento.
| Scenario | Punto di partenza sensato | Cosa controllare prima |
|---|---|---|
| studio dell’open source AI | Olmo | disponibilità di dati, codice e checkpoint |
| AI locale su hardware non estremo | varianti piccole di Qwen, Gemma o altre famiglie compatibili | RAM/VRAM, quantizzazione e qualità sul task |
| reasoning e coding | Qwen, DeepSeek, gpt-oss o modelli specializzati | benchmark sul tuo caso reale |
| sviluppo e fine-tuning | modelli con licenza compatibile e toolchain matura | licenza, formato, framework e dataset |
| servizio multiutente | modello adatto + runtime server | throughput, latenza, GPU e osservabilità |
| massima riproducibilità | progetti con model flow realmente aperto | disponibilità dei materiali di training |
| prodotto commerciale | modello idoneo dopo verifica legale | licenza specifica e condizioni di redistribuzione |
Non sceglierei quindi un modello perché viene definito “il migliore open source”.
Un benchmark generalista può essere utile per restringere la ricerca, ma quello che conta è il risultato sul tuo dataset, nella tua lingua, con la quantizzazione che utilizzerai realmente e sull’hardware sul quale dovrà funzionare.
Questo vale ancora di più per applicazioni agentiche. Un modello può essere molto forte nel rispondere a domande e meno affidabile nel decidere sequenze di azioni, usare strumenti e gestire errori.
Se l’obiettivo è costruire sistemi autonomi, la nostra guida agli agenti AI approfondisce proprio la differenza fra generazione di una risposta ed esecuzione di un processo.
Gli strumenti open source per usare modelli AI in locale
Avere i pesi non basta. Serve un software capace di caricarli ed eseguire l’inferenza.
Qui la situazione è più semplice perché possiamo parlare di software open source nel senso tradizionale.
| Strumento | Funzione principale | Licenza del software | Lo userei soprattutto per |
|---|---|---|---|
| Ollama | gestione ed esecuzione locale di modelli | MIT | iniziare rapidamente |
| llama.cpp | inferenza efficiente e portabile | MIT | controllo, CPU/GPU e modelli quantizzati |
| vLLM | serving ad alte prestazioni | Apache 2.0 | API e deployment server |
| Transformers | libreria generale per modelli | Apache 2.0 | sviluppo, ricerca e integrazione Python |
Ollama è un ottimo punto di ingresso perché semplifica download, gestione ed esecuzione dei modelli. Il progetto è distribuito con licenza MIT.
llama.cpp segue un approccio più vicino al motore di inferenza e ha avuto un ruolo importante nella diffusione dei modelli quantizzati e dell’esecuzione anche su hardware consumer. Anche llama.cpp utilizza licenza MIT.
Per il serving lato server, vLLM è invece progettato per throughput ed efficienza dell’inferenza. Il repository ufficiale vLLM permette di verificare licenza, compatibilità e documentazione corrente.
Hugging Face Transformers è il livello più generale: consente di caricare, integrare, addestrare o eseguire un numero enorme di architetture. La documentazione ufficiale Transformers è il riferimento migliore per l’integrazione.
La licenza del runtime non cambia quella del modello
Questo punto merita di essere isolato perché evita molti errori.
Eseguire Llama tramite Ollama non trasforma Llama in software MIT.
Allo stesso modo, un modello caricato attraverso Transformers non acquisisce la licenza della libreria.
Devi sempre considerare almeno due livelli:
licenza del software di inferenza + licenza del modello
Per applicazioni più articolate possono entrare anche dataset, adapter, componenti aggiuntivi e dipendenze con condizioni proprie.
Come usare un’AI open source sul proprio computer
L’esecuzione locale non richiede necessariamente una workstation professionale. Dipende dal modello scelto e soprattutto da quanta memoria deve essere disponibile durante l’inferenza.
La vecchia regola “modello da X miliardi di parametri = scheda video Y” è troppo rigida.
Contano insieme:
parametri → precisione/quantizzazione → RAM/VRAM → context window → KV cache → runtime → offloading
RAM, VRAM e quantizzazione: cosa conta davvero
I pesi memorizzati a precisione più alta occupano più memoria. Riducendo la precisione attraverso la quantizzazione puoi abbassare sensibilmente il footprint, accettando un compromesso che dipende dal modello e dal formato.
Anche il context window conta: elaborare conversazioni o documenti molto lunghi richiede memoria aggiuntiva.
Inoltre non tutti i parametri di un modello Mixture-of-Experts vengono necessariamente utilizzati contemporaneamente. Per questo due modelli con un numero totale di parametri simile possono avere caratteristiche operative molto differenti.
La lezione utile non è memorizzare una GPU specifica. È controllare la model card della variante esatta che vuoi utilizzare.
Un workflow locale semplice
Il percorso più semplice può essere sintetizzato così:
scelta del modello → controllo licenza → verifica memoria → installazione runtime → download → test locale → verifica rete e privacy
Con Ollama, ad esempio, il runtime gestisce gran parte della complessità operativa.
Il comando concreto dipende dal tag del modello presente nella libreria corrente, quindi conviene sempre controllare il nome esatto prima del download invece di copiare comandi vecchi da una guida.
Per un uso professionale farei inoltre un test iniziale con prompt realmente rappresentativi del lavoro: documenti italiani, codice del tuo stack, query interne, classificazioni o workflow che il modello dovrà affrontare.
Un modello che appare ottimo in una demo inglese può non essere la scelta migliore sul tuo materiale.
Come evitare che un’AI “locale” invii comunque dati fuori dal computer
Se l’obiettivo è lavorare senza cloud, verifica l’intero stack.
Un modello locale può comunque essere collegato a strumenti web, API, database remoti o servizi di osservabilità. Anche un’interfaccia desktop potrebbe implementare funzioni online separate dall’inferenza.
Per dati riservati controllerei almeno:
dove vengono eseguiti modello ed embedding, dove risiede il database vettoriale, se sono attivi tool web, quali log vengono conservati e quali connessioni in uscita effettua l’applicazione.
Solo a quel punto puoi parlare concretamente di un workflow realmente locale.
AI open source gratis: cosa puoi davvero usare senza pagare
Quando si cerca AI opensource gratis, bisogna distinguere il costo per ottenere il modello dal costo necessario per eseguirlo. Molti modelli possono essere scaricati senza acquistare una licenza o un abbonamento.
Questo non significa che l’utilizzo sia a costo zero.
Un sistema self-hosted sposta parte della spesa:
abbonamento/API → hardware + elettricità + storage + amministrazione + manutenzione
Se possiedi già un computer adeguato e utilizzi un modello relativamente piccolo, il costo marginale può essere molto basso.
Se devi invece servire decine di utenti, garantire disponibilità continua o utilizzare modelli enormi, l’infrastruttura può costare più di un servizio API.
Anche OpenAI, nella documentazione dedicata ai modelli open-weight, distingue la disponibilità dei pesi dai costi necessari per eseguirli.
La domanda utile non è quindi “esiste un’AI gratis senza limiti?”.
È:
quanto mi costa ottenere il livello di qualità, velocità, controllo e disponibilità che mi serve?
Quando il self-hosting conviene davvero
Il self-hosting acquista senso quando il controllo ottenuto compensa l’onere operativo.
Può essere particolarmente interessante quando lavori con dati che non vuoi inviare a un servizio esterno, hai carichi molto prevedibili, devi personalizzare profondamente il modello o vuoi evitare che un cambio di API condizioni l’intera applicazione.
Ha meno senso quando utilizzi l’AI occasionalmente, vuoi sempre modelli di fascia alta senza gestire infrastruttura o non hai competenze per mantenere deployment, sicurezza e aggiornamenti.
Il confronto corretto è quindi total cost of ownership contro valore del controllo, non “gratis contro pagamento”.
Come valutare un modello o uno strumento prima di adottarlo
Prima di incorporare un modello AI in un progetto reale utilizzerei questa griglia.
| Criterio | Domanda da fare | Segnale d’allarme |
|---|---|---|
| Licenza | posso usare e distribuire il modello nel mio scenario? | “open source” dichiarato senza link ai termini |
| Livello di apertura | sono disponibili solo i pesi o anche gli altri materiali? | open-weight presentato come fully open |
| Hardware | posso eseguire la variante reale che userò? | benchmark ottenuti su hardware irrealistico |
| Quantizzazione | quale formato userò in produzione? | confronto tra precisioni differenti senza dichiararlo |
| Lingua | funziona bene sul mio italiano e sul mio dominio? | solo benchmark inglesi |
| Context | quanto contesto serve davvero? | finestra teorica usata come unica misura di qualità |
| Sicurezza | chi aggiorna modello e dipendenze? | file scaricati da repository non verificati |
| Ecosistema | runtime e librerie sono maturi? | progetto difficilmente mantenibile |
| Provenienza | model card e training information sono sufficienti? | materiali poco documentati |
| Costi | quanto costa inferenza, storage e gestione? | “gratis” usato come sinonimo di costo zero |
| Benchmark | misura il mio caso d’uso? | una singola leaderboard usata come verdetto |
| Governance | posso auditare versione, prompt e output? | aggiornamenti incontrollati |
Quale AI aperta funziona bene in italiano?
La risposta non può essere “una sola”.
Diverse famiglie moderne hanno un supporto multilingue ampio, ma supportare l’italiano non significa essere ugualmente bravo in ogni compito italiano.
Un modello può conversare bene ma essere meno affidabile con terminologia legale, documenti tecnici, copywriting, classificazioni specialistiche o dati aziendali.
Per questo farei sempre un piccolo benchmark interno prima della scelta finale.
AI open source per aziende e Pubblica Amministrazione: vantaggi e limiti reali
Per un’organizzazione il vantaggio dell’apertura non consiste nel poter dire di “usare open source”.
Conta ciò che permette di fare in concreto.
Un modello eseguibile su infrastruttura controllata può facilitare requisiti di data residency, integrazione con sistemi interni, personalizzazione e controllo della versione utilizzata.
La maggiore disponibilità dei componenti può inoltre rendere più semplice l’audit tecnico.
Ma open source non significa automaticamente sicuro.
Un modello può avere vulnerabilità, dipendenze compromesse, comportamenti indesiderati o rischi di prompt injection. E quando lo gestisci internamente, molti controlli che un SaaS implementa per te diventano responsabilità tua.
Anche i bias non scompaiono perché il modello è aperto. L’apertura può rendere più facile analizzarli o intervenire, ma non garantisce che siano inferiori.
Cosa cambia con l’AI Act
Per i modelli general-purpose distribuiti come open source esistono condizioni specifiche e alcune possibili esenzioni da determinati obblighi.
Il servizio ufficiale europeo dedicato all’AI Act chiarisce però che l’eccezione non è generale: dipende dalle caratteristiche del modello e dalle condizioni previste dalla normativa.
Per un’azienda questo significa che scegliere un modello aperto può facilitare alcuni aspetti di trasparenza e controllo, ma non sostituisce una valutazione di compliance.
Domande frequenti sull’AI open source
Llama è davvero open source?
È più preciso descrivere Llama come una famiglia con pesi disponibili e licenza community specifica di Meta.
La licenza consente molte forme di utilizzo e modifica, ma contiene condizioni proprie e non va automaticamente equiparata a una normale licenza open source OSI.
gpt-oss è open source o open-weight?
OpenAI lo definisce open-weight.
I pesi sono disponibili con Apache 2.0 insieme alla relativa policy di utilizzo, ma “open-weight” rimane la definizione più precisa per descrivere il livello di apertura.
Posso usare un modello AI senza Internet?
Sì, se modello, runtime, dati e tutti i componenti necessari vengono eseguiti localmente.
Devi però verificare che l’applicazione non utilizzi API, strumenti web, telemetria o altri servizi remoti.
Un modello AI open source è sempre gratuito per uso commerciale?
No.
Devi controllare la licenza della specifica release. Alcune licenze permettono ampio uso commerciale, altre contengono condizioni o limitazioni particolari.
Inoltre il costo di esecuzione rimane separato dalla licenza.
Qual è la migliore AI open source?
Non esiste una risposta unica.
Olmo è particolarmente interessante quando apertura e riproducibilità vengono prima di tutto; Qwen, DeepSeek, Gemma, gpt-oss, Llama e Mistral coprono invece scenari differenti per dimensione, linguaggio, reasoning, coding, multimodalità e deployment.
La scelta deve partire dal task e dalla licenza, quindi essere verificata sul tuo hardware e sui tuoi dati.
Conclusione
L’AI opensource è diventata molto più interessante, ma anche più difficile da descrivere con una semplice lista di modelli gratuiti.
La distinzione fondamentale è questa:
se vuoi soltanto scaricare ed eseguire un modello, un buon open-weight può essere sufficiente; se vuoi studiare e modificare realmente il processo che lo ha prodotto, devi cercare un livello di apertura molto più profondo.
Per sperimentare sul proprio computer partirei da un modello di dimensioni compatibili con l’hardware e da un runtime semplice come Ollama o llama.cpp.
Per un servizio professionale guarderei soprattutto a licenza, qualità sul task reale, costi di inferenza, sicurezza e maturità del serving.
Per ricerca e riproducibilità darei molto più peso alla disponibilità di dati, codice, checkpoint e training flow che alla posizione in una leaderboard.
Ed è questo il criterio che evita buona parte della confusione: non chiederti soltanto se un’AI è “open”. Chiediti cosa è aperto, con quale licenza e se quel livello di apertura serve davvero al problema che devi risolvere.