
La parola pipeline compare in contesti molto diversi. Può indicare una conduttura, una serie di opportunità commerciali, un flusso di dati, una sequenza di elaborazioni software oppure il processo che porta del codice dai test alla produzione.
Questi significati non sono scollegati.
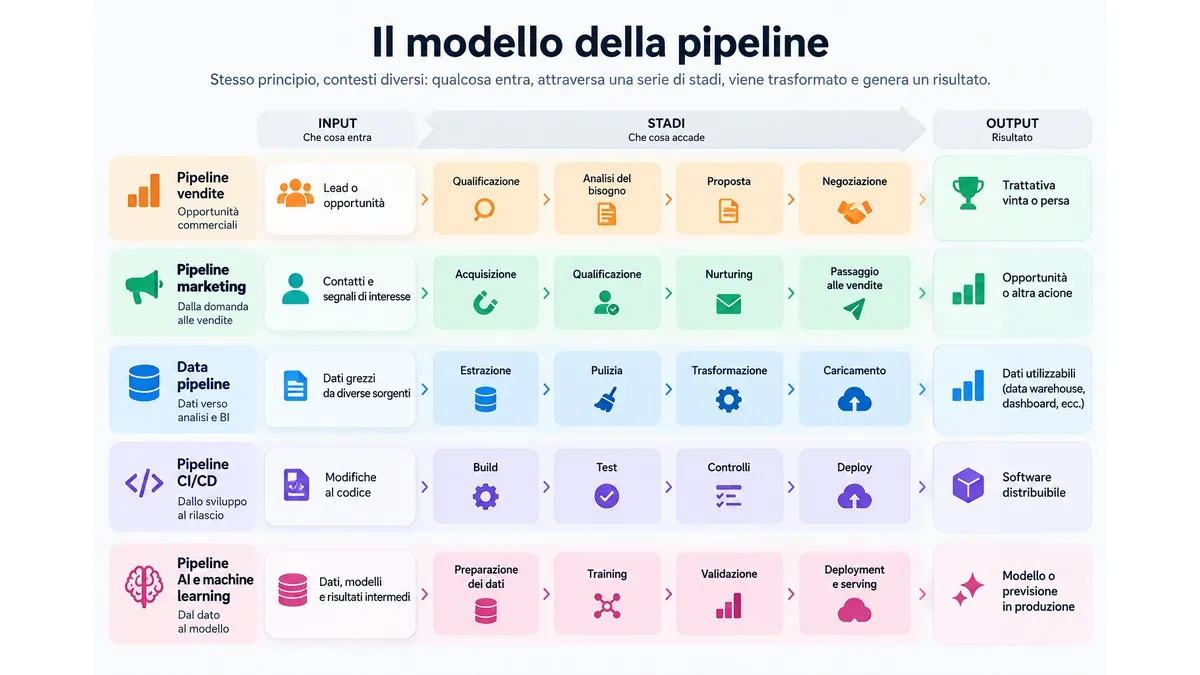
L’idea comune è quella di qualcosa che entra in un percorso, attraversa una serie di stadi e ne esce in uno stato diverso o in una destinazione precisa. Cambiano ciò che scorre, le operazioni eseguite e il risultato che si vuole ottenere.
Capire questo modello è più utile che cercare una traduzione italiana valida in ogni situazione. Una sales pipeline non è un oleodotto; una data pipeline non è un funnel di marketing; un processo CI/CD non descrive una trattativa commerciale. La metafora è simile, il meccanismo concreto cambia.
Cosa significa pipeline
In inglese pipeline nasce dall’unione di pipe, tubo, e line, linea. Il significato originario è quindi molto concreto: una conduttura attraverso cui qualcosa viene trasportato da un punto a un altro.
Da questa immagine deriva l’uso moderno del termine in molti settori. Quando elementi, informazioni o attività devono procedere attraverso passaggi ordinati e collegati, la metafora diventa naturale.
Traduzione, genere grammaticale e origine del termine
Il Vocabolario Treccani registra pipe-line, o pipeline, come termine inglese usato in italiano al femminile. Nel significato originario può equivalere a oleodotto, ma la stessa voce contempla anche applicazioni nell’organizzazione industriale e nell’informatica.
Per questo tradurla sempre con “oleodotto” sarebbe sbagliato.
Nel linguaggio professionale italiano è normale dire:
- la pipeline commerciale;
- la pipeline dei dati;
- la pipeline software;
- la pipeline CI/CD.
La traduzione corretta dipende quindi dal contesto. In molti casi conviene mantenere il termine inglese, perché parole come “flusso”, “processo”, “sequenza” o “catena” ne descrivono soltanto una parte.
La logica comune: input, stadi e output
Il modello più semplice è:
input → stadio 1 → stadio 2 → stadio 3 → output
Non significa che ogni sistema debba essere perfettamente lineare. Possono esserci diramazioni, controlli, condizioni, cicli oppure elaborazioni parallele.
Il principio utile è un altro: l’elemento osservato possiede uno stato e avanza attraverso fasi riconoscibili.
| Contesto | Che cosa entra | Che cosa accade | Risultato |
|---|---|---|---|
| Vendite | lead o opportunità | qualificazione, proposta, negoziazione | trattativa vinta o persa |
| Marketing | contatti e segnali di interesse | acquisizione, qualificazione, nurturing | opportunità o altra azione |
| Software | dati o informazioni | elaborazioni successive | nuovo output |
| Data pipeline | dati grezzi | acquisizione, pulizia, trasformazione | dati utilizzabili |
| CI/CD | modifiche al codice | build, test, controlli, rilascio | software distribuibile |
| Machine learning | dati e modelli | preparazione, training, validazione | modello o previsione |
Questa struttura mostra anche perché il termine non identifica un processo specifico. Descrive soprattutto un modo di organizzare e osservare un flusso attraverso stadi.
“In the pipeline”: cosa significa questa espressione
L’espressione inglese “in the pipeline” ha assunto anche un significato figurato.
Il Cambridge Dictionary la usa per qualcosa che è in fase di pianificazione o sviluppo.
Quando un’azienda dice che ha tre nuovi prodotti in the pipeline, normalmente sta dicendo che sono previsti, in preparazione o in sviluppo, magari a livelli differenti di avanzamento.
È quindi importante guardare la frase completa. “Il cliente è nella pipeline commerciale” può riferirsi a una trattativa; “la nuova funzione è in pipeline” può semplicemente voler dire che è prevista nella roadmap.
Pipeline nel business: vendite, marketing e CRM
Nel business questo modello è utile soprattutto quando bisogna capire dove si trova qualcosa all’interno di un processo.
Non basta sapere che esistono cinquanta lead o venti trattative. Serve distinguere un contatto appena acquisito da un’opportunità qualificata, una proposta inviata da una negoziazione avanzata.
La rappresentazione per fasi rende visibili queste differenze.
Pipeline vendite: opportunità e fasi del processo commerciale
Una pipeline vendite, o sales pipeline, rappresenta il percorso delle opportunità attraverso le fasi del processo commerciale.
La definizione di Salesforce mette al centro la posizione del potenziale cliente nel processo di vendita e i passi necessari per far avanzare la trattativa.
Un esempio B2B potrebbe essere:
nuovo lead → qualificazione → analisi del bisogno → proposta → negoziazione → vinta/persa
Non è uno standard universale.
Un’azienda che vende consulenza può avere fasi diverse da chi vende software in abbonamento, macchinari industriali o servizi ricorrenti. La struttura dovrebbe rappresentare il processo reale, non obbligare l’organizzazione ad adattarsi alle etichette previste da un software.
Il valore emerge quando permette di capire, per esempio, quante opportunità si trovano in ciascuna fase, quali sono ferme, quale azione dovrebbe avvenire dopo e chi ne è responsabile.
È anche la logica con cui un CRM organizza contatti, opportunità e fasi commerciali.
Una piattaforma come Salesforce può rendere questa gestione molto sofisticata, ma il principio resta lo stesso: il software rappresenta e supporta il modello commerciale definito dall’azienda.
Pipeline marketing: lead, qualificazione e passaggio alle vendite
L’espressione pipeline marketing è meno uniforme.
In molti contesti B2B viene usata per collegare le attività di marketing non soltanto alla generazione iniziale dei contatti, ma anche alla loro progressione verso opportunità e ricavi.
È utile però evitare un equivoco: marketing e vendite possono condividere lo stesso percorso senza svolgere lo stesso lavoro.
Il marketing può occuparsi di:
domanda → acquisizione → lead → qualificazione → nurturing
La parte commerciale può invece proseguire con:
opportunità → proposta → negoziazione → chiusura
Il confine preciso dipende dall’organizzazione.
È anche il motivo per cui raccogliere contatti non basta. Una strategia di lead generation diventa realmente utile quando stabilisce che cosa succede dopo l’acquisizione: come viene qualificato il lead, quando passa alle vendite e quali risultati vengono misurati.
Lo stesso vale per l’automazione. Una piattaforma di marketing automation può usare dati, trigger e condizioni per eseguire attività o spostare un contatto da uno stato all’altro, ma automatizzare il flusso non significa averlo progettato correttamente.
Pipeline CRM: il software rappresenta il processo, non lo sostituisce
Quando si parla di pipeline CRM, è facile confondere la struttura visualizzata dal software con il processo aziendale.
Immagina queste fasi:
nuova opportunità → qualificata → proposta inviata → negoziazione → chiusa
Se l’azienda non ha stabilito cosa significhi davvero “qualificata”, quando una proposta possa entrare in negoziazione o quali condizioni rendano una trattativa persa, il CRM può mostrare cinque colonne perfettamente ordinate senza eliminare l’ambiguità.
Il processo viene prima dell’interfaccia.
Prima di creare molti stadi conviene quindi chiedersi quali cambiamenti reali richiedono una decisione, un’azione o una responsabilità diversa.
Se due fasi non cambiano nulla, probabilmente non servono. Se invece modificano chi deve intervenire, quali informazioni servono o quale attività va eseguita, la distinzione può essere utile.
Pipeline informatica: software, dati e automazione
In informatica il concetto diventa più tecnico, ma conserva la stessa logica di base: informazioni, dati o artefatti attraversano una successione di passaggi collegati.
Non esiste però una sola pipeline informatica. Un flusso software generico, una data pipeline, un processo CI/CD e una catena di machine learning risolvono problemi differenti.
Confonderli porta a definizioni troppo vaghe.
Pipeline software: quando l’output di uno stadio diventa l’input del successivo
Nel significato software più generale, più componenti o operazioni vengono collegati in modo che i risultati prodotti in un punto possano essere utilizzati nel passaggio successivo.
Un modello elementare può essere:
input → elaborazione A → elaborazione B → elaborazione C → output
Ogni stadio ha una responsabilità circoscritta.
Per esempio, un sistema potrebbe:
ricevere un file → verificarlo → convertirlo → comprimerlo → salvarlo
Il vantaggio concettuale è la separazione del processo in passaggi osservabili.
A seconda dell’architettura, gli stadi possono lavorare in sequenza, in parallelo, su eventi, in batch oppure reagire a condizioni differenti.
“Pipeline software” descrive quindi una famiglia molto ampia di meccanismi. Per capire quello specifico bisogna identificare input, stadi, dipendenze e output.
Data pipeline: come passano e si trasformano i dati
Una data pipeline ha come oggetto principale i dati.
AWS la descrive come una serie di passaggi di elaborazione utilizzati per preparare informazioni provenienti da diverse sorgenti. Nel percorso possono essere spostate, ordinate, filtrate, riformattate, verificate o trasformate prima di raggiungere la destinazione. La spiegazione di AWS sulle data pipeline distingue inoltre elaborazioni batch e streaming e chiarisce che questo modello non coincide necessariamente con un processo ETL.
Un esempio semplificato:
database ecommerce → estrazione → pulizia → normalizzazione → data warehouse → dashboard
Qui non si parla soltanto di trasferimento.
Se date, valute, nomi dei prodotti o identificativi dei clienti arrivano da sistemi differenti, il percorso può avere il compito di renderli coerenti prima dell’analisi.
È una differenza importante rispetto alla semplice sincronizzazione tra due applicazioni: durante il tragitto i dati possono cambiare forma, qualità o struttura.
Pipeline CI/CD: test, build e deploy
Nello sviluppo software si parla frequentemente di pipeline CI/CD.
La sigla indica continuous integration e continuous delivery o deployment. La documentazione Red Hat sulle pipeline CI/CD descrive una serie di passaggi utilizzati per portare una nuova versione del software attraverso sviluppo e distribuzione, con un ruolo centrale dell’automazione.
Una sequenza semplificata potrebbe essere:
modifica del codice → build → test → controlli → pacchetto → deployment
Qui ciò che avanza non è un lead e nemmeno un normale dataset: è il cambiamento software insieme agli artefatti prodotti durante il processo.
Se un test fallisce, il flusso può fermarsi. Se i controlli vengono superati, può procedere verso gli stadi successivi.
Il vantaggio non consiste nell’avere frecce tra cinque box, ma nel rendere il rilascio ripetibile, controllabile e automatizzabile.
Pipeline AI e machine learning: stesso modello, fasi diverse
Anche nei sistemi di intelligenza artificiale e machine learning il termine viene utilizzato per coordinare attività successive.
La documentazione Google sulle pipeline ML distingue, per esempio, processi dedicati ai dati, all’addestramento, alla validazione e alla fornitura delle previsioni.
Un percorso può comprendere attività come:
raccolta dati → preparazione → training → validazione → deployment → previsione → monitoraggio
Ma “pipeline AI” resta una definizione molto ampia.
Un processo destinato alla preparazione dei dati ha un compito diverso da quello che addestra un modello; quello che serve previsioni in produzione ne ha un altro ancora.
La domanda utile non è quindi “qual è la pipeline AI?”, ma quale processo vogliamo rendere ripetibile e quali input e output collegano i suoi stadi?
Pipeline, funnel e workflow: quali sono le differenze
Pipeline, funnel e workflow vengono spesso rappresentati graficamente come sequenze di passaggi. Per questo è facile considerarli sinonimi.
Non lo sono.
La differenza emerge quando smettiamo di guardare la forma del diagramma e ci chiediamo quale problema deve aiutarci a capire.
| Modello | Domanda principale |
|---|---|
| Pipeline | Dove si trova l’elemento nel processo e quale stadio viene dopo? |
| Funnel | Come cambia il volume o la progressione lungo il percorso? |
| Workflow | Quali azioni, regole e responsabilità devono essere eseguite? |
I confini non sono assoluti. Un CRM può usare contemporaneamente tutti e tre i modelli e un flusso automatizzato può incorporare un workflow.
La distinzione serve a scegliere la rappresentazione più utile, non a imporre tre definizioni incompatibili.
Pipeline vs funnel: stato delle opportunità e progressione del pubblico
Una struttura commerciale per fasi e un funnel possono utilizzare dati simili, ma mettono a fuoco problemi differenti.
La prima guarda soprattutto alle singole opportunità e al loro stato.
Il secondo aiuta maggiormente a rappresentare la progressione complessiva tra fasi e le conversioni che avvengono lungo il percorso.
Immagina 100 contatti, 30 lead qualificati, 12 opportunità, 5 proposte e 2 clienti.
Il funnel permette di vedere come il gruppo si restringe.
La vista commerciale per stadi consente invece di chiedere:
quali sono oggi quelle 12 opportunità, in quale fase si trovano e che cosa deve succedere per farle avanzare?
Sono due prospettive differenti sullo stesso processo.
Se vuoi analizzare la progressione complessiva del pubblico, conviene partire dal modello del funnel marketing. Se devi governare trattative concrete una per una, la vista per fasi diventa generalmente più utile.
Pipeline vs workflow: stadi del flusso e regole del processo
Anche questi due concetti possono sovrapporsi, soprattutto nei software di automazione.
Il primo tende a rispondere a:
dove si trova questo elemento?
Il workflow tende invece a rispondere a:
cosa deve accadere quando si verifica questa condizione?
In un CRM, per esempio, una trattativa potrebbe passare da “proposta inviata” a “negoziazione”.
Questo è un cambiamento di stato.
Il passaggio potrebbe però attivare automaticamente tre azioni:
crea attività per il commerciale → avvisa il responsabile → imposta un promemoria fra tre giorni
Questa è logica di workflow.
Nella pratica i due modelli lavorano spesso insieme. Uno fornisce struttura e stato; l’altro può utilizzare quello stato per decidere azioni automatiche.
Come capire quale termine è corretto dal contesto
Quando incontri la parola e non sai esattamente quale significato abbia, puoi quasi sempre risolvere il dubbio con quattro domande:
- Che cosa entra nel processo?
- Attraverso quali stadi passa?
- Che cosa cambia da uno stadio al successivo?
- Qual è l’output o lo stato finale?
Se stai seguendo opportunità commerciali attraverso qualificazione, proposta e negoziazione, stai osservando una sales pipeline.
Se stai misurando come una grande quantità di persone si riduce lungo diverse fasi di conversione, il funnel può essere il modello più adatto.
Se stai definendo trigger, condizioni, azioni e responsabilità, stai ragionando soprattutto in termini di workflow.
Se invece dati, codice o altri output tecnici vengono elaborati attraverso passaggi collegati, sei nell’accezione informatica.
Il nome conta meno del problema che il modello deve aiutarti a risolvere.
Conclusione
Pipeline indica, in senso generale, un flusso organizzato in stadi attraverso cui qualcosa avanza verso un risultato.
L’origine del termine è fisica, ma la metafora funziona bene in molti sistemi perché permette di rendere visibili stato, passaggi e dipendenze.
Nel commerciale può mostrare dove si trova un’opportunità. Nel marketing può collegare acquisizione, qualificazione e passaggio alle vendite. Nei dati descrive il percorso dalle sorgenti alla destinazione. Nello sviluppo software può organizzare build, test e deployment. Nel machine learning può coordinare preparazione, training, validazione e previsione.
Non serve quindi memorizzare una definizione diversa per ogni settore.
Quando incontri il termine, chiediti:
che cosa sta attraversando quali fasi, cosa succede durante il percorso e quale risultato deve uscirne?
Se sai rispondere, hai già individuato il significato corretto e puoi anche capire quando il modello più adatto sarebbe invece un funnel o un workflow.