
Un bug informatico è un difetto che fa sì che un software o un sistema si comporti diversamente da quanto previsto. Può tradursi in un pulsante che non risponde, un calcolo sbagliato, un crash, una funzione che smette di funzionare soltanto in determinate condizioni o, nei casi più delicati, in una debolezza con conseguenze sulla sicurezza.
Definirlo semplicemente come “un errore nel codice”, però, è utile solo fino a un certo punto. Non ogni comportamento inatteso è automaticamente un bug, e distinguere la causa dal difetto e dal malfunzionamento osservato aiuta a capire molto meglio sia il debugging sia la segnalazione del problema.
In questa guida vediamo cosa significa davvero bug in informatica, quali forme può assumere, come distinguerlo da termini come errore, glitch, vulnerabilità ed exploit e, soprattutto, come si passa dal sintomo alla diagnosi e alla correzione.
Cos’è un bug informatico
Nel linguaggio comune si tende a chiamare bug qualunque cosa “non funzioni”. In ambito software conviene essere un po’ più precisi.
Un bug è un difetto presente nel software o in un altro work product che può compromettere il comportamento previsto o l’uso per cui quel prodotto è stato progettato.
Il punto importante è il confronto fra ciò che il sistema dovrebbe fare e ciò che fa realmente. Se un modulo dovrebbe calcolare uno sconto del 20% e in determinate condizioni ne applica uno del 2%, abbiamo una deviazione osservabile dal comportamento atteso. La causa potrebbe trovarsi nel codice, nei requisiti, nello stato del programma o nell’interazione fra più componenti.
La terminologia del testing software distingue inoltre chiaramente errore umano, difetto e failure. L’ISTQB descrive la catena concettuale come un errore commesso da una persona che può introdurre un difetto; quando quel difetto viene eseguito può produrre un failure osservabile. ISTQB Testing Body of Knowledge
Bug, errore, difetto e failure: cosa cambia
Questi termini vengono spesso usati come sinonimi, ma descrivono livelli differenti del problema.
| Termine | Che cosa indica | Esempio |
|---|---|---|
| Errore | azione o decisione umana sbagliata | uno sviluppatore interpreta male una regola |
| Difetto / bug | problema introdotto nel software, requisito o altro artefatto | la formula implementata usa il valore sbagliato |
| Failure | comportamento errato osservato durante l’esecuzione | il programma restituisce un totale scorretto |
| Causa radice | condizione che ha originato il problema | requisito ambiguo, logica errata, assunzione non valida |
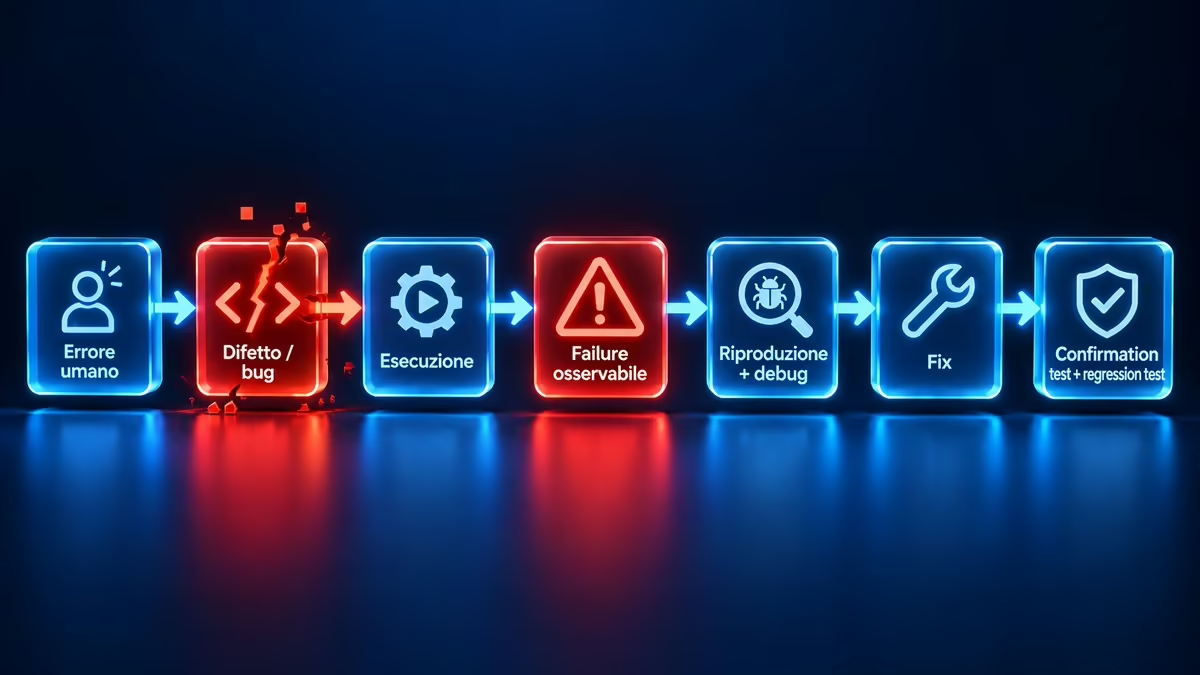
La distinzione è utile perché il sintomo che vedi sullo schermo non coincide necessariamente con il punto in cui il problema è stato introdotto.
Immagina un ecommerce che mostra un prezzo finale sbagliato. Il malfunzionamento è visibile nel checkout, ma il difetto potrebbe trovarsi nel calcolo dell’IVA, nella conversione della valuta, in un dato ricevuto da un servizio esterno o in una regola commerciale formulata male.
Correggere soltanto l’ultima riga coinvolta può quindi nascondere la causa senza risolverla davvero.
Quando un comportamento anomalo non è necessariamente un bug
Un risultato che sorprende l’utente merita un controllo, ma non dimostra da solo la presenza di un difetto software.
Un comportamento può dipendere, per esempio, da una configurazione sbagliata, da un ambiente non supportato, da un servizio esterno non disponibile, da dati non validi o da una limitazione dichiarata del prodotto.
Anche le aspettative contano.
Se un modulo accetta soltanto file fino a una dimensione documentata e rifiuta correttamente un file più grande, il rifiuto può essere scomodo ma non è necessariamente un bug. Se invece il sistema dichiara di supportare quel file e va in crash durante l’upload, c’è una discrepanza da indagare.
Per questo una buona diagnosi parte sempre da due domande:
cosa doveva succedere?
cosa è successo realmente?
Senza questa coppia è facile confondere un difetto con una richiesta di nuova funzionalità, un problema di configurazione o un semplice malinteso sul funzionamento del prodotto.
Perché si chiama bug: la storia della falena
La storia più famosa risale al computer elettromeccanico Harvard Mark II.
Nel 1947 alcuni tecnici trovarono una falena rimasta intrappolata in un relè della macchina. L’insetto venne applicato al registro operativo con la celebre annotazione sul primo caso reale di “bug” trovato.
L’episodio è documentato e il registro è conservato dallo Smithsonian. Ma c’è una correzione importante rispetto al racconto che spesso viene ripetuto online: quella falena non inventò la parola bug.
Il National Museum of American History spiega che il termine veniva già usato nell’Ottocento per indicare problemi e interferenze nei sistemi elettrici. Grace Hopper faceva parte del gruppo che lavorava sul Mark II e contribuì alla diffusione dell’aneddoto e del lessico informatico associato, ma il concetto era precedente. Smithsonian: la storia del computer bug
È un dettaglio storico, ma anche un buon esempio di come convenga distinguere un fatto documentato da una versione semplificata diventata popolare.
Tipi di bug software e cause più comuni
Non esiste una sola tassonomia universale dei tipi di bug software. La classificazione per errori di sintassi, logica e runtime è utile per imparare, ma nei progetti reali i difetti vengono classificati anche per componente, gravità, origine, ambiente, rischio o comportamento.
Parlare di tipi di bug software serve quindi soprattutto a organizzare problemi con caratteristiche simili e a scegliere un percorso di diagnosi più adatto, non a inserire ogni difetto in una categoria rigida e definitiva.
Un singolo bug può inoltre appartenere a più categorie contemporaneamente.
Errori di sintassi, logica e requisiti
Un errore di sintassi viola le regole del linguaggio di programmazione. Una parentesi mancante, una parola chiave sbagliata o una struttura non valida possono impedire al codice di essere interpretato o compilato.
Questi problemi vengono spesso intercettati molto presto dagli strumenti di sviluppo. Per questo non tutti gli sviluppatori chiamerebbero “bug del prodotto” un semplice errore di sintassi scoperto prima ancora che il programma possa essere eseguito.
Più insidiosi sono gli errori logici. Il codice può essere formalmente valido e funzionare senza crash, ma produrre il risultato sbagliato.
Per esempio:
prezzo = 100
sconto = 20

totale = prezzo - sconto / 100
Il programma può essere eseguito, ma la formula non applica uno sconto del 20%. Il problema non è nella grammatica del linguaggio: è nella logica.
Un altro livello riguarda i requisiti. Se una regola viene descritta male e poi implementata fedelmente, il codice può essere coerente con il documento e tuttavia non soddisfare il bisogno reale. In casi simili limitarsi a cercare “la riga sbagliata” nel codice rischia di far perdere di vista la vera origine del difetto.
Bug di runtime, memoria, stato e concorrenza
Alcuni problemi emergono soltanto mentre il programma è in esecuzione.
Un’applicazione può tentare di usare una risorsa che non esiste, elaborare un valore imprevisto, accedere a memoria non valida oppure raggiungere uno stato che il programmatore non aveva considerato.
Ci sono poi problemi che dipendono dall’ordine degli eventi. Due operazioni eseguite contemporaneamente possono interferire fra loro, oppure una funzione può comportarsi correttamente soltanto se una determinata variabile è già stata inizializzata.
Sono bug particolarmente fastidiosi perché il codice può funzionare cento volte e fallire alla centounesima.
Nei linguaggi che forniscono informazioni diagnostiche, leggere correttamente stack trace ed errori dell’interprete aiuta a ricostruire il percorso che ha portato al problema. Nella nostra guida su programmare in Python partiamo proprio dal rapporto fra codice, esecuzione, output ed errore prima di aggiungere strumenti più avanzati.
Compatibilità, integrazioni, configurazione e regressioni
Un software moderno raramente funziona da solo.
Dipende da sistemi operativi, browser, API, database, librerie, servizi esterni, configurazioni e versioni differenti. Un difetto può quindi emergere soltanto quando due componenti interagiscono in una determinata combinazione.
Qui bisogna evitare una semplificazione: un problema di compatibilità non è automaticamente un bug del software che stai osservando. Se l’ambiente non è supportato, la causa potrebbe essere esterna allo scope dichiarato del prodotto.
Le regressioni sono un caso diverso. Una funzione che prima funzionava correttamente può rompersi dopo una modifica apparentemente scollegata.
Immagina di cambiare il sistema di autenticazione e scoprire che una vecchia funzione di esportazione non riesce più a scaricare i file. Il difetto è stato introdotto dalla modifica, ma si manifesta in un’area che non sembrava direttamente coinvolta.
È uno dei motivi per cui correggere un bug non significa soltanto far sparire il sintomo.
Bug, glitch, vulnerabilità ed exploit: le differenze
Quattro termini vengono spesso messi nello stesso contenitore, ma non indicano la stessa cosa.
| Termine | Significato operativo |
|---|---|
| Bug | difetto che può produrre un comportamento diverso da quello previsto |
| Glitch | termine informale per un’anomalia, spesso breve o intermittente |
| Vulnerabilità | debolezza che può essere sfruttata o attivata da una minaccia |
| Exploit | tecnica, codice o procedura usata per sfruttare una vulnerabilità |
Bug vs glitch
“Glitch” è un termine meno rigoroso di bug.
Viene spesso usato per indicare un’anomalia momentanea: un elemento grafico che scompare per un istante, un’animazione che si comporta in modo strano o un evento anomalo che poi non si ripresenta.
Un glitch può essere causato da un bug, ma il termine descrive soprattutto ciò che l’utente osserva, non necessariamente la causa tecnica.
Se riesci a ricondurre l’anomalia a un difetto riproducibile nel software, parlare di bug diventa più preciso. Se hai soltanto un comportamento occasionale e non conosci ancora la causa, “glitch” resta una descrizione informale del sintomo.
Bug vs vulnerabilità
Un bug non è automaticamente una vulnerabilità.
Il NIST definisce una vulnerabilità come una debolezza in un sistema, nelle procedure di sicurezza, nei controlli o nell’implementazione che può essere sfruttata o attivata da una fonte di minaccia. NIST: definizione di vulnerabilità
Un pulsante che ha il colore sbagliato può essere un difetto, ma difficilmente costituisce una vulnerabilità.
Un errore nella validazione degli input che permette a un utente non autorizzato di eseguire operazioni riservate è invece un problema di sicurezza.
Il rapporto corretto è quindi:
alcuni bug → possono creare una vulnerabilità
ma
non tutti i bug → sono vulnerabilità
Questa distinzione è importante anche nel modo in cui il problema viene segnalato. Un’anomalia grafica può essere discussa in un normale tracker pubblico; una possibile vulnerabilità richiede spesso un canale di security disclosure dedicato.
Vulnerabilità vs exploit
La vulnerabilità è la debolezza.
L’exploit è ciò che permette di sfruttarla.
Se una funzione accetta dati che non dovrebbe accettare, quella condizione può rappresentare la vulnerabilità. Il codice o la procedura costruiti appositamente per trasformarla in accesso non autorizzato rappresentano invece l’exploit.
Separare i due concetti evita frasi imprecise come “il sistema contiene un exploit” quando in realtà contiene una debolezza che può essere sfruttata.
Come si trova e si corregge un bug
Capire come correggere un bug significa prima di tutto smettere di inseguire il sintomo e costruire un caso riproducibile.
Il debugging è il processo che porta dal comportamento anomalo alla causa del problema e alla verifica della correzione. IBM lo descrive come un’attività di individuazione, isolamento e risoluzione dei problemi di programmazione. IBM: che cos’è il debugging
Riprodurre il problema prima di cercarne la causa
Se sai riprodurre un bug, puoi modificare una condizione alla volta e osservare che cosa cambia.
Parti da un caso concreto:
1. apro la pagina
2. seleziono il prodotto A
3. applico il coupon B
4. passo al checkout
5. il totale visualizzato è errato
Poi prova a ridurre il caso.
Il problema compare senza coupon? Succede con tutti i prodotti? Solo con un determinato account? Solo su un browser? È iniziato dopo un aggiornamento?
Ogni variabile eliminata restringe il campo della ricerca.
Un bug intermittente può comunque essere reale. La difficoltà sta nel fatto che, finché non individui le condizioni che lo attivano, non hai un test affidabile con cui verificare la correzione.
Debugging, log, breakpoint e test
Una volta ottenuto un caso riproducibile puoi osservare ciò che succede all’interno del programma.
I log mostrano eventi, errori e valori registrati durante l’esecuzione.
I breakpoint fermano il programma in un punto preciso.
Un debugger consente di seguire il flusso, ispezionare variabili e stack delle chiamate e confrontare lo stato reale con quello che ti aspettavi.
Un ambiente come Xcode integra il debugger direttamente nel ciclo di sviluppo, mentre in altri contesti puoi lavorare con strumenti da riga di comando, log o pannelli diagnostici.
Su WordPress il principio è lo stesso ma cambia l’ambiente: la nostra guida al debug WordPress mostra come utilizzare log e strumenti della piattaforma per restringere la causa di un malfunzionamento.
Il punto non è usare più strumenti possibile. È raccogliere l’informazione che manca per spiegare dove il comportamento reale devia da quello previsto.
Fix, patch, workaround e regression test
Quando individui la causa puoi intervenire.
Un fix è la correzione del difetto.
Una patch è uno dei modi con cui una correzione può essere distribuita.
Un workaround evita o limita il problema senza necessariamente eliminare la causa. Se un’applicazione va in crash soltanto importando un particolare formato, convertirlo prima dell’importazione può essere un workaround: permette di lavorare, ma il difetto originale rimane.
Capire come correggere un bug in modo affidabile significa quindi distinguere la soluzione definitiva da una misura temporanea e verificare l’effetto della modifica sul resto del sistema.
Dopo il fix servono almeno due domande:
il problema originale è davvero scomparso?
la modifica ha rotto qualcos’altro?
Nel testing software queste domande corrispondono a controlli diversi. Il confirmation testing verifica che il failure causato dal difetto non si ripresenti dopo la correzione; il regression testing cerca invece effetti indesiderati introdotti dalla modifica in altre parti del software.
Correggere senza verificare entrambe le dimensioni significa rischiare di sostituire un bug con un altro.
Come segnalare un bug in modo utile
Un bug report utile permette a chi lo riceve di ricostruire il problema senza dover indovinare cosa sia successo.
Sapere come segnalare un bug significa soprattutto fornire abbastanza contesto perché il problema possa essere riprodotto, confrontato con il comportamento atteso e analizzato senza una lunga serie di richieste successive.
Scrivere soltanto “non funziona” lascia aperte quasi tutte le domande importanti.
Le linee guida di Mozilla per la segnalazione dei bug insistono in particolare su passaggi precisi per riprodurre il problema e sulla separazione fra risultato atteso e risultato effettivo. Mozilla Bugzilla: linee guida per un bug report
Un modello pratico può essere questo:
Titolo:
Descrizione breve e specifica del problema

Versione:
Versione dell'applicazione, plugin o sistema

Ambiente:
Sistema operativo, browser, dispositivo o configurazione rilevante

Frequenza:
Sempre / spesso / occasionalmente / una sola volta

Precondizioni:
Stato necessario prima di riprodurre il problema

Passaggi per riprodurre:
1.
2.
3.

Risultato atteso:
Cosa avrebbe dovuto accadere

Risultato effettivo:
Cosa è accaduto realmente

Informazioni aggiuntive:
Messaggi di errore, log, screenshot o video utili
Un buon titolo descrive il sintomo con precisione. “Problema checkout” dice poco; “Il checkout mostra un totale errato dopo l’applicazione del coupon” restringe già il contesto.
Anche gli allegati vanno scelti con criterio. Uno screenshot può mostrare il sintomo, mentre un log può aiutare a capire la causa. Non allegare però password, token, chiavi API, dati personali o altre informazioni sensibili senza averle rimosse.
Se sospetti una vulnerabilità di sicurezza, controlla inoltre se il produttore dispone di un canale privato dedicato alla segnalazione. Pubblicare immediatamente dettagli sfruttabili in un issue tracker aperto può creare un rischio che una normale segnalazione funzionale non presenta.
Domande frequenti sui bug
Cosa significa “buggato”?
“Buggato” è un termine colloquiale usato per indicare un software, una funzione o talvolta un dispositivo che presenta uno o più bug.
Dire “questa funzione è buggata” comunica che il comportamento osservato sembra dipendere da un difetto, ma non costituisce una diagnosi tecnica.
Prima di considerare identificata la causa bisogna comunque verificare condizioni, ambiente e riproducibilità.
Un bug è la stessa cosa di un virus?
No.
Un bug è un difetto o un’anomalia nel software. Un virus è invece una forma di software malevolo progettata per propagarsi infettando altri file o sistemi.
Un bug può eventualmente creare una vulnerabilità sfruttabile da malware o attaccanti, ma questo non trasforma il bug stesso in un virus.
Esistono anche bug hardware?
Sì.
Il termine viene usato soprattutto per il software, ma può riferirsi anche a difetti nella logica o progettazione hardware e firmware.
Il NIST Bugs Framework, per esempio, utilizza esplicitamente il concetto di bug anche per software, firmware e logica dei circuiti hardware.
In pratica, ciò che cambia è il supporto nel quale si trova il difetto; rimane l’idea di una deviazione fra comportamento previsto e comportamento prodotto.
Conclusione
Il modo più utile di pensare a un bug non è “qualcosa nel computer è andato storto”, ma una deviazione da spiegare.
Prima distingui ciò che l’utente osserva dalla causa. Poi chiarisci il comportamento atteso, riproduci il problema, restringi le condizioni che lo provocano e raccogli evidenze sufficienti per individuare il difetto.
Solo a quel punto ha senso parlare di fix.
E quando il fix è pronto, il lavoro non è terminato: devi verificare che il problema originale non si ripresenti e che la modifica non abbia introdotto regressioni altrove.
La stessa logica vale anche se non sei lo sviluppatore. Una segnalazione precisa, con ambiente, passaggi, risultato atteso e risultato effettivo, può trasformare un generico “non funziona” in un problema realmente diagnosticabile.