
Mistral AI viene spesso presentata come l’alternativa europea a ChatGPT. È un modo rapido per inquadrarla, ma ormai è anche un modo piuttosto impreciso per capire cosa offre.
Mistral AI non è un singolo chatbot e non identifica un solo modello. Attorno al brand convivono un assistente rivolto agli utenti, una piattaforma per sviluppatori, strumenti di amministrazione e una famiglia piuttosto ampia di modelli generalisti e specialistici.
È una distinzione simile a quella che vale per un Large Language Model e il prodotto costruito attorno a quel modello: l’interfaccia che utilizzi, il modello che genera l’output e l’infrastruttura che lo esegue sono livelli collegati, ma non equivalenti.
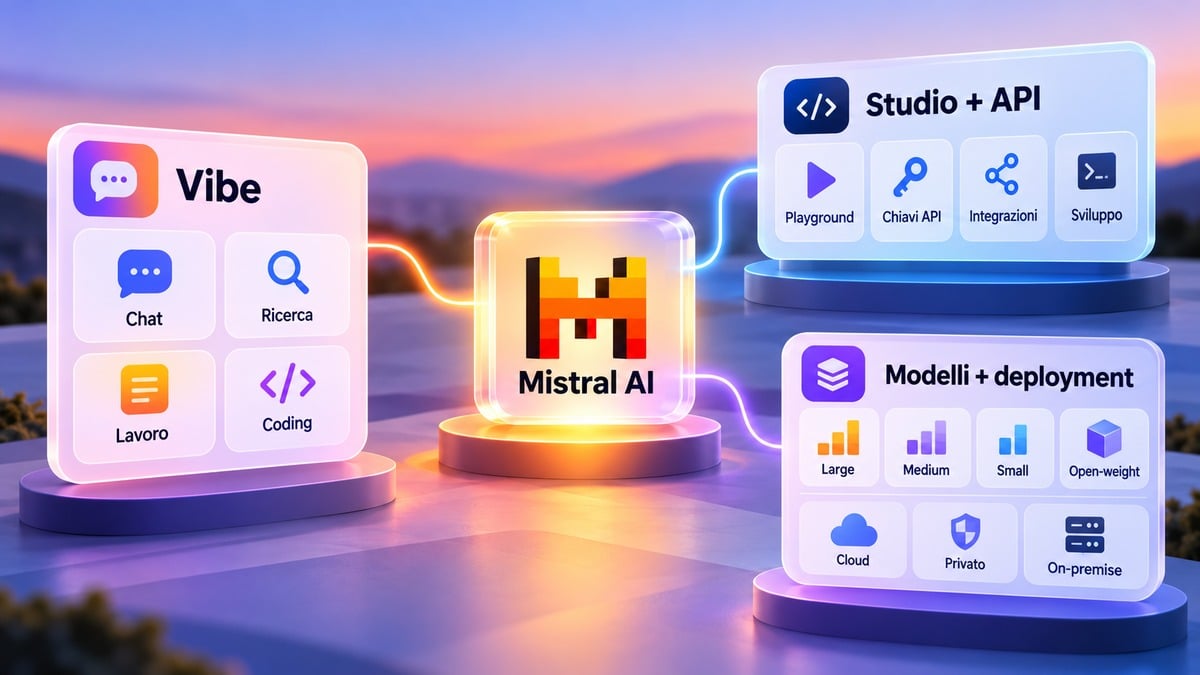
Capire questa struttura è il modo più utile per valutare Mistral. Se vuoi semplicemente un assistente AI puoi partire da Vibe. Se stai costruendo un’applicazione entrano in gioco Studio e le API. Se invece contano controllo dell’infrastruttura, licenze e deployment privato, la parte interessante diventa la disponibilità di modelli open-weight e delle relative opzioni di distribuzione.
Cos’è Mistral AI e perché non è un singolo chatbot
Mistral AI è un ecosistema di prodotti e modelli di intelligenza artificiale. La sua documentazione distingue oggi tre superfici principali: Vibe, Studio e Admin. A queste si affianca il catalogo dei modelli, che può essere utilizzato attraverso i servizi Mistral o, quando la specifica release e la relativa licenza lo permettono, attraverso infrastrutture differenti.
La distinzione è più importante di quanto sembri.
| Livello | A cosa serve | Quando ti interessa |
|---|---|---|
| Vibe | Assistente AI per produttività e coding | Vuoi utilizzare direttamente Mistral |
| Studio | Console developer, Playground e API | Vuoi integrare i modelli in software e workflow |
| Admin | Utenti, billing, accessi e policy | Devi governare l’uso dell’AI in un’organizzazione |
| Modelli Mistral | Motori generalisti e specialistici | Devi scegliere capacità, costo, licenza o deployment |
La documentazione ufficiale della piattaforma descrive quindi un sistema più vicino a una piattaforma AI completa che a un semplice servizio di chat.
Azienda, prodotti e modelli: tre livelli da non confondere
Quando leggi “Mistral” online puoi trovare almeno tre significati diversi.
Il primo è Mistral AI come azienda. Il secondo è un prodotto come Vibe. Il terzo è una famiglia di modelli come Mistral Large, Medium, Small o Ministral.
Questo spiega perché domande apparentemente semplici come “Mistral è gratis?” oppure “Mistral è open source?” non hanno una risposta unica.
Vibe può avere un piano gratuito anche se l’utilizzo di determinati modelli tramite API è a consumo. Un modello può rendere disponibili i pesi con una licenza permissiva mentre un altro può avere condizioni differenti. E utilizzare Vibe nel cloud non equivale a eseguire un modello Mistral sulla propria infrastruttura.
La regola pratica è quindi:
prodotto → modello → modalità di accesso → licenza → trattamento dei dati
Saltare uno di questi passaggi porta facilmente a conclusioni sbagliate.
Da Le Chat a Vibe: cosa è cambiato
Se conoscevi Mistral attraverso Le Chat, il nome da cercare adesso è Mistral Vibe.
Le Chat è diventato Vibe e account, conversazioni, impostazioni e piano vengono mantenuti. Mistral presenta Vibe come un agente unificato per produttività e coding, accessibile attraverso web e mobile ma anche, per lo sviluppo, tramite terminale ed editor compatibili.
Il cambiamento non è quindi soltanto nominale.
Ridurre Vibe a “una chat con un modello Mistral” significa ignorare buona parte del prodotto: può lavorare con ricerca web, documenti, strumenti collegati e attività articolate, mentre la parte dedicata al codice può entrare direttamente nel workflow di sviluppo.
La pagina ufficiale di Mistral Vibe indica inoltre supporto a numerosi connector e compatibilità con MCP.
Come si usa Mistral AI oggi
Il modo corretto di iniziare dipende da ciò che vuoi fare.
Per provarla come utente non devi scegliere una model card, configurare token o installare un runtime: parti da Vibe.
Se invece stai costruendo un prodotto, la superficie rilevante diventa Studio. Se l’obiettivo è mantenere un controllo maggiore sull’infrastruttura, puoi valutare modelli e opzioni di deployment separatamente.
Sono tre percorsi diversi.
Vibe per chat, ricerca, lavoro e coding
Mistral Vibe è la strada più semplice per usare direttamente l’ecosistema Mistral.
Per chi vuole iniziare senza passare da API o deployment, Mistral Vibe è quindi il punto di accesso più immediato all’ecosistema.
Il piano gratuito permette di provare chat, ricerca web e attività di base con limiti di utilizzo. I piani superiori aumentano la capacità disponibile e aggiungono funzionalità più adatte a lavoro continuativo, attività agentiche e coding.
Per un utente che vuole capire se Mistral può sostituire o affiancare un altro assistente AI, partirei da qui.
Non sceglierei Vibe perché “usa Mistral” in astratto. Lo confronterei sul lavoro reale: qualità delle risposte sul tuo dominio, ricerca, gestione dei file, coding, strumenti collegati e limiti del piano.
È lo stesso criterio che conviene applicare quando si scelgono gli AI tools: aggiungere un assistente ha senso quando cambia materialmente ciò che riesci a fare, non semplicemente perché utilizza una famiglia di modelli diversa.
Studio e API per sviluppatori
Mistral Studio è il livello pensato per chi vuole costruire con i modelli.
Puoi creare e gestire le chiavi API, sperimentare nel Playground e integrare modelli di testo, audio, OCR e altre capacità nelle tue applicazioni. Studio non va quindi confuso con Vibe: uno è un prodotto che utilizzi, l’altro è un ambiente con cui costruisci.
L’API diventa interessante quando vuoi controllare direttamente:
- modello utilizzato;
- prompt e system instructions;
- input e output dell’applicazione;
- strumenti e function calling;
- consumo e costi;
- logica del workflow;
- integrazione con i tuoi sistemi.
Questo controllo comporta però anche più responsabilità.
Vibe ti offre un’esperienza già costruita. Con l’API devi progettare il prodotto attorno al modello: gestione degli errori, sicurezza, controlli sugli output, osservabilità, costi e comportamento dell’applicazione restano problemi tuoi.
Modelli locali, cloud e deployment privato
La terza strada è quella che rende Mistral particolarmente interessante per alcuni progetti tecnici: non tutti gli scenari devono passare dallo stesso servizio cloud.
La disponibilità di modelli open-weight e le opzioni Enterprise consentono di valutare deployment differenti. Mistral indica per i clienti Enterprise possibilità che includono infrastruttura privata, cloud privato e installazioni on-premise.
Questo non significa che eseguire un modello localmente sia automaticamente la soluzione migliore.
Passare da API gestita a infrastruttura propria sposta verso di te diversi problemi: GPU, memoria, runtime di inferenza, aggiornamenti, scaling, logging, sicurezza e costi operativi.
Il controllo aumenta, ma aumenta anche ciò che devi gestire.
Quali modelli Mistral usare
Il catalogo Mistral è cresciuto abbastanza da rendere poco utile la domanda “qual è il miglior modello Mistral?”.
La domanda migliore è: qual è il modello adatto al carico di lavoro che devo eseguire?
La documentazione ufficiale dei modelli Mistral distingue modelli generalisti, specialistici e release con caratteristiche differenti per capacità, costo, apertura e dimensioni.
Per orientarti tra i modelli Mistral, conviene partire dal tipo di workload invece che dal nome della release.
Una mappa semplificata è più utile di un catalogo completo:
| Famiglia | Punto di forza | La valuterei soprattutto per |
|---|---|---|
| Mistral Large 4 | Modello generalista multimodale di fascia alta | Task complessi, reasoning, coding e workflow agentici |
| Mistral Medium 3.5 | Equilibrio fra capacità, multimodalità e coding | Applicazioni generaliste e agentiche |
| Mistral Small 4 | Maggiore efficienza e costo inferiore | Volumi elevati e task dove non serve il modello più grande |
| Ministral 3 | Varianti più compatte | Edge, deployment più contenuti e vincoli hardware |
| Modelli specialistici | Ottimizzazione per un dominio | OCR, voce, coding e altri workload verticali |
Mistral Large 4: cosa offre e cosa significa Public Preview
Mistral Large 4 è il modello generalista più ambizioso della famiglia.
È un modello multimodale con architettura Mixture-of-Experts: la documentazione indica 52 miliardi di parametri attivi, 1,05 trilioni di parametri complessivi e una finestra di contesto fino a un milione di token. È orientato anche a coding, tool use e workflow agentici.
C’è però un caveat importante: Public Preview non significa automaticamente release definitiva.
La fase preview indica che il modello può già essere usato attraverso le superfici supportate, ma capacità, condizioni operative, pricing o disponibilità possono ancora cambiare. Mistral lo presenta inoltre come open-weight, mentre al momento della verifica la distribuzione dei pesi è indicata come in arrivo.
Se devi mettere un modello in produzione, non sceglierei quindi Large 4 soltanto perché è il più nuovo o il più grande.
Verificherei prima stabilità richiesta, disponibilità nella modalità di deployment scelta, costo, latenza e qualità sul tuo dataset.
Medium, Small e Ministral: come scegliere la famiglia giusta
Mistral Medium 3.5 occupa una fascia interessante per applicazioni che richiedono buone capacità generaliste, multimodalità e coding senza partire necessariamente dal modello più grande. La release corrente utilizza una licenza Modified MIT e supporta un contesto ampio.
Mistral Small 4 porta instruct, reasoning e coding nello stesso modello con un’impostazione più orientata all’efficienza. La relativa model card lo distribuisce sotto Apache 2.0.
La famiglia Ministral 3 scende invece su taglie da 14B, 8B e 3B, interessanti soprattutto quando hardware, latenza o deployment edge entrano nella decisione.
La dimensione non dovrebbe però diventare una classifica.
Un modello più grande può avere senso se aumenta abbastanza la qualità sul task da compensare costo e latenza. Un modello più piccolo può essere la scelta migliore quando devi processare molti input, rispondere rapidamente o utilizzare hardware più limitato.
Per questo la selezione corretta dovrebbe seguire:
task → requisito qualitativo → latenza → costo → deployment → test
e non:
numero di parametri → modello più grande → scelta automatica
Modelli specialistici per codice, voce e documenti
Mistral non offre soltanto LLM generalisti.
Nel catalogo compaiono famiglie specializzate per attività come document intelligence, trascrizione, sintesi vocale e sviluppo software.
È un dettaglio importante soprattutto per chi utilizza le API.
Se devi estrarre struttura da migliaia di documenti, non è detto che un modello generalista sia il punto di partenza migliore. Lo stesso vale per trascrizione o coding: un modello specialistico può offrire un rapporto più sensato fra capacità e costo.
L’errore sarebbe costruire tutto attorno allo stesso LLM solo perché è il modello flagship.
Mistral AI è open source?
La risposta breve è: dipende da quale modello stai considerando e da cosa intendi con open source.
La distinzione è importante anche in una guida più generale all’AI open source: rendere disponibili i pesi di un modello non rende automaticamente aperti il dataset di training, l’intera pipeline, l’infrastruttura cloud e ogni componente del prodotto.
Con Mistral questa distinzione è particolarmente utile perché il catalogo non utilizza una sola licenza per tutto.
Open source e open-weight non significano la stessa cosa
Un modello open-weight rende disponibili i pesi necessari all’inferenza.
Questo può consentirti di eseguirlo su infrastruttura controllata da te, studiarne il comportamento e, nei limiti della licenza, adattarlo o integrarlo in sistemi differenti.
“Open source” può invece suggerire un livello di apertura più ampio, che può comprendere codice, materiali di training, metodologia e altri elementi necessari a comprendere o riprodurre il sistema.
Per questo non userei “Mistral è open source” come descrizione universale dell’azienda.
Userei piuttosto una formulazione più precisa:
Mistral distribuisce diversi modelli aperti o open-weight, ma apertura e licenza vanno verificate sulla singola release.
Apache 2.0, licenze modificate e uso commerciale
Il centro assistenza ufficiale sulle licenze dei modelli Mistral spiega che molti modelli aperti vengono distribuiti con Apache 2.0, mentre alcuni utilizzano una Modified MIT License con condizioni ulteriori in determinati scenari commerciali.
È il motivo per cui la model card conta più dell’etichetta “open”.
Prima di inserire un modello in un prodotto commerciale controllerei sempre:
modello esatto → versione → licenza → condizioni commerciali → modalità di distribuzione
La famiglia del modello, da sola, non basta.
Quanto costa Mistral AI
I prezzi di Mistral AI vanno divisi in due categorie: il costo dell’assistente Vibe e il costo dei modelli utilizzati tramite API.
Sono due modelli commerciali differenti.
Per confrontare davvero i prezzi di Mistral AI, quindi, conviene separare l’abbonamento dell’assistente dal consumo dei modelli via API.
Vibe Free, Pro, Team ed Enterprise
Il listino ufficiale Mistral presenta questi livelli principali:
| Piano | Prezzo indicato | A chi lo vedo adatto |
|---|---|---|
| Free | Gratuito | Test e utilizzo personale con limiti |
| Pro | $14,99/mese | Utilizzo individuale più intenso, task complessi e coding |
| Team | $24,99/utente/mese | Workspace condiviso e controlli per team |
| Enterprise | Personalizzato | Governance, modelli e deployment privati |
I prezzi indicati sono al netto delle imposte e i piani sono soggetti ai limiti e alle condizioni di utilizzo dichiarati da Mistral.
Non valuterei quindi Free e Pro soltanto chiedendomi “quale modello ottengo”.
Per Vibe contano anche numero e durata delle attività, ricerca web, coding, spazio disponibile, strumenti collegati e funzioni agentiche. Il valore del piano deriva dall’intero prodotto.
Prezzi API: perché il costo cambia in base al modello e all’utilizzo
Con l’API cambia completamente il meccanismo.
Il costo viene normalmente calcolato sul volume elaborato, distinguendo token di input e token di output; modello e servizio utilizzato modificano il prezzo. Mistral applica inoltre condizioni specifiche per alcune modalità di elaborazione, come il batch.
Questo significa che “quanto costa Mistral?” non ha una cifra unica per uno sviluppatore.
Un’applicazione che invia prompt brevi a un modello efficiente e genera risposte corte ha un profilo di costo diverso da un agente che legge repository, documenti estesi e produce output lunghi.
Prima di scegliere un modello via API stimerei quindi:
richieste previste × token medi in ingresso × token medi in uscita × modello
e confronterei il risultato sul workload reale.
Il modello più economico per milione di token, infatti, non è necessariamente quello che produce il costo totale inferiore: se serve più contesto, più retry o più passaggi per ottenere il risultato corretto, il conto cambia.
Privacy e dati: cosa sapere prima di usare Mistral
Uno dei motivi per cui Mistral viene spesso presa in considerazione è il tema della sovranità tecnologica e del controllo sui dati.
Qui conviene però evitare una scorciatoia: essere un’azienda europea non significa automaticamente che ogni conversazione sia esclusa dall’addestramento o che ogni servizio funzioni dentro la tua infrastruttura.
Prodotto, piano e impostazioni fanno la differenza.
Quando conversazioni e documenti possono essere usati per il training
Il centro assistenza Mistral sul training dei dati specifica che, sul normale Vibe, input e output possono essere utilizzati per i programmi di miglioramento dei modelli e che l’utente può effettuare l’opt-out dalle impostazioni.
Per Enterprise l’impostazione predefinita è differente: i clienti risultano esclusi dal training per default, con gestione a livello amministrativo.
C’è un altro dettaglio da non perdere: le impostazioni di Vibe e quelle relative a Studio/API sono separate.
Disattivare un’opzione in un prodotto non significa necessariamente aver configurato anche l’altro. Se utilizzi entrambi, i controlli vanno verificati separatamente.
Questo è più utile di un generico “Mistral è più privata”.
La domanda corretta è:
quale servizio sto usando, con quale piano e quali impostazioni?
Enterprise, self-hosting e sovranità dei dati: cosa cambia davvero
Il controllo cambia in modo più sostanziale quando cambia il percorso dei dati.
Se utilizzi un normale servizio cloud, prompt e contenuti devono raggiungere l’infrastruttura necessaria a elaborare la richiesta.
Con un deployment privato o on-premise puoi invece progettare un’architettura in cui una parte molto maggiore dell’infrastruttura rimane sotto il controllo dell’organizzazione. Mistral include il deployment privato fra le possibilità dei piani Enterprise.
Questo può essere rilevante per aziende con requisiti stringenti su:
- residenza dei dati;
- sicurezza;
- accesso amministrativo;
- audit;
- integrazione con sistemi interni;
- dipendenza dal provider.
Non significa comunque che “self-hosted = sicuro”.
Se gestisci l’infrastruttura, diventano tuoi anche patching, controllo degli accessi, segreti, logging, rete, backup e protezione dei dati. La sovranità aumenta il controllo; non elimina il lavoro necessario per esercitarlo bene.
Mistral AI rispetto a ChatGPT, Claude, Gemini e DeepSeek
Chiedere se Mistral AI sia “migliore di ChatGPT” porta facilmente a un confronto poco utile.
Assistenti e modelli generalisti ormai coprono molte delle stesse attività. La differenza reale emerge spesso nell’ecosistema: strumenti, deployment, licenze, integrazioni, prezzo e modalità con cui vuoi lavorare.
Userei questa matrice come punto di partenza:
| Se il tuo scenario è soprattutto… | Valuterei per primo… | Perché |
|---|---|---|
| Controllo su modelli, pesi e deployment | Mistral | Ecosistema che combina servizi gestiti e modelli aperti |
| Assistente generalista con ecosistema molto ampio | ChatGPT | Copertura trasversale di molti workflow |
| Documenti, coding e workflow agentici | Claude AI | Ecosistema Anthropic orientato anche al lavoro operativo |
| Integrazione stretta con servizi Google | Gemini AI | Il contesto Google può diventare parte importante del workflow |
| Modelli aperti e sperimentazione su infrastruttura controllata | DeepSeek | Famiglia da considerare quando pesi e deployment contano molto |
Non è una classifica.
Una piccola differenza di benchmark può essere irrilevante se il modello migliore sulla carta non si integra con il tuo ambiente, costa troppo sul volume reale o non soddisfa i requisiti sui dati.
Quando sceglierei Mistral
Mistral diventa particolarmente interessante quando controllo e flessibilità fanno parte del requisito, non sono dettagli successivi.
La metterei nella shortlist se volessi:
- un assistente generalista diverso dai grandi ecosistemi statunitensi più consolidati;
- utilizzare API con più famiglie di modelli;
- valutare modelli open-weight;
- scegliere fra cloud gestito e deployment più controllato;
- lavorare con modelli compatti per scenari edge;
- integrare capacità specialistiche come OCR, voce o coding;
- mantenere aperta la possibilità di cambiare il livello dell’infrastruttura in futuro.
Il punto non è che Mistral vinca automaticamente in questi scenari.
È che offre più leve da valutare rispetto a un prodotto disponibile esclusivamente come servizio chiuso.
Quando un’alternativa ha più senso
Guarderei altrove quando quella flessibilità non produce un vantaggio concreto.
Se vuoi semplicemente il miglior assistente possibile per il tuo lavoro quotidiano, senza gestire modelli, API o deployment, il confronto dovrebbe concentrarsi sull’esperienza del prodotto: qualità sul tuo materiale, integrazioni, ricerca, coding, file, automazioni e prezzo.
Allo stesso modo, se il tuo team vive già dentro un ecosistema specifico, l’integrazione può contare più dell’apertura dei pesi.
E se vuoi eseguire modelli localmente, la disponibilità dei pesi è soltanto il primo filtro. Devi poi valutare hardware, runtime, quantizzazione, memoria, latenza e licenza.
In tutti questi casi il criterio che userei è:
workflow reale → requisiti → candidati → prova → costo complessivo → scelta
Conclusione
Mistral AI è più interessante quando smetti di considerarla semplicemente come “un altro chatbot”.
Vibe è il prodotto da cui partire se vuoi utilizzare direttamente l’assistente. Studio e le API sono il livello rilevante se devi costruire applicazioni. Le famiglie Large, Medium, Small e Ministral permettono invece di scegliere compromessi differenti fra capacità, costo e deployment.
La parte che merita più attenzione è proprio questa flessibilità.
Mistral combina servizi gestiti, modelli con diversi livelli di apertura e opzioni di deployment che possono diventare importanti quando un progetto cresce o quando controllo dei dati e infrastruttura fanno parte dei requisiti.
Non trasformerei però “europea”, “open” o “self-hosted” in scorciatoie per decidere.
Prima di adottarla controllerei sempre modello esatto, licenza, costo, impostazioni sui dati e modalità di deployment.
Se ti basta un assistente generalista, il confronto va fatto soprattutto sul workflow reale. Se invece vuoi poter decidere non soltanto quale AI usare, ma anche come e dove eseguirla, Mistral diventa una delle alternative più interessanti da mettere alla prova.