
Il ping è uno strumento di diagnostica di rete: invia una richiesta verso un altro host e verifica se riceve una risposta, misurando anche il tempo impiegato per il viaggio di andata e ritorno.
Questa definizione contiene già la distinzione più importante. Il ping non misura direttamente quanti megabit riesci a scaricare, non certifica che un sito web funzioni correttamente e non dimostra da solo che un server sia offline quando non risponde.
È però uno dei test più rapidi per capire a quale livello può trovarsi un problema di connessione.
In questa guida vedremo come funziona, come eseguire un ping test su Windows, macOS e Linux, come leggere millisecondi, TTL e packet loss e, soprattutto, come usare una sequenza di test per distinguere un problema del computer da uno del Wi-Fi, del router, di Internet o della risoluzione DNS.
Cos’è il ping e a cosa serve davvero
Il ping è un comando utilizzato per verificare la raggiungibilità di un dispositivo attraverso una rete IP e osservare il tempo necessario per ottenere una risposta.
Nella sua forma classica invia un messaggio ICMP Echo Request alla destinazione. Se il dispositivo riceve la richiesta e risponde a quel tipo di traffico, restituisce un ICMP Echo Reply. Il meccanismo fondamentale di ICMP per IPv4 è descritto nella specifica RFC 792 dell’Internet Control Message Protocol.
Il risultato permette di osservare principalmente tre cose:
| Informazione | Cosa puoi capire | Cosa non dimostra da sola |
|---|---|---|
| Risposta ricevuta | esiste connettività ICMP fra origine e destinazione | che ogni servizio sull’host funzioni |
| Tempo in ms | quanto ha impiegato quel round trip | la velocità di download o upload |
| Pacchetti senza risposta | possibile perdita, filtro o problema di raggiungibilità | che il server sia necessariamente spento |
Questa è anche la ragione per cui il ping è molto utile nel troubleshooting: è semplice, disponibile praticamente ovunque e consente di iniziare a restringere il campo prima di cambiare configurazioni a caso.
Ping non significa velocità Internet: cosa misura realmente
Nel linguaggio quotidiano si parla spesso di “ping della connessione” come se fosse un altro valore dello speed test accanto a download e upload.
Tecnicamente conviene essere più precisi.
La banda indica quanti dati possono essere trasferiti in un certo intervallo di tempo. Il ping osserva invece un tempo di risposta. Puoi quindi avere una connessione con centinaia di Mbps di download ma una risposta relativamente lenta verso un determinato server.
È possibile anche il contrario: poca banda disponibile ma round trip molto breve verso un host vicino.
Per questo un risultato come:
time=25 ms
non significa “25 millisecondi di velocità Internet”.
Significa che quella particolare richiesta e la relativa risposta hanno completato il percorso di andata e ritorno in circa 25 millisecondi.
ICMP Echo Request ed Echo Reply: cosa succede quando esegui un ping
Nel caso classico IPv4, il messaggio Echo Request utilizza ICMP type 8, mentre la relativa Echo Reply utilizza type 0. Identificatore e numero di sequenza permettono al mittente di associare le risposte alle richieste inviate.
Con IPv6 il principio resta analogo, ma viene utilizzato ICMPv6: la RFC 4443 dedicata a ICMPv6 definisce Echo Request ed Echo Reply rispettivamente come type 128 e 129.
Per un normale test non hai bisogno di conoscere questi numeri.
La parte utile da ricordare è il modello:
computer → Echo Request → destinazione
computer ← Echo Reply   ← destinazione
Il comando misura il tempo trascorso fra invio e ricezione della risposta.
Perché “Packet Internet Groper” non è il significato originale di ping
Molte guide presentano Packet Internet Groper o varianti simili come se PING fosse nato come acronimo.
La storia originale è diversa: il nome venne scelto per analogia con il ping del sonar, cioè l’invio di un segnale seguito dall’attesa dell’eco. Le espansioni del termine come acronimo sono arrivate successivamente.
È un dettaglio storico, ma evita di costruire la definizione tecnica su un’etimologia sbagliata.
Come funziona il comando ping
Il funzionamento di base è semplice:
destinazione scelta
        ↓
Echo Request
        ↓
rete / router / Internet
        ↓
destinazione
        ↓
Echo Reply
        ↓
tempo di andata e ritorno
Da qui però nasce un errore frequente: attribuire al risultato più informazioni di quelle che contiene.
Un ping riuscito significa che, in quel momento e per quel tipo di traffico, una richiesta ICMP è riuscita a raggiungere la destinazione e una risposta è tornata indietro.
Non significa automaticamente che una pagina web si carichi bene, che una porta TCP sia aperta o che un’applicazione installata sul server sia funzionante.
Raggiungibilità e tempo di andata e ritorno
La documentazione Microsoft del comando ping lo descrive come uno degli strumenti principali per diagnosticare connettività IP, raggiungibilità e problemi di risoluzione dei nomi. Il comando mostra anche i round-trip time, cioè i tempi di andata e ritorno delle richieste che hanno ricevuto risposta.
Se ottieni:
time=18 ms
time=19 ms
time=21 ms
time=18 ms
hai quattro campioni.
La media è utile, ma non guarderei solo quella. Anche la stabilità della sequenza racconta qualcosa.
Una serie:
18
19
20
19
descrive un comportamento diverso da:
18
19
180
21
anche se un singolo valore medio tende a nascondere parte della differenza.
Ping, RTT e latenza: termini collegati ma non equivalenti
Nel linguaggio comune ping viene spesso usato come sinonimo di latenza.
Per una diagnosi tecnica conviene separarli.
Ping è lo strumento o il test.
Il Round Trip Time (RTT) è il tempo di andata e ritorno osservato dal test.
Latenza è un concetto più generale che descrive un ritardo e può essere riferito anche a una sola direzione o ad altri livelli della comunicazione.
Quindi il valore time=... ms di un normale comando ping è soprattutto una misura di round trip.
Questo conta perché andata e ritorno non devono necessariamente seguire lo stesso percorso, e perché un RTT non permette di ricavare con precisione la latenza in una singola direzione semplicemente dividendolo per due.
Cosa il ping non può dimostrare da solo
Il comando non replica una richiesta HTTPS completa.
Non esegue il rendering della pagina, non misura il tempo del database, non verifica PHP o WordPress, non stabilisce una sessione applicativa e non testa automaticamente la porta sulla quale gira un servizio.
Anche il trattamento di ICMP può differire dal traffico reale dell’applicazione.
Di conseguenza:
ping buono ≠ sito sicuramente veloce
e:
ping fallito ≠ sito sicuramente offline
Questa seconda distinzione diventerà particolarmente importante quando analizzeremo i timeout.
Come fare un ping test su Windows, macOS e Linux
Per un controllo normale non serve installare software aggiuntivo.
La sintassi di base è:
ping destinazione
La destinazione può essere un hostname o un indirizzo IP.
Comando ping su Windows
Su Windows puoi aprire Prompt dei comandi, PowerShell o Windows Terminal e digitare:
ping example.com
Per impostazione predefinita Windows invia quattro richieste. Puoi scegliere un numero diverso con -n:
ping -n 10 example.com
Per continuare a inviare richieste fino all’interruzione manuale:
ping -t example.com
Interrompi con Ctrl+C.
Le opzioni e il comportamento corrente sono riportati nella guida ufficiale Microsoft al comando ping.
Per una verifica occasionale quattro campioni possono bastare a capire se l’host risponde.
Se stai invece indagando picchi intermittenti, preferirei una sequenza più lunga, per esempio:
ping -n 20 example.com
Non perché venti sia un numero magico, ma perché un singolo valore anomalo su quattro campioni pesa troppo per descrivere la stabilità della connessione.
Comando ping su macOS
Apri Terminale e usa:
ping example.com
Su macOS il comando continua normalmente fino all’interruzione. Se vuoi limitare il test a quattro richieste:
ping -c 4 example.com
Puoi utilizzare lo stesso approccio con un numero maggiore di campioni:
ping -c 20 example.com
Comando ping su Linux
Sulle distribuzioni che utilizzano iputils, la sintassi essenziale è analoga:
ping example.com
e per fermarsi dopo un numero definito di richieste:
ping -c 4 example.com
Il manuale Linux di ping documenta -c count come opzione per terminare dopo il numero specificato di Echo Request.
Le implementazioni possono differire in alcuni dettagli e opzioni avanzate. Per una guida generale di troubleshooting, dominio/IP, conteggio dei pacchetti e lettura dei risultati sono molto più importanti di un catalogo completo degli switch.
Pingare un dominio, un indirizzo IP o il router: cosa cambia
Il comando è lo stesso, ma la domanda diagnostica cambia completamente.
Se esegui:
ping example.com
il sistema deve prima trasformare il nome in un indirizzo IP. Stai quindi coinvolgendo anche la risoluzione del nome.
Se esegui:
ping 1.1.1.1
salti quel passaggio e provi direttamente a raggiungere l’indirizzo IP.
Se invece esegui il ping del gateway del tuo router, per esempio:
ping 192.168.1.1
stai osservando soprattutto il tratto fra il dispositivo e la rete locale.
L’indirizzo del tuo gateway non è necessariamente 192.168.1.1: usa quello realmente configurato sulla tua rete.
È proprio questa possibilità di cambiare destinazione mantenendo lo stesso strumento che rende ping particolarmente utile per isolare i problemi.
Come leggere il risultato del ping
Un output normale contiene diverse informazioni. Non tutte hanno lo stesso peso diagnostico.
Un esempio semplificato può apparire così:
Reply from ...: bytes=32 time=24ms TTL=54
Reply from ...: bytes=32 time=23ms TTL=54
Reply from ...: bytes=32 time=25ms TTL=54
Reply from ...: bytes=32 time=41ms TTL=54
Al termine trovi normalmente anche un riepilogo dei pacchetti inviati e ricevuti e dei tempi osservati.
Time e millisecondi: minimo, media, massimo e picchi
time indica il tempo di round trip di quella singola richiesta.
Un numero più basso rappresenta una risposta più rapida verso quella destinazione, in quelle condizioni.
Per diagnosticare la qualità della connessione guarderei almeno:
- valore tipico;
- minimo e massimo;
- eventuali picchi;
- regolarità della sequenza;
- pacchetti senza risposta.
Una media di 30 ms ottenuta da valori molto stabili non racconta la stessa rete di una media di 30 ms ottenuta alternando 5 e 100 ms.
TTL: cosa indica e perché non va usato come “punteggio”
TTL significa Time To Live.
Nel normale traffico IP viene ridotto lungo il percorso e serve a impedire che un pacchetto possa continuare a circolare indefinitamente. Quando arriva a zero, il pacchetto viene scartato.
Il valore mostrato dal ping è quindi legato al pacchetto ricevuto, alla sua impostazione iniziale e agli hop attraversati.
Non leggerlo come se:
TTL più alto = connessione migliore
Non funziona così.
Sistemi operativi e dispositivi possono partire da valori iniziali differenti, perciò non puoi ricavare con certezza il numero di router attraversati semplicemente guardando il TTL finale senza conoscere l’origine.
In un troubleshooting normale il TTL è soprattutto un’informazione di contesto. Una variazione improvvisa insieme ad altri cambiamenti può essere un indizio, ma non è un voto alla qualità della connessione.
Pacchetti inviati, ricevuti e packet loss
Se invii 20 richieste e ne ricevi 20, il test non ha osservato perdita di Echo Reply.
Se ne ricevi 18, due richieste non hanno prodotto una risposta entro le condizioni del test.
Questo viene normalmente sintetizzato come packet loss.
La perdita merita attenzione soprattutto quando è ripetibile.
Un unico pacchetto perso non autorizza da solo a concludere che la linea sia guasta. Se invece la perdita si ripresenta nella stessa tratta, su più test e in condizioni controllate, hai un segnale molto più utile.
Ricorda inoltre che stai osservando pacchetti ICMP. La percentuale non è automaticamente identica alla perdita del traffico applicativo.
Request timed out e Destination host unreachable: cosa significano
Un timeout significa innanzitutto una cosa molto precisa: la risposta attesa non è arrivata entro il tempo previsto.
Su Windows il timeout predefinito del comando è quattro secondi per ciascuna risposta, salvo modifica dell’opzione relativa.
Le cause possibili sono diverse:
host non disponibile
percorso interrotto
pacchetto perso
Echo Reply perso
firewall
ICMP filtrato o limitato
Destination host unreachable è differente: un dispositivo lungo il percorso, oppure il sistema locale, sta comunicando che non riesce a raggiungere la destinazione secondo le informazioni disponibili.
La distinzione pratica è importante.
Nel primo caso manca la risposta attesa.
Nel secondo esiste un messaggio di errore che segnala un problema di raggiungibilità.
Qual è un buon ping? Come interpretare i millisecondi nel contesto giusto
Non esiste un valore di ping universalmente “buono” indipendentemente dalla destinazione.
Più basso e stabile è il round trip verso lo stesso endpoint, meglio è per le applicazioni sensibili ai tempi di risposta. Ma la distanza geografica, il percorso di rete e il tipo di collegamento cambiano il valore che puoi realisticamente aspettarti.
Se stai usando uno speed test con un server geograficamente vicino, queste fasce possono servire solo come orientamento iniziale:
| Ping indicativo | Lettura pratica |
|---|---|
| 0–20 ms | risposta molto rapida verso un endpoint vicino |
| 20–50 ms | generalmente bassa latenza per molti usi interattivi |
| 50–100 ms | utilizzabile per molti task, ma il ritardo può iniziare a essere percepibile nelle applicazioni più sensibili |
| oltre 100 ms | ritardo spesso evidente in gaming, desktop remoto o conversazioni in tempo reale |
Non userei questa tabella per diagnosticare automaticamente un problema.
Un ping di 20 ms verso il router di casa potrebbe essere sospetto in una rete locale che normalmente risponde molto più rapidamente.
Un ping di 100 ms verso un server dall’altra parte del mondo può invece essere perfettamente compatibile con la distanza e il percorso.
Perché non esiste una soglia universale valida per ogni server
La luce e i segnali nelle fibre non viaggiano istantaneamente.
Inoltre i pacchetti non seguono necessariamente il percorso geograficamente più corto: attraversano reti, router, punti di peering e politiche di instradamento.
A questo si aggiungono code e congestione.
Perciò confrontare:
20 ms verso server A
con:
80 ms verso server B
senza sapere dove si trovano e quale percorso viene usato può portare a conclusioni sbagliate.
Il confronto più utile è spesso:
stessa origine
+ stessa destinazione
+ condizioni simili
+ momenti differenti
Ping verso il router e ping verso Internet non sono confrontabili
Il router può trovarsi a pochi metri dal computer.
Un server su Internet può trovarsi a centinaia o migliaia di chilometri e richiedere molti hop intermedi.
Il primo test serve soprattutto a capire come si comporta la rete locale.
Il secondo comprende anche provider, reti di transito e infrastruttura della destinazione.
Questa distinzione permette di fare una cosa molto più utile del chiedersi semplicemente “il mio ping è alto?”:
capire in quale tratto inizia a diventare alto.
Gaming, videochiamate e navigazione hanno sensibilità diverse
Non tutte le applicazioni reagiscono nello stesso modo.
Nel gaming competitivo ogni ritardo aggiuntivo può modificare la sensazione di risposta fra azione e risultato.
Nelle conversazioni audio e video la latenza elevata può creare sovrapposizioni e pause innaturali.
Una pagina web o un flusso video già bufferizzato tollerano invece più facilmente una latenza che sarebbe fastidiosa in una sessione interattiva.
Quindi “accettabile” dipende anche da ciò che stai facendo.
Quando stabilità, jitter e perdita di pacchetti contano più della media
Considera queste due sequenze:
25 - 26 - 25 - 27 - 26
e:
8 - 12 - 160 - 9 - 140
La seconda può avere momenti molto veloci, ma è molto meno prevedibile.
La variazione del ritardo viene comunemente descritta attraverso il concetto di jitter. Un normale ping permette già di vedere se i campioni oscillano, mentre strumenti dedicati possono calcolare metriche specifiche di variazione.
Nelle applicazioni real time una connessione leggermente più lenta ma stabile può comportarsi meglio di una connessione che alterna continuamente valori bassissimi e picchi enormi.
Lo stesso vale per il packet loss: una media apparentemente buona perde significato se una parte delle richieste non torna affatto.
Come usare il ping per capire dove si trova un problema di rete
Questa è la parte più utile del comando.
Invece di eseguire un singolo ping verso un sito casuale, puoi cambiare progressivamente destinazione per capire fino a quale livello la comunicazione funziona.
La stessa logica di fault isolation compare anche nel manuale Linux di ping: partire dall’host locale e procedere verso host e gateway progressivamente più lontani.
La sequenza pratica è:
loopback
↓
gateway/router
↓
indirizzo IP su Internet
↓
hostname
Ogni passaggio aggiunge un nuovo pezzo dell’infrastruttura.
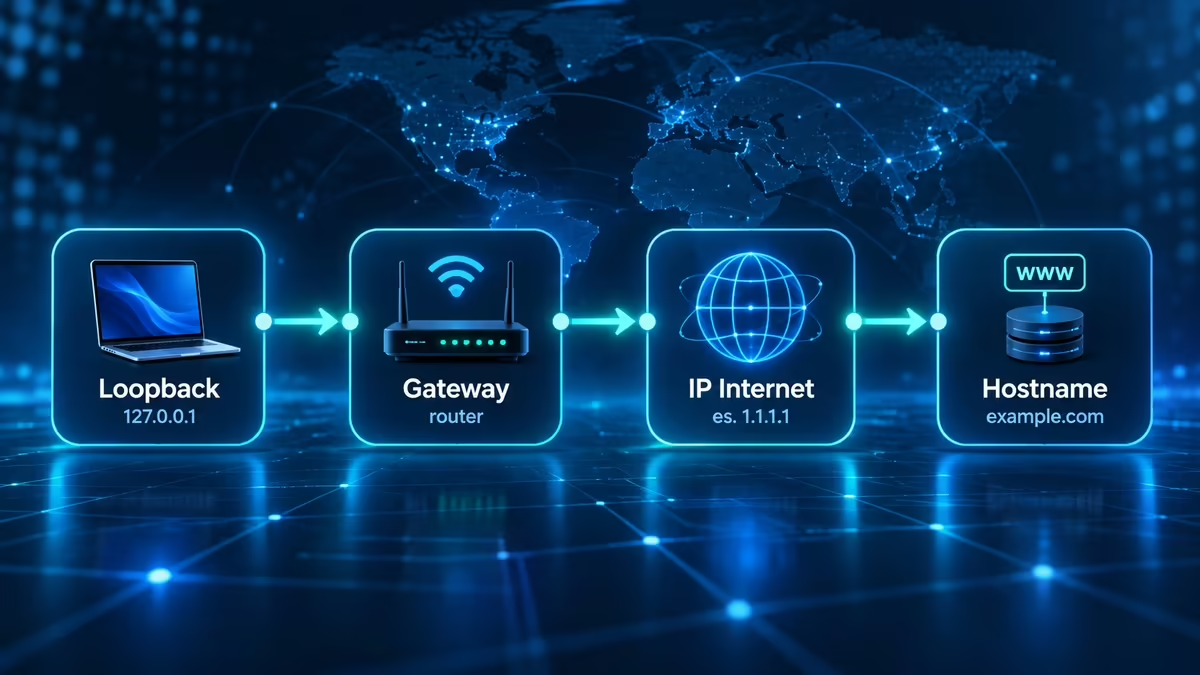
Test 1: controllare il computer e lo stack di rete
Parti dall’indirizzo IPv4 di loopback:
ping 127.0.0.1
Questo traffico resta sul sistema locale.
Se risponde, hai verificato che il percorso di loopback e lo stack IP locale stanno funzionando abbastanza da gestire il test.
Attenzione a una semplificazione comune: non hai ancora dimostrato che la scheda Wi-Fi, il cavo Ethernet o il router funzionino.
Il pacchetto non deve raggiungere fisicamente la rete esterna.
Test 2: pingare router o gateway
Il passaggio successivo è il gateway predefinito della rete.
Esempio:
ping 192.168.1.1
ma devi sostituire l’indirizzo con quello reale del tuo router.
Se il loopback funziona ma non riesci a raggiungere il gateway, la diagnosi rimane molto vicina:
configurazione IP
interfaccia di rete
Wi-Fi
Ethernet
router
rete locale
Se il gateway risponde ma mostra forti oscillazioni o perdita, confronta Wi-Fi ed Ethernet prima di accusare il provider.
La guida Microsoft al troubleshooting TCP/IP utilizza proprio il controllo del gateway come uno dei passaggi per isolare i problemi di connettività.
Test 3: pingare un indirizzo IP su Internet
Ora scegli un indirizzo IP pubblico noto, per esempio:
ping 1.1.1.1
Se il gateway locale risponde regolarmente ma un indirizzo esterno no, il problema si sposta oltre la sola rete locale.
Fra le ipotesi entrano:
connessione del router verso Internet
provider
routing
filtri
destinazione scelta
Non dimenticare però il limite di ICMP: un singolo host che non risponde non dimostra che Internet non funzioni.
Per questo è utile provare più di una destinazione nota prima di generalizzare.
Test 4: pingare un nome di dominio
Infine prova:
ping example.com
Qui entra anche la risoluzione del nome.
Se il ping verso un indirizzo IP esterno funziona ma un hostname non viene risolto correttamente, DNS, file hosts e configurazione della risoluzione diventano candidati molto più interessanti.
La documentazione Microsoft del comando ping suggerisce proprio il confronto fra indirizzo IP e nome host per individuare un possibile problema di name resolution.
IP funziona ma dominio no: quando verificare DNS e risoluzione dei nomi
Questo pattern merita di essere riconosciuto:
gateway → OK
IP Internet → OK
hostname → FALLISCE
Non dimostra automaticamente che il resolver DNS sia guasto, ma sposta chiaramente l’indagine.
A questo punto conviene capire cos’è il DNS e come avviene la risoluzione di un nome di dominio, quindi controllare:
DNS configurati sul dispositivo
resolver del router
file hosts
cache DNS
risoluzione del dominio specifico
Se invece falliscono sia l’IP sia il nome, cambiare DNS come prima mossa ha molto meno senso: probabilmente non hai ancora dimostrato di avere una normale connettività IP verso Internet.
La sequenza dei test serve proprio a evitare questo tipo di tentativi casuali.
Ping alto: cause e controlli da fare prima di cambiare qualcosa
Un ping alto non identifica una causa.
Dice soltanto che il round trip verso la destinazione scelta sta richiedendo più tempo di quanto ti aspetti.
Prima di cambiare router, DNS, provider o configurazioni conviene trovare il punto in cui il ritardo compare.
Wi-Fi debole, interferenze e rete locale
Se il ping verso il gateway è già instabile, non partirei dalla rete del provider.
Confronta lo stesso test:
via Wi-Fi
e, quando possibile:
via Ethernet
Se il problema scompare con il cavo, hai un’indicazione forte sul tratto wireless.
Tra le possibili cause ci sono distanza dal router, ostacoli, interferenze, congestione radio o una configurazione poco adatta all’ambiente.
Il punto non è che Ethernet debba sempre essere la soluzione definitiva. Serve come test discriminante.
Congestione e traffico sulla connessione
Una rete può mostrare buoni tempi quando è inattiva e peggiorare drasticamente durante upload, backup cloud o trasferimenti importanti.
Esegui quindi lo stesso test:
rete quasi inattiva
e poi:
durante il carico che genera il problema
Se il round trip aumenta soltanto sotto carico, stai osservando un fenomeno diverso da una latenza costantemente elevata verso quella destinazione.
In questo scenario possono essere rilevanti capacità della linea, code nel router e gestione del traffico.
Non cambierei però impostazioni QoS a caso: prima dimostra che il degrado è effettivamente correlato alla saturazione.
Distanza dal server, routing e provider
Se il gateway locale è rapido ma un determinato server remoto risponde lentamente, il Wi-Fi potrebbe non essere il problema.
Il ritardo può comparire:
dopo il router
nel percorso dell'operatore
nel peering
in reti di transito
vicino alla destinazione
Prova altre destinazioni comparabili.
Se tutto è lento oltre la rete locale, l’ipotesi provider o connettività WAN diventa più interessante.
Se un solo servizio è lento mentre altri endpoint simili sono rapidi, concentrati invece sulla destinazione o sul percorso specifico.
VPN, hotspot e percorsi di rete aggiuntivi
Una VPN cambia il percorso del traffico e introduce almeno un endpoint ulteriore nella comunicazione.
Questo può aumentare il round trip, soprattutto se il server VPN è distante.
Non è però corretto trasformarlo in una legge del tipo:
VPN = ping sempre più alto
Un percorso VPN diverso potrebbe in casi particolari evitare un routing inefficiente e produrre un risultato differente.
Il test utile è molto più semplice:
stessa destinazione senza VPN
stessa destinazione con VPN
mantenendo il resto il più possibile invariato.
Come ridurre il ping con un troubleshooting progressivo
Il modo migliore per abbassare un ping alto è rimuovere la causa che hai identificato, non applicare una lista casuale di ottimizzazioni.
La sequenza pratica è:
- scegli una destinazione coerente;
- raccogli più campioni;
- verifica il gateway;
- confronta Wi-Fi ed Ethernet;
- ripeti a rete libera e sotto carico;
- prova una destinazione Internet diversa;
- confronta con e senza VPN, se presente;
- modifica una sola variabile;
- ripeti esattamente lo stesso test.
In questo modo un miglioramento diventa attribuibile con molta più credibilità.
Se cambi contemporaneamente DNS, router, canale Wi-Fi, VPN e provider, anche un risultato migliore ti dirà pochissimo sulla causa originale.
Ping online e speed test: perché possono dare risultati diversi dal terminale
Un test online e il comando del terminale possono entrambi mostrare un valore chiamato “ping”, ma non è garantito che stiano misurando esattamente la stessa cosa nello stesso modo.
Prima di confrontare due numeri devi sapere almeno:
origine del test
destinazione
protocollo/metodologia
numero di campioni
rete utilizzata
Da dove viene realmente eseguito un ping test online
Uno speed test normalmente sceglie un server con cui effettuare le proprie misurazioni.
Il valore di latenza che mostra descrive quindi la relazione fra il tuo dispositivo e l’infrastruttura scelta da quel servizio secondo la sua metodologia.
Un altro tool può utilizzare un server differente.
Il tuo comando:
ping example.com
sta invece interrogando esattamente example.com.
Confrontare i due numeri come se fossero la stessa misurazione non è corretto.
Perché un browser non equivale a un ping ICMP locale
Quando apri un sito che misura la latenza non stai necessariamente eseguendo dal browser lo stesso programma ping disponibile nel sistema operativo.
Il servizio può misurare tempi attraverso richieste applicative, collegamenti al proprio server o probe eseguiti con una metodologia propria.
Il comando locale, invece, utilizza l’implementazione ping del sistema operativo.
Quindi una differenza fra:
speed test: 12 ms
ping server-esterno.example: 38 ms
non è di per sé un errore.
Prima chiediti se i due test avevano la stessa destinazione e la stessa metodologia.
Ping, jitter, download e upload misurano aspetti diversi
Uno speed test moderno può mostrare diversi valori:
| Metrica | Domanda a cui risponde |
|---|---|
| Ping/latenza | quanto rapidamente ottengo una risposta secondo quel test? |
| Jitter | quanto varia il ritardo fra i campioni? |
| Download | quanta capacità ho nel ricevere dati? |
| Upload | quanta capacità ho nell’inviare dati? |
| Packet loss, se misurato | quante unità di test non arrivano correttamente? |
Non scegliere quindi una connessione guardando un solo numero.
E non diagnosticare un problema di banda usando soltanto il ping.
Quando il ping non risponde ma il sito o il server funzionano
Questa è una delle situazioni che crea più confusione.
Esegui:
ping example.com
e ricevi timeout.
Poi apri il sito nel browser e funziona.
Non esiste alcuna contraddizione necessaria.
ICMP bloccato o deprioritizzato
Firewall, sistemi di sicurezza e apparati di rete possono filtrare o trattare diversamente il traffico ICMP.
La documentazione Microsoft sul troubleshooting TCP/IP chiarisce che un timeout ICMP, da solo, non dimostra necessariamente un problema di connettività, perché il traffico può essere bloccato dalla rete o dal firewall.
Un amministratore può quindi decidere di non rispondere normalmente agli Echo Request pur lasciando disponibile il servizio web sulla porta HTTPS.
Perché un timeout non dimostra automaticamente che l’host sia offline
Considera queste due domande:
l'host risponde agli ICMP Echo Request?
e:
il servizio HTTPS dell'host è disponibile?
Non sono la stessa domanda.
Ping risponde alla prima.
Se vuoi sapere se un servizio specifico è disponibile, devi utilizzare anche un controllo adeguato al protocollo o alla porta interessata.
Questa distinzione evita un errore frequente nei sistemi di monitoraggio: dichiarare indisponibile un’intera applicazione soltanto perché non risponde al probe ICMP.
Quando passare da ping a tracert o traceroute
Ping indica se ricevi risposte e quanto impiegano.
Non mostra però in modo completo il percorso seguito.
Quando devi capire dove cambia la situazione lungo la rete puoi passare a:
tracert example.com
su Windows oppure:
traceroute example.com
sui sistemi che forniscono quel comando.
Anche traceroute ha dei limiti: un router intermedio che non risponde al probe non significa necessariamente che stia perdendo il traffico reale.
Usalo quindi per costruire una diagnosi insieme agli altri segnali, non per assegnare automaticamente la colpa al primo hop con un asterisco.
Conclusione
Il ping diventa davvero utile quando smetti di leggerlo come un semplice numero dello speed test.
Il modello corretto è più semplice:
ping = test diagnostico
time = round-trip time osservato
packet loss = richieste senza risposta nel test
TTL = informazione sul ciclo di vita/percorso del pacchetto
timeout = risposta non ricevuta entro il limite
Se devi capire perché una connessione non funziona, non partire dal valore “ottimale” trovato in una tabella.
Parti dalla sequenza:
127.0.0.1
→ gateway
→ indirizzo IP Internet
→ hostname
Se il problema compare già verso il gateway, guarda prima la rete locale. Se il gateway funziona e Internet no, sposta la diagnosi oltre il router. Se un indirizzo IP funziona ma il nome no, la risoluzione DNS diventa un candidato concreto.
È questa capacità di isolare progressivamente il problema, più che il singolo valore in millisecondi, a rendere il comando ping ancora utile.