
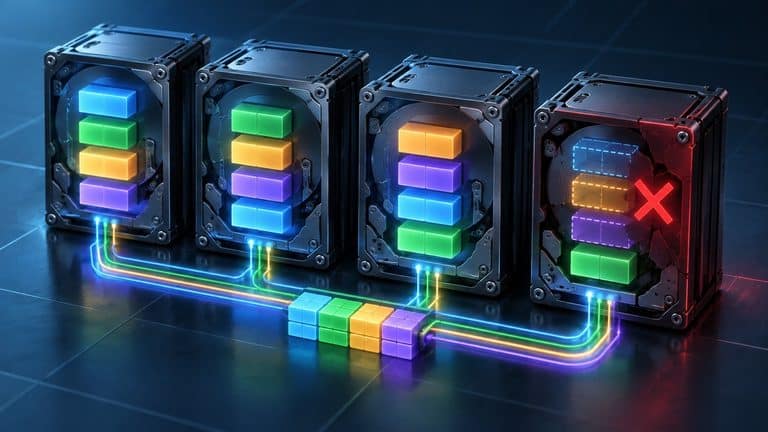
Il RAID è una tecnica che permette di combinare più unità di archiviazione per ottenere caratteristiche che un singolo disco non può offrire da solo: più prestazioni, maggiore capacità, tolleranza al guasto di una o più unità oppure un compromesso fra questi obiettivi.
La sigla indica tradizionalmente Redundant Array of Independent Disks. Il punto importante, però, non è imparare l’acronimo: è capire che non esiste un livello migliore in assoluto. RAID 0, RAID 1, RAID 5, RAID 6 e RAID 10 organizzano i dati in modi diversi e quindi cambiano capacità disponibile, tolleranza ai guasti, prestazioni e comportamento quando un disco si rompe.
La Storage Networking Industry Association inquadra il RAID come una tecnologia che distribuisce dati e informazioni di ridondanza tra più dispositivi di storage. RAID 0 rappresenta un caso particolare: viene comunemente incluso nella famiglia, ma usa lo striping senza offrire ridondanza.
Prima di scegliere una configurazione conviene quindi rispondere a domande concrete: quanti dischi hai, quanti ne puoi perdere senza fermarti, quanta capacità sei disposto a sacrificare, che tipo di I/O deve sostenere il sistema e come verranno protetti i dati al di fuori dell’array.
Cos’è il RAID in informatica e a cosa serve
Un sistema RAID presenta più unità fisiche come una struttura logica coordinata. A seconda del livello scelto, i blocchi di dati possono essere distribuiti tra i dischi, duplicati oppure accompagnati da informazioni di parità che consentono di ricostruire ciò che si trovava su un’unità guasta.
L’obiettivo cambia da configurazione a configurazione.
Il livello 0 punta soprattutto a capacità aggregata e parallelismo. Il livello 1 privilegia la ridondanza attraverso copie identiche. I livelli 5 e 6 cercano un compromesso tra spazio utilizzabile e tolleranza ai guasti tramite la parità. Il 10 combina invece striping e mirroring.
Questa distinzione conta soprattutto nei NAS e nei server, dove storage e disponibilità non possono essere valutati soltanto guardando quanti terabyte sono installati.
Cosa significa RAID
Il significato comunemente utilizzato è Redundant Array of Independent Disks, cioè insieme ridondante di dischi indipendenti.
La terminologia nasce storicamente dal lavoro sui Redundant Arrays of Inexpensive Disks, ma il concetto si è evoluto insieme allo storage. Oggi queste tecniche non sono limitate ai vecchi hard disk magnetici: possono essere applicate anche a SSD e ad altri dispositivi a blocchi.
Non bisogna quindi associare automaticamente il termine a “vecchi dischi meccanici”.
Cosa cambia rispetto a usare un solo disco
Con un solo disco, capacità, prestazioni e disponibilità dipendono interamente da quell’unità.
Con più dispositivi coordinati puoi invece distribuire il lavoro oppure introdurre ridondanza. Il prezzo da pagare è una maggiore complessità: parte della capacità può non essere disponibile per i dati, la configurazione deve essere monitorata e la sostituzione di un’unità guasta può richiedere una ricostruzione dell’array.
Il RAID non elimina quindi il problema dello storage. Lo trasforma in un problema di progettazione.
Come funziona un sistema RAID: striping, mirroring e parità
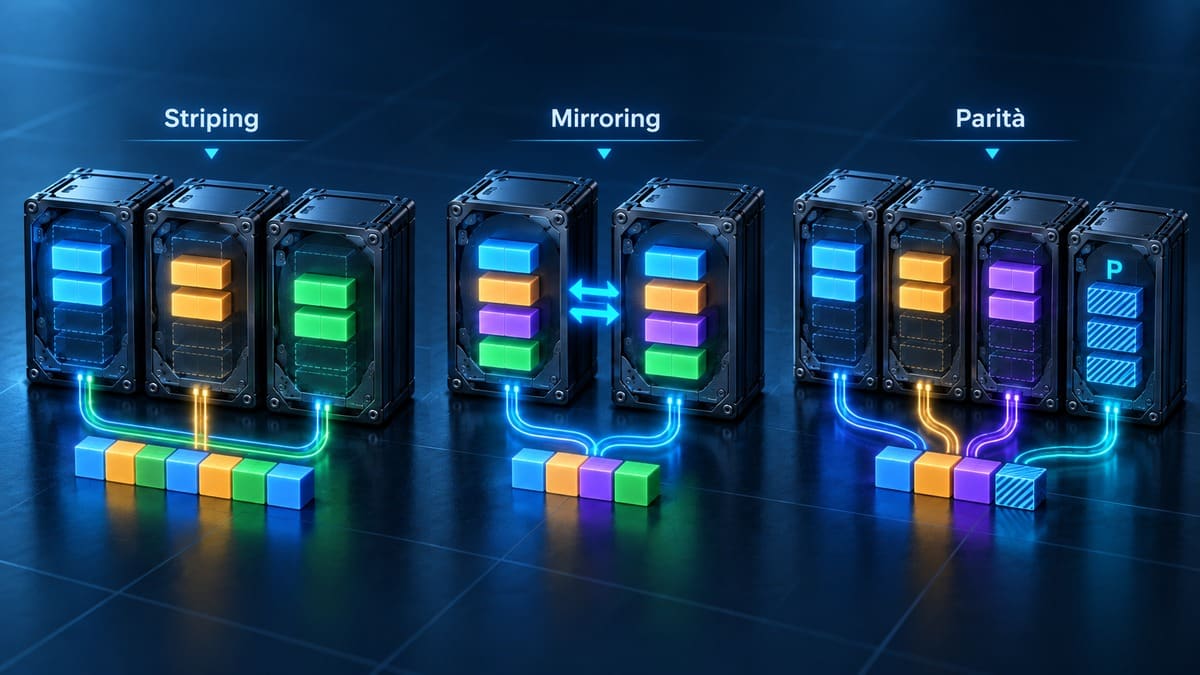
Per capire i diversi livelli conviene partire da tre meccanismi fondamentali: striping, mirroring e parità.
È molto più utile comprendere questi concetti che memorizzare una sequenza di numeri.
Striping: distribuire i dati tra più dischi
Lo striping divide i dati in blocchi e li distribuisce tra più unità.
RAID 0 è l’esempio più semplice: una parte dei dati finisce su un disco, un’altra su quello successivo e così via. Più dispositivi possono quindi contribuire alle operazioni di I/O e la capacità complessiva viene aggregata.
Il problema è altrettanto netto: non esiste una copia ridondante.
Se una delle unità che contiene una parte dell’array smette di funzionare, manca una porzione dei blocchi necessari a ricostruire l’insieme. Per questo il livello 0 aumenta le prestazioni potenziali ma non offre tolleranza al guasto. Intel descrive RAID 0 come una configurazione orientata alle prestazioni, con striping dei dati e nessuna ridondanza.
Mirroring: creare copie dei dati
Il mirroring segue una logica diversa: gli stessi dati vengono mantenuti su più unità.
Il caso classico è RAID 1 con due dischi. Quando il sistema scrive un blocco, il contenuto viene memorizzato su entrambe le unità. Se una delle due si guasta, l’altra conserva ancora i dati.
Il vantaggio è intuitivo. Lo svantaggio è la capacità: con due dischi uguali, soltanto la capacità equivalente a un disco resta utilizzabile per i dati.
Due unità da 4 TB in mirroring non diventano quindi un volume ridondante da 8 TB. La capacità nominale utilizzabile è circa 4 TB prima di considerare differenze tra TB e TiB, filesystem, metadata e altri overhead.
La documentazione QNAP sui tipi RAID riassume lo stesso compromesso: RAID 1 mantiene una copia identica dei dati e, con due unità equivalenti, rende disponibile circa metà della capacità complessiva.
Parità: ricostruire i dati dopo un guasto
La parità permette di ottenere ridondanza senza mantenere necessariamente una copia completa di ogni blocco.
In RAID 5 i dati e le informazioni di parità vengono distribuiti tra le unità. Se un disco viene perso, il sistema può utilizzare ciò che rimane nell’array insieme alla parità per ricostruire il contenuto mancante.
Il vantaggio è l’efficienza di capacità: con dischi della stessa dimensione, il livello 5 sacrifica l’equivalente di una unità, mentre il livello 6 utilizza l’equivalente di due unità per offrire doppia parità.
Il prezzo non è soltanto lo spazio occupato. Le scritture richiedono anche la gestione della parità e, quando l’array è degradato, letture e ricostruzione possono aumentare significativamente il lavoro dello storage. La documentazione Synology sui livelli RAID segnala infatti che durante lo stato degradato le prestazioni possono essere fortemente influenzate.
RAID hardware e RAID software: dove viene gestito l’array
La logica può essere gestita a livelli diversi.
In un RAID hardware un controller dedicato si occupa dell’array e presenta al sistema operativo il volume risultante. Soluzioni enterprise possono integrare cache protetta, gestione degli hot spare, diagnostica e funzioni specifiche del controller.
Nel RAID software è invece il sistema operativo a coordinare le unità. Linux, per esempio, può gestire array software e anche un’installazione di Ubuntu Server può convivere con RAID, LVM e layout di storage personalizzati.
La distinzione oggi è meno binaria di quanto sembri. Esistono implementazioni integrate nella piattaforma, firmware RAID e tecnologie che sfruttano direttamente CPU e storage NVMe. Intel, per esempio, distingue controller hardware e soluzioni RAID per piattaforme server.
Per questo non sceglierei “hardware” o “software” per principio. Conta di più sapere dove risiede la configurazione, come viene recuperata dopo un guasto del controller, quali unità sono supportate e quali strumenti hai per monitorare l’array.
Livelli RAID: differenze tra RAID 0, 1, 5, 6 e 10
Nei contesti moderni conviene concentrarsi sui cinque livelli principali descritti qui sotto. Ogni configurazione risolve un problema diverso.
RAID 0: prestazioni senza ridondanza
Usa lo striping e richiede almeno due unità.
La capacità viene aggregata e il lavoro può essere distribuito tra i dischi. Con unità equivalenti, due dischi da 4 TB offrono circa 8 TB nominali di capacità.
Non esiste però tolleranza al guasto.
La perdita di una sola unità compromette l’intero array, perché una parte dei blocchi necessari è distribuita sul disco mancante.
Ha quindi senso quando i dati sono temporanei, ricostruibili oppure già protetti altrove e il requisito prioritario è la prestazione o l’aggregazione di capacità.
Non lo userei come unica destinazione per dati insostituibili.
RAID 1: mirroring semplice
Mantiene copie identiche dei dati.
Con due dischi, uno può guastarsi senza rendere immediatamente indisponibili i dati conservati sull’altro. La configurazione è semplice da comprendere e per questo è molto comune nei NAS con due vani.
La contropartita è il costo per gigabyte: due dischi da 4 TB producono circa 4 TB nominali utilizzabili.
È una scelta razionale quando semplicità e tolleranza al guasto di un disco pesano più della massimizzazione della capacità.
Non significa però che il sistema sia “sicuro” in senso assoluto. Un file cancellato, corrotto o cifrato da ransomware può essere modificato anche sul mirror.
RAID 5: capacità e parità distribuita
Richiede almeno tre dischi e utilizza striping con parità distribuita.
Con N dischi uguali, la capacità nominale può essere schematizzata come:
(N - 1) × capacità del disco più piccolo
Quattro dischi da 4 TB offrono quindi circa 12 TB nominali utilizzabili.
Il sistema può tollerare il guasto di un disco. Durante quel periodo l’array opera in stato degradato finché l’unità non viene sostituita e i dati ricostruiti.
È una configurazione interessante quando si cerca un compromesso tra capacità, ridondanza e costo, ma non va scelta meccanicamente soltanto perché “spreca meno spazio” di RAID 10. Il carico di scrittura, la dimensione dell’array e le conseguenze di un rebuild devono entrare nella decisione.
RAID 6: doppia parità
Applica una logica simile al livello precedente, ma mantiene informazioni di parità sufficienti a tollerare il guasto contemporaneo di due unità.
Servono almeno quattro dischi.
Con unità uguali, la capacità nominale è:
(N - 2) × capacità del disco più piccolo
Quattro dischi da 4 TB producono quindi circa 8 TB nominali utilizzabili.
Rispetto al livello 5 si sacrifica più capacità e si aggiunge lavoro legato alla doppia parità, ma aumenta la tolleranza ai guasti. QNAP e Synology documentano entrambe la possibilità di sopravvivere alla perdita di due unità in una configurazione correttamente realizzata.
Ha più senso quando la continuità durante un secondo guasto vale più dello spazio perso.
RAID 10: mirroring e striping insieme
RAID 10, o RAID 1+0, combina coppie in mirroring e distribuisce i dati fra i mirror attraverso lo striping.
Richiede almeno quattro unità e normalmente un numero pari di dischi.
Con unità della stessa dimensione, la capacità disponibile è circa metà della capacità complessiva:
(N / 2) × capacità del disco più piccolo
Quattro dischi da 4 TB producono quindi circa 8 TB nominali utilizzabili.
Il vantaggio è particolarmente interessante nei workload con I/O intenso: non esiste il lavoro di parità tipico dei livelli 5 e 6 e la ricostruzione avviene copiando i dati dal membro sano del mirror.
La tolleranza ai guasti richiede però una precisazione importante. Può sopravvivere a più guasti soltanto se non vengono persi entrambi i membri della stessa coppia in mirroring. Non è quindi corretto ridurre questa architettura alla frase “tollera due dischi”.
Per workload transazionali, database e ambienti dove la latenza delle scritture conta molto, è una delle configurazioni da valutare con più attenzione.
RAID 0+1 e RAID 10 non sono la stessa cosa
I nomi sembrano simili ma descrivono un ordine differente.
In RAID 10 vengono prima costruiti i mirror e poi distribuiti i dati tra le coppie. RAID 0+1 costruisce invece gruppi in striping e successivamente li mette in mirroring.
La differenza diventa importante quando si verifica un guasto. Nella prima architettura possono restare disponibili mirror indipendenti anche dopo più failure, purché non venga persa un’intera coppia. Nella seconda la perdita di un disco rende inutilizzabile l’intero stripe set a cui appartiene e riduce più rapidamente la ridondanza residua.
Per questo, quando una piattaforma offre RAID 10, non assumerei che “0+1” sia semplicemente un altro modo di scrivere la stessa configurazione.
RAID 2, 3, 4, 50, 60 e altri livelli: cosa serve davvero sapere
Esistono molti altri livelli e combinazioni.
RAID 2, RAID 3 e RAID 4 hanno soprattutto valore storico o di nicchia rispetto alle configurazioni più comuni sugli attuali NAS e server general purpose.
RAID 50 combina più gruppi RAID 5 attraverso striping; RAID 60 applica lo stesso principio a gruppi RAID 6. Possono diventare interessanti quando aumenta il numero di unità e serve distribuire il failure domain su più sottogruppi.
Non approfondirei però queste varianti prima di avere chiari i cinque livelli principali: spiegano quasi tutti i trade-off che servono per orientarsi.
RAID 0, 1, 5, 6 e 10 a confronto
La tabella seguente confronta proprietà strutturali, non benchmark universali. Le prestazioni reali dipendono da unità, controller, cache, filesystem, dimensione delle stripe, protocollo, workload e implementazione.
| Livello | Dischi minimi | Capacità nominale con dischi uguali | Guasti disco tollerati | Scritture | Scenario tipico | Limite principale |
|---|---|---|---|---|---|---|
| RAID 0 | 2 | N × S | 0 | Potenzialmente molto veloci | Dati temporanei, scratch, workload ricostruibili | Nessuna ridondanza |
| RAID 1 | 2 | S con due dischi | 1 con due dischi | Semplici, senza parità | NAS a 2 bay, mirroring semplice | 50% della capacità con due dischi |
| RAID 5 | 3 | (N - 1) × S | 1 | Penalizzate dalla gestione della parità | Storage general purpose attento alla capacità | Un solo guasto tollerato |
| RAID 6 | 4 | (N - 2) × S | 2 | Maggiore lavoro di parità | Array dove serve tollerare due guasti | Più capacità sacrificata |
| RAID 10 | 4, numero pari | (N / 2) × S | Dipende dalla posizione dei guasti | Adatte a I/O intenso | Database, VM, workload transazionali | Circa metà capacità disponibile |
N indica il numero di dischi e S la capacità del disco più piccolo.
Le formule descrivono il comportamento nominale dei livelli tradizionali, ma non rappresentano lo spazio che vedrai esattamente nel sistema operativo: filesystem, metadata, differenza tra unità decimali e binarie e implementazione riducono ulteriormente lo spazio mostrato.
Quanto spazio resta davvero in un RAID
La perdita di capacità è uno dei punti che creano più confusione.
Il modo più semplice per capirla è mantenere costante il numero e la dimensione delle unità e cambiare soltanto il livello.
Due dischi da 4 TB in RAID 1
Con due dischi da 4 TB:
2 × 4 TB = 8 TB installati
ma il mirroring mantiene una copia dei dati sul secondo disco.
La capacità nominale disponibile diventa quindi circa:
4 TB
Hai sacrificato metà della capacità per ottenere ridondanza.
Quattro dischi da 4 TB in RAID 5, RAID 6 e RAID 10
Con quattro unità identiche da 4 TB hai 16 TB fisicamente installati.
In RAID 5:
(4 - 1) × 4 TB = 12 TB
In RAID 6:
(4 - 2) × 4 TB = 8 TB
In RAID 10:
(4 / 2) × 4 TB = 8 TB
La differenza tra RAID 6 e RAID 10 non è quindi la capacità in questo esempio. È come ottengono la ridondanza.
Il primo usa doppia parità e può sopravvivere a due guasti indipendentemente dalla loro posizione. Il secondo usa mirror e può sopravvivere a più guasti soltanto quando rimane almeno un membro funzionante in ogni coppia. In compenso, il mirroring evita il calcolo della parità ed è particolarmente interessante nei workload di scrittura e I/O casuale.
Perché dimensioni diverse dei dischi possono cambiare la capacità utilizzabile
Nei livelli tradizionali la capacità del disco più piccolo diventa spesso il riferimento per gli altri membri dell’array.
Se combini, per esempio, un disco da 4 TB e uno da 8 TB in un mirror tradizionale, non ottieni automaticamente 8 TB di spazio protetto. Il mirror deve poter mantenere la stessa informazione su entrambe le unità e quindi la capacità utilizzabile viene limitata dal membro più piccolo.
Lo stesso principio incide sulle configurazioni con parità e su quelle basate su mirror multipli.
Alcune piattaforme utilizzano sistemi proprietari o layout più flessibili per sfruttare meglio unità di capacità differente. Synology Hybrid RAID, per esempio, è progettato per ridurre parte dello spreco tipico dei layout tradizionali con dischi disomogenei. Questo però non è un comportamento universale e non va trasferito automaticamente ad altri NAS o controller.
Quale RAID scegliere per NAS, server e workload diversi
La domanda “qual è il RAID migliore?” è troppo generica.
Quella utile è: quale failure model e quale workload devo gestire?
NAS con due dischi
Con un NAS a due vani le opzioni sono limitate.
RAID 0 aggrega capacità e prestazioni ma non offre protezione dal guasto di un disco. RAID 1 sacrifica metà della capacità e mantiene una copia dei dati su entrambe le unità.
Se il NAS contiene documenti, foto, backup di altri dispositivi o dati che devono restare accessibili dopo il guasto di un disco, sceglierei normalmente il mirroring.
QNAP indica il mirroring come configurazione tipica per NAS a due dischi.
Lo striping senza ridondanza lo riserverei a dati ricostruibili o temporanei, non all’unica copia di informazioni importanti.
NAS e server con quattro o più dischi
Con quattro o più unità la scelta diventa più interessante.
Il livello 5 massimizza meglio la capacità ma tollera un solo guasto. Il 6 sacrifica l’equivalente di due dischi ma offre doppia parità. Il 10 utilizza circa metà della capacità e punta sul mirroring, con caratteristiche favorevoli per I/O intenso e ricostruzioni più lineari.
Su un server dedicato non guarderei quindi soltanto se il provider offre HDD, SSD o NVMe. Controllerei anche numero di unità, livello, controller, hot spare, monitoraggio e politica di sostituzione dei dischi.
Una macchina con storage molto veloce ma senza una strategia coerente per i guasti può essere meno adatta di una configurazione apparentemente più conservativa.
Database e macchine virtuali
Database e macchine virtuali possono generare molto I/O casuale e frequenti scritture.
In questi scenari il livello 10 è spesso una configurazione da valutare perché combina mirroring e striping senza il lavoro di parità proprio dei livelli 5 e 6. Synology lo indica per applicazioni con elevate richieste di I/O, mentre QNAP lo associa anche a database e VDI.
Questo non significa che ogni database debba essere installato su questa architettura.
Un database piccolo su un’applicazione a basso traffico ha requisiti molto diversi da una piattaforma transazionale con migliaia di operazioni concorrenti. Anche cache, RAM, replica del database, storage di rete e architettura applicativa possono cambiare completamente la decisione.
Editing, scratch disk, cache e dati temporanei
Lo striping senza ridondanza può avere senso quando perdere il volume non significa perdere il dato originale.
Un esempio è uno scratch disk per editing o rendering, dove i file sorgenti e i risultati definitivi vengono conservati altrove. Anche Microsoft descrive Storage Spaces senza resilienza come adatti a dati temporanei e scenari in cui la capacità o la prestazione conta più della protezione da un guasto.
Qui la configurazione non è “sbagliata”: è sbagliato usarla per un failure model che richiede continuità o conservazione dei dati.
Cosa cambia con SSD e NVMe
SSD e NVMe riducono drasticamente molte latenze tipiche degli hard disk, ma non eliminano il problema del guasto dell’unità.
Anche i moderni sistemi all-flash usano mirroring, parità e altre forme di resilienza. Intel supporta diversi livelli anche su soluzioni NVMe attraverso VROC e controller compatibili; Synology documenta inoltre configurazioni specifiche per array flash.
Quello che cambia è il profilo del workload e dell’hardware.
Con unità molto veloci il collo di bottiglia può spostarsi verso controller, bus, CPU, rete o software. Per questo non trasferirei automaticamente benchmark o regole nate per HDD a un array NVMe.
Cosa succede quando un disco si guasta: degraded mode e rebuild
Il momento più delicato per un array ridondante non è quando tutto funziona. È quando un membro smette di rispondere.
Se il livello scelto può tollerare quel guasto, il volume può continuare a funzionare in degraded mode.
Significa che l’array è ancora disponibile ma ha perso una parte della ridondanza prevista. In RAID 5, per esempio, dopo il guasto di un disco non esiste più margine per perdere una seconda unità prima della ricostruzione.
Perché il rebuild è una fase critica
Quando inserisci un nuovo disco, il sistema deve ricostruire i dati necessari a riportare l’array nello stato normale.
Con il mirroring può significare copiare i dati dal membro sano. Con i livelli a parità deve invece leggere i dati e le informazioni di parità rimaste e ricostruire il contenuto mancante.
Durante questa fase lo storage svolge lavoro aggiuntivo mentre la ridondanza è già ridotta. Per questo un rebuild non dovrebbe essere trattato come un evento amministrativo secondario.
La domanda da fare prima del guasto è quindi: come scoprirò che un disco è fallito?
Se nessuno monitora SMART, stato dell’array, notifiche e alert del controller, potresti avere una configurazione ridondante senza sapere che sta già lavorando in degraded mode.
Monitoraggio, sostituzione del disco e hot spare
Un hot spare è un’unità pronta a essere utilizzata quando un membro dell’array fallisce.
Può ridurre il tempo che passa tra il rilevamento del problema e l’avvio del rebuild, ma non aumenta magicamente il numero di copie dei dati mentre è inutilizzato e non sostituisce il backup.
È inoltre fondamentale seguire la procedura prevista dal controller o dal NAS. Rimuovere l’unità sbagliata da un array già degradato può trasformare un problema recuperabile in perdita del volume.
Prima di intervenire, identifica quindi con certezza disco guasto, slot, stato dell’array e procedura documentata dal produttore.
RAID non è un backup: cosa protegge e cosa non protegge
Questo è il punto più importante dell’intero articolo.
RAID e backup risolvono problemi differenti.
Il primo può mantenere disponibili i dati quando si guasta una o più unità, nei limiti del livello utilizzato. Un backup conserva invece una copia separata dalla quale recuperare informazioni quando l’originale viene perso, cancellato, corrotto o reso inutilizzabile.
Anche Dell, nella propria documentazione sulla creazione di array, raccomanda di disporre di un backup prima di creare o riconfigurare il volume.
Guasto fisico di un disco
È il problema per cui la ridondanza dell’array è più immediatamente utile.
RAID 1 può mantenere i dati sul mirror. RAID 5 ricostruisce dopo la perdita di una unità. RAID 6 tollera due dischi guasti. RAID 10 continua a funzionare finché ogni mirror mantiene almeno un membro valido.
Qui la configurazione svolge esattamente il lavoro per cui è stata progettata.
Cancellazione, ransomware e corruzione dei dati
Se cancelli un file da un volume ridondante, la cancellazione viene normalmente applicata al volume logico e quindi non esiste una seconda copia “segreta” sul mirror da recuperare.
Lo stesso vale per molte corruzioni logiche e per un ransomware che riesce a modificare i dati accessibili al sistema.
L’array replica o distribuisce lo stato corrente dello storage. Non mantiene automaticamente una cronologia delle versioni.
Servono backup, snapshot o sistemi di versioning progettati per recuperare uno stato precedente.
Se vuoi vedere il problema da una prospettiva più vicina alla gestione di un sito, abbiamo approfondito separatamente come costruire un piano di backup evitando di dipendere da una sola copia.
Guasto dell’intero sistema e disaster recovery
Un array può perdere più dischi di quanto la configurazione sia in grado di tollerare.
Può inoltre verificarsi un guasto al controller, un errore operativo, un incendio, un furto, un danno elettrico o un incidente che coinvolga l’intero apparato.
Se volume e dati originali si trovano nello stesso dispositivo, nello stesso rack o nello stesso luogo, non hai automaticamente una strategia di disaster recovery.
La ridondanza locale deve quindi essere considerata un livello della protezione, non l’intera protezione.
Gli errori da evitare quando scegli o configuri un RAID
L’errore più comune è scegliere la configurazione partendo dal numero del livello anziché dal problema da risolvere.
Usare RAID 0 per dati che non puoi perdere
Il livello 0 non ha parità né mirror.
Se un disco fallisce, l’intero array viene compromesso. Ha senso per scratch data, cache o dataset ricostruibili; non come unica destinazione di documenti, foto, database o altri dati importanti.
Confondere ridondanza e backup
La ridondanza mantiene continuità rispetto a specifici guasti hardware.
Non ti restituisce automaticamente il documento cancellato ieri e non garantisce il recupero dopo ransomware, corruzione logica o perdita dell’intero sistema.
Se non esiste una copia separata e recuperabile, non hai risolto il problema del backup.
Ignorare controller, compatibilità e dischi supportati
Due sistemi che dichiarano “RAID 5” non sono necessariamente equivalenti in tutto.
Cambiano controller, limiti sul numero di unità, cache, hot spare, modalità di migrazione, monitoraggio, gestione degli SSD, dimensioni massime e procedure di recupero.
Verifica sempre la documentazione della piattaforma prima di acquistare i dischi o creare l’array.
Copiare una procedura di configurazione valida per un’altra piattaforma
La teoria dei livelli è trasferibile. La procedura operativa spesso non lo è.
Un NAS QNAP, un Synology, mdadm su Linux, Windows Storage Spaces e un controller hardware enterprise espongono workflow differenti.
Microsoft, per esempio, utilizza negli Storage Spaces concetti di resilienza come Simple, Mirror e Parity anziché chiederti necessariamente di scegliere gli stessi livelli numerici di un controller tradizionale.
Per questo non includerei mai una procedura universale “clicca qui e crea RAID 5” senza sapere quale piattaforma stai configurando.
Non pianificare monitoraggio e rebuild
Un array ignorato non è una strategia di disponibilità.
Devi sapere come ricevere notifiche, come identificare il disco guasto, quali unità di ricambio usare, quanto è semplice sostituirle e come verificare che il rebuild sia realmente terminato.
La scelta del livello è quindi soltanto il primo passo. Il secondo è decidere come verrà gestito quando qualcosa andrà storto.
Conclusione
Il problema diventa molto più semplice quando smetti di pensare ai livelli come a una classifica di numeri.
RAID 0 serve quando prestazioni e capacità contano più della ridondanza. RAID 1 è la scelta più lineare quando hai due dischi e vuoi mantenere una copia. RAID 5 sfrutta bene la capacità ma tollera un solo guasto. RAID 6 sacrifica più spazio per tollerarne due. RAID 10 usa circa metà della capacità ma offre un modello molto interessante per workload con I/O intenso e ricostruzioni basate sul mirroring.
Se stai configurando un NAS o un server, partirei quindi da quattro informazioni: numero di dischi, capacità necessaria, numero di guasti che devi poter sostenere e tipo di workload.
Poi aggiungerei la domanda che evita l’errore più costoso:
dove si trova il backup quando l’intero array non è più recuperabile?
Se la risposta è “sullo stesso RAID”, il progetto di storage non è ancora completo.