
Il peer-to-peer, abbreviato in P2P, è un modello di rete nel quale i partecipanti possono mettere a disposizione risorse e, allo stesso tempo, utilizzare quelle offerte dagli altri. Un peer non è quindi relegato al solo ruolo di client o al solo ruolo di server: può assumere entrambe le funzioni a seconda della comunicazione in corso.
È questo il concetto da conservare. Non il vecchio luogo comune secondo cui P2P significherebbe semplicemente “scaricare file”, e neppure l’idea che qualsiasi rete peer-to-peer debba funzionare senza alcun componente centrale.
Per capire dove si colloca questo modello conviene partire da come funziona Internet: Internet fornisce l’infrastruttura attraverso cui sistemi e reti differenti possono comunicare; il peer-to-peer descrive invece come un’applicazione o una rete logica distribuisce i ruoli tra i nodi che partecipano al servizio.
Peer-to-peer: significato e definizione
L’espressione inglese peer-to-peer significa letteralmente “da pari a pari”. In italiano si parla anche di rete paritaria o paritetica.
La definizione più utile non parte però dalla traduzione, ma dai ruoli: in un’architettura P2P i nodi non sono rigidamente separati tra macchine che chiedono un servizio e macchine che lo forniscono. Un peer può ricevere una risorsa da un altro nodo e, nello stesso sistema, offrirne una propria.
Anche il glossario della Commissione europea sulla connettività digitale descrive una rete P2P pura come un sistema di nodi equivalenti che possono operare contemporaneamente come client e server.
Cosa significa “peer” e perché si parla di nodi paritari
Un peer è un partecipante della rete.
Immagina tre computer, A, B e C. In una normale relazione client-server potresti avere A, B e C che chiedono tutti un file a un server centrale. Nel modello P2P, invece, A può ricevere una parte della risorsa da B e un’altra da C, mentre contemporaneamente mette a disposizione ciò che possiede.
La parità riguarda quindi soprattutto il modello dei ruoli.
Non significa che tutti i computer abbiano la stessa potenza, la stessa connessione, lo stesso spazio disponibile o la stessa importanza pratica. Un peer con una linea veloce e molta banda può contribuire più di uno smartphone collegato in modo intermittente, pur appartenendo entrambi alla stessa rete.
P2P non significa necessariamente “nessun server”
Questa è una delle semplificazioni più diffuse.
In una rete peer-to-peer pura, le funzioni essenziali possono effettivamente essere distribuite tra i nodi senza dipendere da un server centrale. Nella pratica, però, molti sistemi combinano comunicazioni P2P con componenti centralizzati.
Un servizio centrale potrebbe, per esempio, aiutare un nuovo peer a trovare altri nodi. Dopo questa fase, i dati possono essere scambiati direttamente tra i partecipanti.
Il punto quindi non è chiedersi soltanto:
c'è un server?
È più utile chiedersi:
che funzione svolge quel server e dove avviene realmente lo scambio della risorsa?
IBM distingue proprio fra architettura peer-to-peer, client-server e sistemi ibridi che combinano caratteristiche dei due modelli nel suo approfondimento sulle architetture di rete.
Come funziona una rete peer-to-peer
Una rete P2P non può limitarsi a mettere molti computer “sullo stesso Internet”. Prima che due peer possano comunicare, devono sapere che l’altro esiste, stabilire una connessione compatibile e capire quali risorse possono scambiarsi.
In forma semplificata, il percorso è:
ingresso nella rete → scoperta dei peer → connessione → scambio → nuova disponibilità della risorsa
Ogni protocollo implementa questi passaggi a modo proprio.
Come fanno i peer a trovarsi: discovery, bootstrap e indicizzazione
Quando un’applicazione peer-to-peer viene avviata per la prima volta deve risolvere un problema apparentemente banale: come trovare il primo peer.
Il processo iniziale viene spesso chiamato bootstrap.
A seconda del sistema possono essere utilizzati:
- indirizzi conosciuti in precedenza;
- nodi di bootstrap;
- directory;
- DNS seed;
- tracker;
- tabelle distribuite;
- informazioni ricevute da altri peer già contattati.
Questi strumenti non svolgono necessariamente la stessa funzione del server di un’applicazione Web tradizionale.
Possono semplicemente fornire un punto d’ingresso.
Bitcoin offre un esempio utile: un nodo che non conosce ancora partecipanti attivi può utilizzare dei DNS seed per ottenere indirizzi iniziali; una volta collegato, può apprendere l’esistenza di ulteriori peer direttamente dalla rete, come documentato nella guida alla rete P2P di Bitcoin.
Questo fa capire perché bootstrap e funzionamento ordinario della rete non sono la stessa cosa.
Cosa succede quando due peer iniziano a scambiarsi dati o risorse
Una volta individuato un altro partecipante, i due sistemi devono utilizzare un protocollo compatibile.
Possono quindi verificare informazioni sulla connessione, comunicarsi quali risorse possiedono e richiedere ciò che serve.
Nel file sharing, per esempio, un peer potrebbe non scaricare un intero file da una sola macchina. La risorsa può essere suddivisa in parti e recuperata da più partecipanti che ne possiedono copie differenti.
Quando il peer riceve una parte valida, può a sua volta renderla disponibile agli altri.
È qui che il modello diventa molto diverso dal download classico:
server → molti client
può trasformarsi in:
peer A ↔ peer B ↔ peer C ↔ peer D
La capacità complessiva di distribuzione non dipende più soltanto dalla banda della sorgente iniziale.
DHT e tracker: perché coordinamento e trasferimento non sono la stessa cosa
BitTorrent permette di vedere bene la differenza.
Nella specifica originaria, un tracker consente ai client interessati allo stesso contenuto di ottenere informazioni su altri peer. Il tracker facilita quindi l’incontro, mentre il protocollo peer gestisce lo scambio delle parti del file, come descritto nella specifica del protocollo BitTorrent BEP 3.
Questo non significa che BitTorrent dipenda sempre da un tracker.
La relativa Distributed Hash Table, o DHT, consente di conservare in modo distribuito informazioni utili per trovare i peer associati a un determinato contenuto. La DHT di BitTorrent è basata su Kademlia e permette quindi anche scenari trackerless, come documentato nella specifica BEP 5.
La distinzione essenziale è:
discovery = capire quali peer possono essere utili;
trasferimento = scambiare effettivamente i dati.
Mescolare i due livelli porta facilmente alla conclusione sbagliata secondo cui la semplice presenza di un tracker renderebbe l’intero sistema client-server.
Peer-to-peer e client-server: qual è la differenza
P2P e client-server non sono due etichette per descrivere la velocità di una rete. Sono modelli differenti per distribuire ruoli e responsabilità.
Nel client-server un insieme di client utilizza risorse fornite da uno o più server. Nel P2P i partecipanti possono invece contribuire direttamente con proprie risorse.
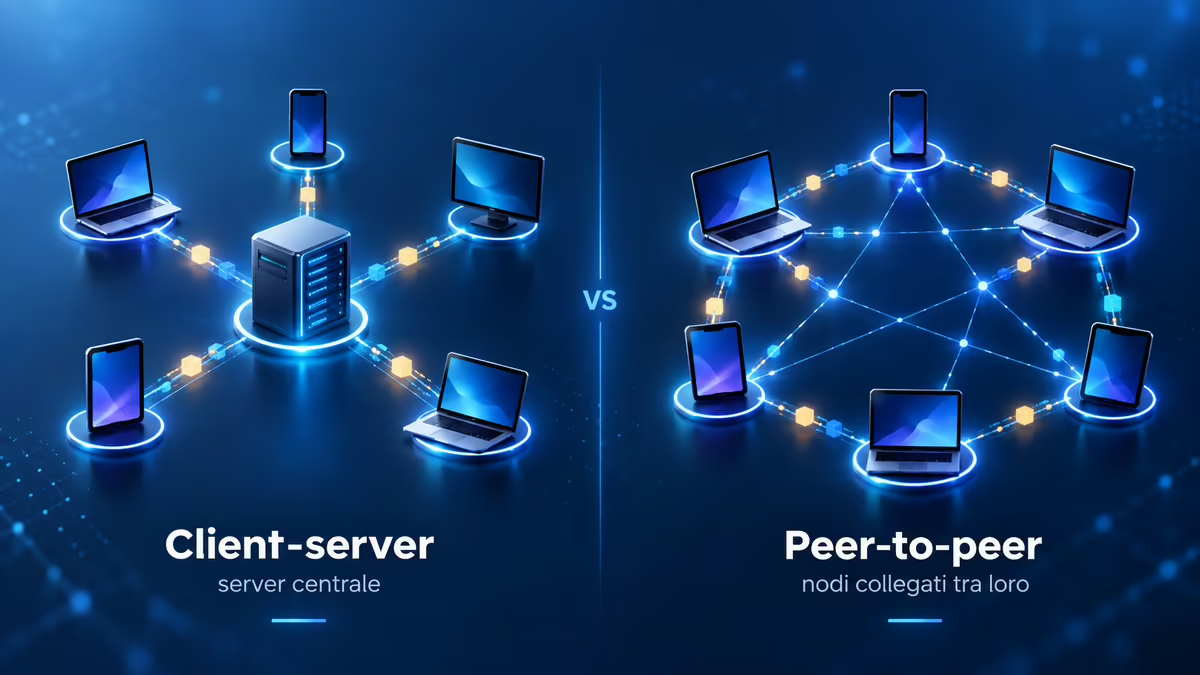
| Aspetto | Peer-to-peer | Client-server |
|---|---|---|
| Ruoli | un nodo può consumare e fornire risorse | client e server hanno funzioni più distinte |
| Scambio | può avvenire direttamente tra peer | normalmente passa dal servizio fornito dal server |
| Risorse | possono essere distribuite tra molti partecipanti | concentrate principalmente nell’infrastruttura server |
| Gestione | più distribuita e spesso più complessa | più semplice da centralizzare e controllare |
| Disponibilità | può dipendere dal numero e dallo stato dei peer | dipende fortemente dall’infrastruttura del servizio |
Non significa che un modello sia sempre migliore dell’altro.
Un sito Web, un gestionale o un database aziendale possono beneficiare enormemente di un’architettura client-server controllata. La distribuzione P2P diventa invece interessante quando i partecipanti devono anche contribuire con banda, dati, capacità di calcolo o altre risorse.
Come cambiano ruoli, risorse e dipendenza dall’infrastruttura centrale
In un’applicazione Web classica il browser richiede una pagina a un server.
Puoi avere CDN, replica, bilanciamento del carico e decine di server fisici, ma dal punto di vista logico il client continua a chiedere il servizio all’infrastruttura che lo fornisce.
Nel P2P una parte della capacità necessaria al servizio può invece provenire dagli stessi utilizzatori della rete.
Questo sposta il problema.
Un’infrastruttura centralizzata deve dimensionare i propri server per sostenere la domanda. Una rete P2P deve invece gestire peer che possono comparire, sparire, cambiare connessione, avere risorse differenti o non essere sempre raggiungibili.
Perché molti sistemi reali usano architetture ibride
La scelta reale raramente è ideologica.
Un sistema può ottenere vantaggi dal P2P per la distribuzione dei dati e utilizzare comunque servizi centralizzati per autenticazione, indicizzazione, bootstrap, discovery, aggiornamenti o altre funzioni.
L’architettura va quindi letta per componenti.
Quando trovi un server centrale, chiediti quale problema risolve. Se coordina l’ingresso nella rete ma il contenuto passa direttamente tra peer, il sistema non diventa automaticamente identico a un normale download client-server.
Tipi di reti P2P
Non tutte le reti peer-to-peer organizzano i partecipanti nello stesso modo.
Due distinzioni aiutano a orientarsi: puro vs ibrido e strutturato vs non strutturato. Descrivono aspetti diversi e non vanno confusi.
Reti peer-to-peer pure e ibride
In una rete P2P pura le funzioni essenziali del sistema sono affidate ai peer.
Non esiste un componente centrale indispensabile che debba coordinare continuamente il funzionamento della rete.
In un sistema ibrido alcune operazioni possono invece essere centralizzate. Può esistere, per esempio, un servizio che facilita il discovery o l’accesso iniziale, mentre i trasferimenti avvengono direttamente tra i nodi.
L’ibrido non rappresenta necessariamente un P2P “incompleto”.
Spesso è una scelta progettuale: centralizzare ciò che è più semplice gestire in quel modo e distribuire ciò che beneficia realmente della partecipazione dei peer.
Reti strutturate e DHT
Una rete P2P strutturata organizza le informazioni necessarie alla ricerca secondo regole definite.
Le Distributed Hash Table sono uno dei meccanismi più noti.
Invece di chiedere a tutti i nodi “chi possiede questa risorsa?”, il sistema associa identificatori e nodi seguendo una struttura che permette di restringere progressivamente la ricerca.
Kademlia è un esempio importante di questo approccio e costituisce la base della DHT usata da BitTorrent.
Anche la rete Kad utilizzata da aMule deriva dalla stessa famiglia concettuale. Se vuoi vedere come questi principi vengono applicati da un software reale, nella guida a aMule, eD2k e Kad analizziamo separatamente client, reti e configurazione.
Reti non strutturate e ricerca distribuita
In una rete non strutturata non esiste necessariamente una mappatura deterministica fra una risorsa e una posizione logica della rete.
I nodi possono scoprire informazioni interrogando vicini, propagando richieste o utilizzando meccanismi probabilistici.
Il vantaggio è una minore rigidità nella costruzione della topologia.
Il prezzo da pagare può essere una ricerca meno efficiente, soprattutto quando la risorsa è rara o la rete è molto grande.
Per questo “P2P” da solo non descrive l’intero comportamento del sistema: due reti paritarie possono usare meccanismi di discovery radicalmente differenti.
A cosa serve il P2P oggi
La popolarità di Napster, eMule e BitTorrent ha legato il termine P2P al file sharing, ma il modello è molto più generale.
Una rete peer-to-peer può distribuire file, propagare informazioni, mantenere una rete di nodi o creare collegamenti diretti fra dispositivi. Il filo comune non è il tipo di contenuto: è il modo in cui vengono distribuiti i ruoli.
File sharing: BitTorrent, eD2k, Kad e aMule
La distribuzione di file rimane il caso più intuitivo.
Con BitTorrent un contenuto può essere suddiviso in parti e scaricato da peer diversi. Chi possiede una parte può metterla a disposizione degli altri partecipanti allo stesso swarm.
Il risultato è particolarmente interessante quando molte persone richiedono lo stesso contenuto: la sorgente originale non deve necessariamente sostenere da sola tutto il traffico.
Altri ecosistemi hanno utilizzato reti differenti.
aMule, per esempio, supporta eD2k e Kad. eD2k può utilizzare server per alcune funzioni di discovery, mentre Kad utilizza una rete distribuita basata su Kademlia.
Sono quindi un altro esempio del motivo per cui software, protocollo di discovery e modalità di trasferimento non devono essere trattati come se fossero la stessa cosa.
Blockchain e criptovalute come reti di nodi
Il P2P ha un ruolo importante anche in Bitcoin.
La rete permette ai nodi di comunicare e propagare transazioni e blocchi senza un server centrale incaricato di mantenere l’unica copia autorevole.
Questo non significa che “P2P = blockchain”.
La rete peer-to-peer rappresenta soltanto una componente dell’architettura. Bitcoin combina anche firme crittografiche, regole di consenso, Proof of Work e una blockchain.
Nella guida su come funziona Bitcoin questi livelli vengono separati proprio per evitare di usare decentralizzazione, P2P e blockchain come sinonimi. Per il funzionamento più generale del registro distribuito puoi invece approfondire cos’è una blockchain.
Comunicazioni dirette e altri utilizzi del modello peer-to-peer
Il principio può essere applicato anche fuori dai sistemi di file sharing pubblici.
Alcune tecnologie cercano di creare una comunicazione più diretta tra dispositivi per ridurre la dipendenza da un percorso centrale quando le condizioni lo consentono.
Un esempio vicino all’uso quotidiano è AirPlay peer-to-peer, che in configurazioni supportate può permettere a dispositivi Apple compatibili di scoprirsi e comunicare senza dipendere dalla normale rete Wi-Fi infrastrutturale condivisa.
Ancora una volta, “peer-to-peer” descrive il modello di relazione tra i partecipanti, non un singolo protocollo universale.
Vantaggi e limiti delle reti peer-to-peer
Il P2P risolve bene alcuni problemi, ma ne introduce altri.
Il vantaggio più evidente è poter utilizzare le risorse distribuite tra i partecipanti. Il limite corrispondente è che quelle risorse non sono necessariamente stabili, omogenee o sempre disponibili.
Distribuzione delle risorse, scalabilità e resilienza
Se un file è disponibile presso molti peer, la sua distribuzione non dipende da una sola macchina.
L’arrivo di nuovi partecipanti può perfino aumentare la capacità complessiva del sistema quando questi iniziano a condividere ciò che hanno già ricevuto.
Da qui derivano alcuni vantaggi potenziali:
- distribuzione del traffico;
- uso della banda dei partecipanti;
- minore dipendenza da una singola sorgente;
- possibilità di continuare a funzionare quando alcuni peer escono dalla rete;
- crescita della capacità di distribuzione insieme al numero di peer, in alcuni scenari.
Non sono però garanzie automatiche.
Se una risorsa rara è posseduta da un solo peer e quel nodo sparisce, la distribuzione si ferma. Se gran parte dei partecipanti ha connessioni lente, anche le prestazioni possono diventare modeste.
Discovery, disponibilità dei peer, banda e gestione della rete
Un server professionale può essere progettato per rimanere acceso, raggiungibile e monitorato continuamente.
Un peer domestico no.
Può spegnere il computer, cambiare indirizzo, perdere la connessione o limitare la banda.
Un sistema P2P deve quindi affrontare problemi come:
- ingresso e uscita continua dei nodi;
- discovery;
- copie insufficienti di una risorsa;
- velocità differenti tra peer;
- verifica dell’integrità;
- gestione degli aggiornamenti;
- abuso da parte di nodi malevoli.
Una rete distribuita elimina alcuni punti centrali, ma rende altri problemi più complessi.
NAT e CGNAT: perché alcuni peer possono essere difficili da raggiungere
Per comunicare direttamente, un peer deve poter stabilire una connessione con un altro nodo.
Con IPv4, però, molti dispositivi si trovano dietro NAT. In una normale rete domestica diversi computer utilizzano indirizzi privati e condividono verso Internet lo stesso indirizzo pubblico.
Con CGNAT, la traduzione avviene anche nella rete dell’operatore e più clienti possono condividere lo stesso IPv4 pubblico.
Questo non impedisce necessariamente a un’applicazione P2P di funzionare, ma può complicare le connessioni in ingresso.
A seconda del protocollo possono essere utilizzati port forwarding, NAT traversal, hole punching, relay o semplicemente connessioni avviate dal peer interno.
La guida su indirizzo IP, NAT e CGNAT spiega perché l’indirizzo locale di un computer, quello WAN del router e quello pubblico visto su Internet possono essere differenti.
Sicurezza, privacy e legalità del P2P
Peer-to-peer non significa automaticamente sicuro, anonimo o illegale.
Sono tre questioni differenti.
Il modello P2P descrive come comunicano i partecipanti. Sicurezza, privacy e diritto d’autore dipendono invece dal protocollo, dal software, dalle protezioni implementate e da ciò che viene effettivamente scambiato.
Peer-to-peer non significa anonimo
Una connessione diretta richiede normalmente che i partecipanti dispongano delle informazioni necessarie a raggiungersi.
In BitTorrent, per esempio, tracker e sistemi di discovery gestiscono informazioni che includono gli endpoint dei peer necessari a stabilire le connessioni.
Questo è già sufficiente a capire un punto importante:
decentralizzato non significa anonimo.
Una rete P2P può utilizzare crittografia o sistemi progettati specificamente per aumentare la privacy, ma queste caratteristiche devono essere implementate. Non derivano automaticamente dalla parola peer-to-peer.
Lo stesso vale per la sicurezza dei dati.
Ricevere un file da un altro peer non dimostra che il file sia affidabile. Integrità, autenticità e provenienza vanno gestite dal protocollo o verificate dall’utente e dall’applicazione.
La tecnologia P2P è neutrale: conta che cosa viene condiviso
Il peer-to-peer è una tecnologia di rete.
Può essere utilizzata per distribuire software autorizzato, dataset, aggiornamenti, contenuti pubblici o risorse messe a disposizione legittimamente dai rispettivi titolari.
Può anche essere utilizzata per condividere materiale senza disporre dei relativi diritti.
Il problema giuridico non nasce quindi dalla semplice esistenza di una connessione P2P. Dipende dal contenuto, dai diritti coinvolti e dall’uso concreto.
La stessa distinzione evita un errore storico ancora frequente: identificare BitTorrent o l’intera tecnologia peer-to-peer con la pirateria. Un protocollo di distribuzione e il modo in cui una persona decide di usarlo sono due questioni differenti.
Quando P2P non significa peer-to-peer informatico
La sigla P2P è diventata abbastanza diffusa da essere utilizzata in contesti che non descrivono un’architettura di rete informatica.
È una delle ragioni per cui cercare soltanto “P2P” può produrre risultati molto diversi tra loro.
P2P nei pagamenti: person-to-person
Nel settore finanziario e nei servizi di pagamento, P2P può indicare un trasferimento person-to-person, cioè da una persona a un’altra.
Il concetto commerciale è quello del pagamento diretto fra utenti, ma l’applicazione che utilizzi può continuare a dipendere da server, database, provider e infrastrutture centrali.
Non bisogna quindi dedurre l’architettura informatica dal nome del servizio.
pagamento P2P e rete P2P possono indicare due cose completamente differenti.
Peer to peer nella scuola e nella formazione tra pari
Anche nel mondo della formazione l’espressione peer to peer viene utilizzata per indicare attività tra pari, osservazione reciproca, tutoring o apprendimento collaborativo.
Qui peer conserva il significato generale di “pari”, ma non stiamo parlando di nodi di rete.
La differenza di contesto è netta:
peer-to-peer informatico → nodi e risorse di una rete
peer-to-peer educativo → persone che apprendono o lavorano tra pari
Questa ambiguità spiega perché una ricerca sul termine generico possa mostrare insieme pagine di networking, pagamenti e formazione.
Conclusione
Il modo più utile per capire il peer-to-peer è smettere di pensarlo come sinonimo di eMule, torrent o “assenza di server”.
Il P2P è prima di tutto un modello di distribuzione dei ruoli: i peer possono utilizzare risorse e, nello stesso sistema, offrirne agli altri.
Da questo principio discendono architetture molto diverse.
Alcune sono quasi completamente distribuite. Altre utilizzano servizi centrali per il bootstrap o la discovery. Alcune organizzano i nodi attraverso una DHT, altre usano meccanismi meno strutturati. BitTorrent può usare tracker o DHT; aMule combina reti differenti; Bitcoin usa una rete P2P per propagare informazioni tra nodi.
Se devi conservare un solo modello mentale, usa questo:
prima i peer devono trovarsi, poi devono stabilire come comunicare, infine possono scambiarsi la risorsa.
Discovery, coordinamento e trasferimento sono problemi distinti. Una volta separati questi tre livelli diventa molto più semplice capire sia il peer-to-peer sia le differenze reali rispetto al classico modello client-server.