

OpenClaw è uno di quei progetti che diventano difficili da spiegare quando li si riduce a un’etichetta. Chiamarlo “assistente AI” è corretto ma incompleto; definirlo semplicemente un agente AI dice ancora meno.
Più precisamente, OpenClaw è un assistente AI personale self-hosted, costruito attorno a un Gateway che fa da piano di controllo sempre attivo. Il Gateway collega canali come Telegram, WhatsApp, Slack o Discord agli agenti, ai modelli e agli strumenti configurati, e viene eseguito sul tuo computer o su un server. L’assistente è il prodotto; il Gateway è l’infrastruttura che coordina sessioni, instradamento e capacità.
È quindi molto diverso dall’aprire un assistente hosted come ChatGPT e iniziare una conversazione.
Con OpenClaw sei tu a gestire una parte importante dell’infrastruttura e, soprattutto, a decidere quali capacità concedere all’agente. È il suo vantaggio principale, ma anche il motivo per cui sicurezza e configurazione contano almeno quanto il modello AI scelto.
Al 20 ottobre 2026 la release stabile corrente è OpenClaw 2026.10.5, pubblicata il 18 ottobre. Il progetto evolve rapidamente e diverse guide nate durante l’esplosione iniziale di febbraio 2026 descrivono ormai un prodotto sensibilmente diverso da quello attuale.
La documentazione ufficiale di OpenClaw resta quindi il riferimento da controllare prima di installare o modificare configurazioni sensibili.
Cos’è OpenClaw e perché è diverso da un normale chatbot
Un chatbot tradizionale riceve un messaggio, lo passa a un modello e restituisce una risposta. Anche quando può utilizzare qualche strumento, l’esperienza rimane normalmente legata all’applicazione che stai utilizzando.
OpenClaw introduce un livello diverso.
Il suo Gateway rimane attivo come punto centrale tra i canali da cui arrivano le richieste, gli agenti che le elaborano e gli strumenti che possono eseguire azioni. Questo permette di costruire un assistente persistente che non vive necessariamente dentro una singola finestra web.
È la stessa distinzione generale che abbiamo visto parlando di agenti AI: il salto importante non è produrre testo migliore, ma poter trasformare un obiettivo in una sequenza di operazioni.
OpenClaw aggiunge a questa logica un elemento specifico: il piano di controllo è sotto la tua gestione.
Da ClawdBot e Moltbot a OpenClaw: perché i vecchi nomi contano ancora
Se cercando informazioni sul progetto incontri ClawdBot o Moltbot, non stai necessariamente leggendo di prodotti differenti.
Sono nomi precedenti dello stesso progetto.
La storia ufficiale racconta che il sistema nacque inizialmente come gateway WhatsApp, passò attraverso Clawd/ClawdBot e, dopo una richiesta di cambio nome legata al marchio, diventò brevemente Moltbot. Il 30 gennaio 2026 arrivò il nome definitivo OpenClaw.
È un dettaglio apparentemente secondario, ma ha una conseguenza pratica: una guida che utilizza ancora configurazioni, variabili d’ambiente o procedure di ClawdBot/Moltbot può essere tecnicamente superata anche se ha pochi mesi.
Le vecchie variabili d’ambiente specifiche di OpenClaw che iniziavano con <code>CLAWDBOT_</code> o <code>MOLTBOT_</code> oggi vengono ignorate. I controlli runtime specifici di OpenClaw usano invece il prefisso <code>OPENCLAW_</code>: per esempio, <code>CLAWDBOT_GATEWAY_TOKEN</code> è diventata <code>OPENCLAW_GATEWAY_TOKEN</code>. Le variabili dei provider esterni, come le API key dei singoli servizi, mantengono invece i nomi documentati dal relativo provider.
Il rebrand va quindi trattato come un problema di compatibilità documentale, non come semplice curiosità storica.
Self-hosted e local-first: cosa resta sotto il tuo controllo e cosa no
“Self-hosted” è uno dei motivi per cui OpenClaw attira così tanto interesse, ma va interpretato correttamente.
Il Gateway può essere eseguito sulla tua macchina, su un server o su una VPS e il progetto è distribuito con licenza MIT. Non sei obbligato a utilizzare un servizio OpenClaw ospitato dal vendor, perché un servizio hosted ufficiale a pagamento non esiste: la OpenClaw Foundation dichiara di non vendere tier, hosting o token.
Questo non significa però che ogni dato rimanga automaticamente sul computer.
Se configuri un modello tramite un provider cloud, per esempio attraverso le API di un’azienda come OpenAI, le richieste necessarie all’inferenza raggiungeranno quel provider. Se colleghi WhatsApp, Telegram o Slack, stai utilizzando anche l’infrastruttura di quei servizi. Se aggiungi API, browser remoti o altri strumenti, entrano nuovi soggetti e nuovi confini di fiducia.
OpenClaw supporta anche modelli locali attraverso soluzioni come Ollama, LM Studio e server self-hosted compatibili, quindi puoi spostare localmente una parte ulteriore dello stack. Ma local-first non equivale a local-only.
La domanda utile è sempre: quale componente sta elaborando quali dati?
È una distinzione importante anche dal punto di vista della sicurezza. La documentazione OpenClaw avverte che i modelli locali non beneficiano automaticamente dei filtri di sicurezza offerti dai provider hosted e che modelli piccoli o fortemente quantizzati possono troncare più facilmente il contesto e aumentare il rischio di prompt injection. Spostare l’inferenza in locale modifica quindi il perimetro, ma non rende automaticamente l’intero sistema più sicuro.
Come funziona OpenClaw: Gateway, agenti, memoria e strumenti
Il modello mentale più semplice è questo:
canale → Gateway → agente → modello e strumenti → risultato → Gateway → canale
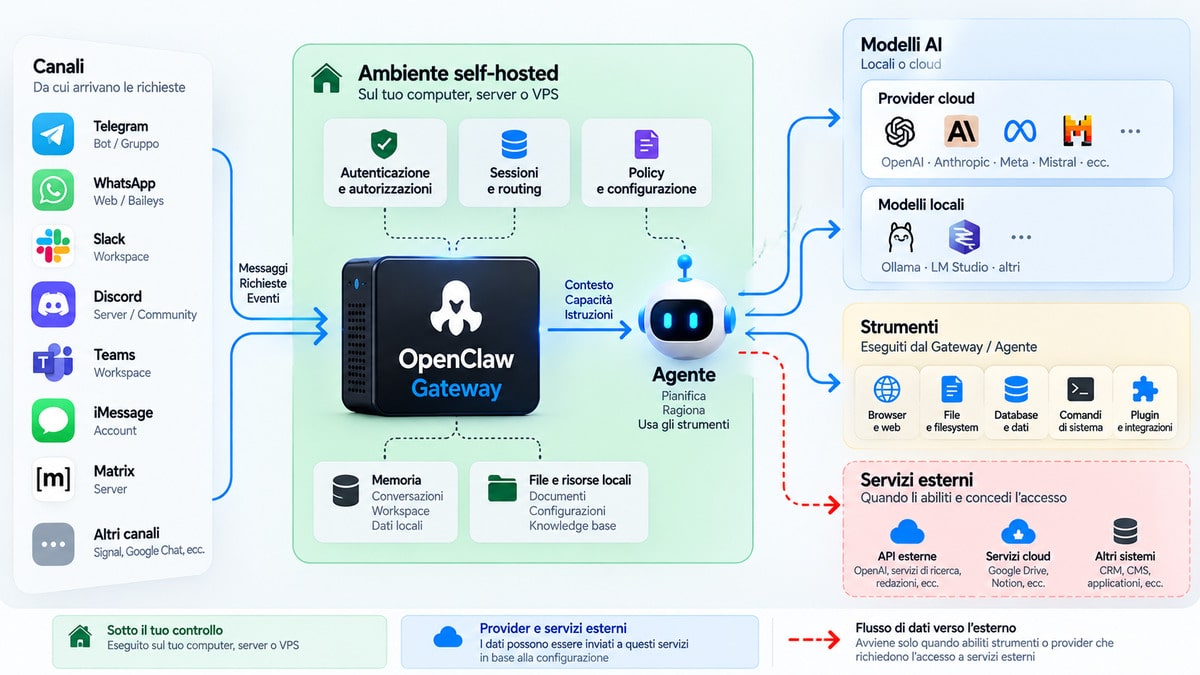
Il Gateway è la parte che coordina il sistema.
Riceve un messaggio da una sorgente autorizzata, individua sessione e agente corretti, mette a disposizione il contesto e le capacità previste dalla configurazione e gestisce il ritorno del risultato.
Non è quindi il modello linguistico a “essere OpenClaw”.
Il modello è una delle componenti sostituibili del sistema.
Il Gateway è il centro dell’architettura
La documentazione ufficiale definisce il Gateway come il piano di controllo che mantiene lo stato delle sessioni, gestisce il routing e coordina le connessioni ai canali.
Questo ha un effetto pratico notevole.
Puoi parlare allo stesso ecosistema da interfacce differenti senza dover ricostruire ogni volta l’intera integrazione. Il Gateway conosce quali canali sono collegati, quali agenti sono disponibili e quali policy devono essere applicate.
L’interfaccia web, la CLI e le applicazioni desktop sono quindi diversi punti d’accesso allo stesso livello di controllo, non tre assistenti indipendenti.
È anche il motivo per cui l’esposizione del Gateway va trattata seriamente: chi ottiene accesso al piano di controllo può raggiungere capacità molto più importanti di una semplice chat.
Modelli AI, sessioni e memoria: chi fa cosa
OpenClaw non obbliga a utilizzare un solo modello.
La documentazione corrente include provider cloud e locali e permette di scegliere modelli differenti in base alla configurazione.
Questo separa tre concetti che spesso vengono confusi:
il modello genera e ragiona sull’input che riceve;
l’agente combina modello, istruzioni, strumenti, memoria e comportamento;
il Gateway gestisce infrastruttura, sessioni, canali, policy e routing.
La distinzione diventa importante appena utilizzi più agenti.
Puoi separare workspace, conversazioni e responsabilità, ma non devi interpretare questa separazione come un confine di sicurezza multi-tenant. All’interno di un singolo Gateway valgono regole di fiducia precise che vedremo più avanti.
Skill, Plugin e ClawHub: come OpenClaw estende le sue capacità
Le capacità di OpenClaw non terminano con l’installazione base.
Le Skill forniscono istruzioni e risorse che insegnano all’agente come e quando utilizzare determinate capacità. I Plugin estendono invece il runtime con integrazioni o funzionalità aggiuntive.
ClawHub è il registro pubblico attraverso cui Skill e Plugin possono essere cercati, installati e aggiornati.
Qui emerge una differenza importante rispetto a un semplice prompt salvato.
Una componente installata può richiedere accesso a file, credenziali, comandi o servizi esterni. Per questo va trattata più come software che come semplice “testo per l’AI”.
ClawHub dispone oggi di audit e segnali di rischio che aiutano a valutare una release, ma la documentazione specifica chiaramente che un audit positivo non garantisce l’assenza di rischio.
Il criterio corretto rimane il minimo privilegio: installare ciò che serve, comprendere quale autorità richiede e limitarne l’accesso quando possibile.
WhatsApp, Telegram, Slack, Discord e gli altri canali
Uno dei punti distintivi di OpenClaw è il livello multicanale.
La documentazione corrente elenca Telegram, WhatsApp, Discord, Slack, Signal, Microsoft Teams, Google Chat, Matrix, iMessage e molte altre integrazioni. Il packaging non è identico per tutti i canali: alcuni fanno parte della distribuzione principale o dei Plugin in bundle, altri vengono installati separatamente. WhatsApp, per esempio, è oggi un Plugin ufficiale installabile on demand.
Per iniziare velocemente, la documentazione indica Telegram come uno dei percorsi più semplici, perché è sufficiente configurare il token di un bot.
WhatsApp richiede invece il collegamento dell’account tramite QR e mantiene più stato sul sistema. La relativa integrazione è oggi classificata production-ready via WhatsApp Web/Baileys.
Questo è uno dei punti in cui le guide di inizio 2026 possono risultare più facilmente obsolete: il supporto ai canali e il relativo packaging sono cambiati parecchio.
Cosa puoi fare con OpenClaw nella pratica
Descrivere OpenClaw attraverso un elenco di feature dice poco. Il valore emerge quando un messaggio può diventare un workflow.
Un’attività può partire da una chat, utilizzare strumenti, consultare dati, lavorare su file o browser e restituire il risultato sul canale da cui è partita.
La capacità effettiva dipende però da ciò che hai configurato.
OpenClaw non acquisisce magicamente accesso al tuo computer perché è stato installato: sono gli strumenti, i Plugin, le policy e le autorizzazioni che determinano cosa può fare.
Automatizzare attività tra file, browser e servizi online
Puoi configurare agenti capaci di utilizzare strumenti per lavorare su file, interagire con un browser o collegarsi a servizi esterni.
In questo senso OpenClaw svolge un ruolo di orchestrazione.
Un workflow potrebbe, per esempio, ricevere una richiesta via Telegram, consultare una fonte, elaborare dati e restituire il risultato. Un altro potrebbe lavorare su documenti presenti in un workspace dedicato.
Un esempio concreto dello stesso cambio di paradigma si vede con WordPress MCP e gli AI Agent: un agente esterno non si limita a suggerire cosa fare nel CMS, ma può scoprire e utilizzare le operazioni che WordPress gli espone, se dispone delle autorizzazioni necessarie.
Più aumentano le capacità, però, più cresce la conseguenza di un errore.
Un agente che può soltanto leggere un documento ha un profilo di rischio molto diverso da uno che può eseguire comandi, utilizzare il browser autenticato e modificare file.
La configurazione dovrebbe riflettere questa differenza.
Usare OpenClaw come assistente personale persistente
L’idea interessante non è semplicemente poter chattare da WhatsApp invece che da un sito web.
È avere un punto di orchestrazione persistente che può mantenere sessioni e collegare più superfici.
Questo rende OpenClaw adatto a chi vuole costruire un assistente personale che rimanga disponibile nel tempo e possa essere raggiunto dai canali già utilizzati durante la giornata.
“Persistente”, però, non significa “autorizzato a fare tutto”.
Un buon setup mantiene separati:
disponibilità dell’assistente → accesso al contesto → accesso agli strumenti → autorizzazione alle azioni
Sono quattro livelli differenti.
Quando l’autonomia è utile e quando è meglio un workflow deterministico
Non ogni automazione migliora quando viene affidata a un agente.
Se un processo ha passaggi invariabili, input strutturati e output perfettamente prevedibili, uno script o un’automazione deterministica possono essere più semplici da controllare, testare e correggere.
L’approccio agentico diventa più interessante quando il percorso non può essere definito completamente in anticipo: ricerca, classificazione, scelta dello strumento, interpretazione di contenuti o gestione di eccezioni sono esempi tipici.
È una distinzione utile anche quando devi scegliere tra diversi AI tools: non sempre lo strumento con più autonomia è quello più adatto al lavoro da svolgere.
La domanda non è quindi “posso farlo fare a OpenClaw?”. È piuttosto:
ho davvero bisogno che un modello scelga come arrivare al risultato?
Questa distinzione evita di utilizzare un agente dove un processo più semplice sarebbe migliore.
Come installare OpenClaw
Nel 2026 l’installazione è molto meno ostica rispetto alle prime versioni del progetto.
La pagina Install ufficiale offre più percorsi: quick start con <code>npx</code>, script di installazione per macOS/Linux/WSL2 e PowerShell su Windows, Windows Hub per il desktop, package manager come npm/pnpm/bun e opzioni più avanzate come Docker, Nix o installazione dai sorgenti.
Gli script di installazione possono rilevare il sistema operativo, predisporre una versione di Node supportata quando necessario, installare OpenClaw e avviare l’onboarding.
Questo cambia il problema pratico: installare OpenClaw non è più necessariamente la parte difficile. La parte da progettare con attenzione è ciò che viene abilitato dopo.
Requisiti e scelta del percorso per Windows, macOS e Linux
Su macOS e Linux il percorso standard passa normalmente dallo script di installazione ufficiale o da un package manager supportato.
Windows merita invece una nota separata.
La documentazione attuale consiglia come percorso desktop il Windows Hub, un’applicazione nativa che può gestire setup, stato del Gateway, chat, diagnostica e alcune capability del nodo Windows. Può predisporre anche un Gateway locale gestito in WSL.
Per chi preferisce il terminale rimangono disponibili il programma di installazione PowerShell e WSL2.
Non sceglierei Docker soltanto perché “sembra più professionale”. Ha senso quando vuoi isolamento, deployment riproducibile o un host dedicato. Per un primo utilizzo locale, il percorso più semplice riduce il numero di componenti che devi diagnosticare.
Installer, onboarding e verifica del Gateway
Dopo l’installazione, il passaggio centrale è l’onboarding.
Il comando <code>openclaw onboard</code> guida la configurazione iniziale; nelle installazioni dove vuoi predisporre anche il servizio puoi utilizzare <code>openclaw onboard –install-daemon</code>.
Una volta completato il setup, conviene verificare lo stato prima di aggiungere capacità più potenti.
I controlli essenziali comprendono <code>openclaw –version</code> per verificare che la CLI sia disponibile, <code>openclaw doctor</code> per individuare problemi di configurazione e <code>openclaw gateway status</code> per controllare servizio e connettività del Gateway. <code>openclaw gateway status –json</code> restituisce le informazioni in formato strutturato, mentre <code>openclaw health</code> interroga un Gateway in esecuzione e ne restituisce uno snapshot di salute.
L’obiettivo non è soltanto vedere una chat che risponde.
Devi sapere quale Gateway stai utilizzando, quali canali sono effettivamente collegati, quale modello è configurato e quali strumenti risultano disponibili.
Solo dopo ha senso aumentare il perimetro.
Docker, VPS e installazioni avanzate: quando servono davvero
Un Gateway remoto diventa utile quando vuoi che OpenClaw sia disponibile anche mentre il tuo computer principale è spento.
Una VPS o un host dedicato possono quindi trasformarlo in un servizio persistente.
Ma disponibilità remota ed esposizione pubblica non sono la stessa cosa.
Nelle normali installazioni sull’host il Gateway usa il loopback come default conservativo. Se scegli deliberatamente un bind diverso o un accesso remoto, devi abbinarlo ad autenticazione e controlli di rete adeguati. Le immagini container fanno eccezione perché possono partire con un bind esposto: in quel caso autenticazione e revisione dell’esposizione diventano ancora più importanti.
Il principio pratico è semplice: non rendere pubblico il Gateway solo perché lo hai spostato su un server.
Se il tuo obiettivo è accedere da remoto, utilizza il percorso più stretto che soddisfa realmente quel bisogno.
Come usare OpenClaw senza concedergli subito troppi permessi
La configurazione più interessante non è quella in cui OpenClaw può fare più cose.
È quella in cui può fare esattamente le cose necessarie.
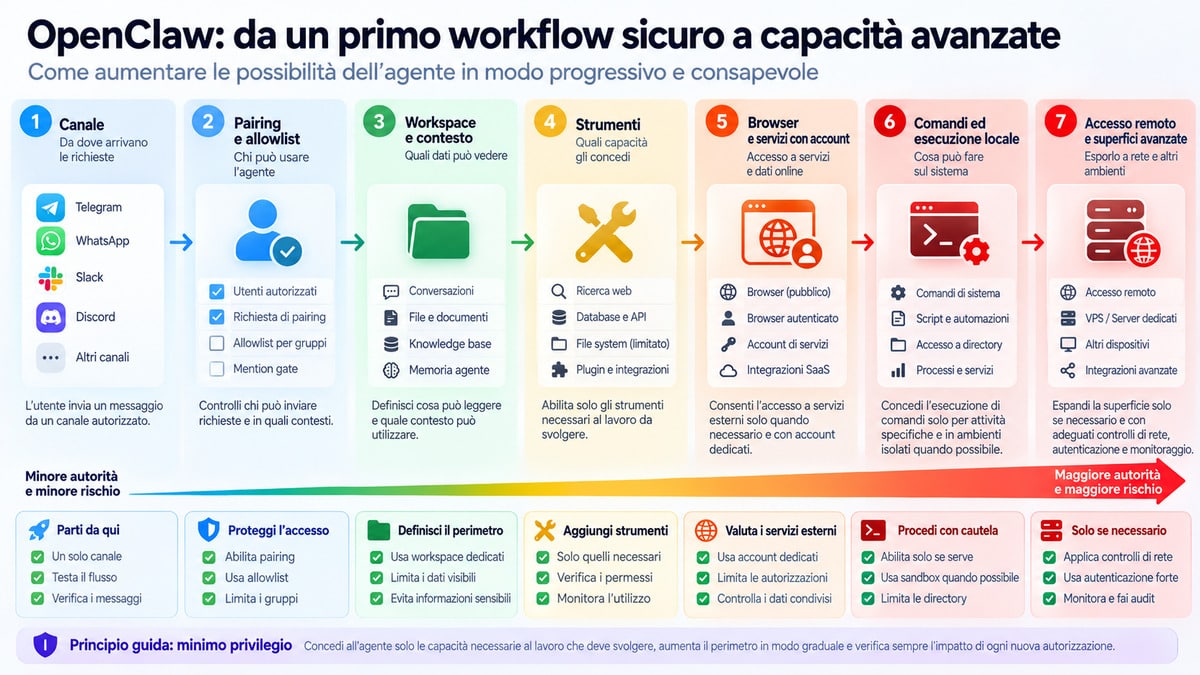
Per questo partirei da un workflow a basso impatto e amplierei il sistema soltanto quando emerge una necessità concreta.
Partire da un primo workflow a basso rischio
Un buon primo caso d’uso dovrebbe essere facile da osservare e semplice da interrompere.
Per esempio, puoi iniziare con un agente che riceve richieste da un solo canale e lavora su informazioni o file non sensibili all’interno di un workspace limitato.
È un contesto molto più facile da comprendere rispetto a un setup che, dal primo giorno, dispone contemporaneamente di shell, browser autenticato, home directory, cron e decine di Plugin.
Il punto non è essere eccessivamente prudenti.
È riuscire ad attribuire con chiarezza ogni capacità a una necessità reale.
Collegare canali, file e strumenti in modo progressivo
Aggiungerei una superficie per volta.
Prima il canale.
Poi il modello.
Poi un insieme ristretto di strumenti.
Successivamente, solo se serve, nuove integrazioni.
Questo permette anche di capire quale componente è responsabile quando qualcosa non funziona.
Se colleghi contemporaneamente cinque provider, tre canali, un browser, più Skill e un server remoto e poi il comportamento non è quello previsto, la diagnosi diventa inutilmente complessa.
La progressione migliore è:
workflow → capacità necessaria → autorizzazione minima → verifica → capacità successiva
Quando abilitare browser, comandi e capacità più sensibili
Browser ed esecuzione di comandi aumentano drasticamente ciò che un agente può fare.
Un browser autenticato può contenere sessioni verso servizi personali o aziendali. L’esecuzione di comandi può raggiungere file, processi e credenziali del sistema.
Sono capacità legittime, ma devono essere abilitate per uno scenario concreto.
Se l’agente deve semplicemente riassumere messaggi, non ha bisogno della shell.
Se deve consultare una pagina pubblica, potrebbe non aver bisogno del browser autenticato.
Se deve modificare soltanto una cartella, non ha motivo di vedere l’intera home directory.
Questa logica del minimo privilegio è molto più importante di qualsiasi prompt che dica all’agente “fai attenzione”.
Quanto costa OpenClaw davvero
OpenClaw è open source con licenza MIT e la Foundation dichiara di non offrire una propria edizione enterprise con licenza differente, un servizio hosted a pagamento o un token.
Dire che OpenClaw è “gratis”, però, può essere fuorviante.
OpenClaw non ha un piano SaaS a pagamento
Non esiste un abbonamento OpenClaw equivalente a quello di un normale software SaaS.
Puoi scaricare ed eseguire il progetto e scegliere autonomamente l’infrastruttura.
Questo è un vantaggio se vuoi controllo e portabilità.
Significa anche che alcune responsabilità che in un SaaS sono assorbite dal provider diventano tue: aggiornamento dell’host, backup, disponibilità del Gateway, segreti, policy e monitoraggio.
Il costo non è quindi soltanto economico.
Esiste anche un costo operativo.
Modelli AI, API e hosting: dove nascono i costi
Se utilizzi un modello cloud, pagherai secondo le condizioni del relativo provider o del piano utilizzato.
Se installi OpenClaw su una VPS, dovrai considerare il costo dell’infrastruttura.
API di ricerca, servizi esterni o altre integrazioni possono aggiungere ulteriori consumi.
Un modello locale elimina alcuni costi API ma li sostituisce almeno in parte con hardware, energia e manutenzione.
Per questo non esiste un unico “prezzo di OpenClaw”.
Il costo reale è:
software OpenClaw + modello + infrastruttura + servizi collegati + tempo di gestione
Per un piccolo setup personale può essere contenuto. Per un sistema sempre attivo con modelli costosi e molte integrazioni può diventare molto diverso.
OpenClaw è sicuro? I rischi che contano davvero
OpenClaw dispone oggi di un modello di sicurezza molto più esplicito rispetto alle prime versioni.
OpenClaw parte da default conservativi, ma con eccezioni documentate per alcune modalità di deployment e alcuni canali. In una normale installazione sull’host il Gateway usa il loopback; nella maggior parte dei canali i mittenti DM sconosciuti ricevono una richiesta di pairing invece di far elaborare direttamente il messaggio; l’accesso ai gruppi è normalmente limitato da allowlist e, spesso, da mention gate.
Questo è un buon punto di partenza.
Non significa che un’installazione rimanga sicura indipendentemente da ciò che aggiungi.
Ogni strumento, Plugin, canale e modifica all’esposizione cambia il perimetro.
Un Gateway, un trust boundary
Questa è probabilmente la regola più importante dell’intero progetto.
La documentazione OpenClaw considera un Gateway come un singolo confine di fiducia. È adatto a un operatore o a un gruppo di persone che si fidano reciprocamente; non è progettato come ambiente multi-tenant ostile in cui utenti non fidati condividono lo stesso agente.
Se due utenti possono inviare richieste allo stesso agente dotato di strumenti, in pratica condividono parte dell’autorità delegata a quell’agente.
Separare le conversazioni non risolve da solo questo problema.
Per livelli di fiducia realmente differenti la soluzione forte è separare i Gateway e, idealmente, anche utenti del sistema operativo o host.
Questo è uno dei casi in cui l’architettura conta più del prompt.
Prompt injection e contenuti non attendibili
Un agente può ricevere istruzioni non soltanto dall’utente.
Una pagina web, un documento, un’email o un’altra fonte esterna possono contenere testo progettato per influenzare il modello.
È il problema della prompt injection.
Il rischio diventa più serio quando l’agente che legge quel contenuto dispone anche di strumenti potenti.
Se un agente può solo riassumere una pagina, l’impatto è limitato.
Se può leggere quella pagina e, contemporaneamente, eseguire comandi, accedere a credenziali o modificare account, lo stesso contenuto ostile acquisisce un potenziale molto diverso.
La protezione non può quindi essere affidata soltanto alle istruzioni nel system prompt.
Servono policy, isolamento e limiti alle capacità.
Skill e Plugin sono software: il rischio della supply chain
ClawHub rende semplice estendere OpenClaw, ma questa comodità crea una superficie supply chain.
Skill e Plugin possono provenire da soggetti differenti e richiedere capacità differenti.
Prima di installarli controllerei almeno provenienza, maintainer, versione, changelog, permessi, credenziali richieste e comportamento previsto.
ClawHub fornisce oggi audit di sicurezza e analisi del rischio sui relativi artifact, con controlli che possono evidenziare problemi come prompt injection, tool misuse, credential exposure, unsafe execution o excessive agency.
Sono informazioni utili, ma non sostituiscono la valutazione.
Un Plugin che deve eseguire comandi non è automaticamente malevolo.
Devi capire perché ha bisogno di quella capacità e se è proporzionata al suo scopo.
Pairing, allowlist e sandbox: ridurre il raggio d’azione
La prima difesa riguarda chi può attivare l’agente.
Pairing e allowlist servono a evitare che qualsiasi mittente possa utilizzare un canale configurato.
La seconda difesa riguarda ciò che l’agente può raggiungere dopo aver ricevuto una richiesta.
OpenClaw può eseguire gli strumenti dentro un backend sandbox per limitare l’accesso a filesystem e processi. Il Gateway, però, rimane sull’host: quando la sandbox è attiva viene spostata soprattutto l’esecuzione degli strumenti. La sandbox è disattivata di default e non rappresenta una barriera di sicurezza perfetta; riduce materialmente il raggio d’impatto, ma non sostituisce un vero isolamento dell’host quando il threat model lo richiede.
È quindi utile ragionare su più livelli:
chi può inviare richieste → quale agente le riceve → quali strumenti vede → dove vengono eseguiti → quali risorse possono raggiungere
Questo modello è molto più robusto di un generico “abilita la sicurezza”.
Come usare <code>openclaw security audit</code>, <code>–deep</code> e <code>–fix</code>
OpenClaw include un audit di sicurezza dedicato.
Il comando di base <code>openclaw security audit</code> rimane su un percorso read-only centrato su configurazione e filesystem e non carica, per il solo audit di routine, i collector runtime di ogni Plugin installato.
<code>openclaw security audit –deep</code> aggiunge verifiche live del Gateway e controlli più costosi, incluse scansioni del codice di Plugin e Skill e i collector di sicurezza messi a disposizione dai Plugin quando applicabili.
<code>openclaw security audit –fix</code> applica invece un insieme intenzionalmente ristretto di correzioni automatiche considerate sicure.
La parola importante è ristretto.
<code>–fix</code> non trasforma una configurazione rischiosa in una configurazione sicura in senso assoluto. Può, per esempio, convertire determinate policy di gruppo aperte in allowlist e correggere alcuni permessi di file e directory, ma non può decidere se per il tuo progetto sia corretto esporre un browser, una credenziale o una capacità particolarmente potente.
Userei l’audit almeno dopo modifiche rilevanti alla configurazione e prima di aumentare l’esposizione di rete.
Per setup sensibili partirei direttamente dal security model ufficiale di OpenClaw invece di affidarmi a configurazioni copiate da una guida generica.
OpenClaw conviene davvero? Quando lo sceglierei e quando no
OpenClaw non è una versione “più potente” di tutti gli altri assistenti AI.
Risolve un problema specifico: darti un piano di orchestrazione self-hosted e multicanale sul quale puoi controllare agenti, provider, strumenti e policy.
È un vantaggio notevole quando questo controllo ti serve.
È complessità inutile quando non ti serve.
Quando ha senso preferire un assistente self-hosted
OpenClaw diventa interessante se vuoi mantenere il Gateway sotto il tuo controllo, scegliere i provider, combinare più canali e costruire workflow che rimangono disponibili nel tempo.
Lo considererei soprattutto quando:
- vuoi un assistente raggiungibile dalle app di messaggistica che utilizzi già;
- vuoi poter scegliere o sostituire il provider del modello;
- devi collegare strumenti e servizi eterogenei;
- accetti di gestire direttamente configurazione, aggiornamenti e sicurezza;
- vuoi costruire progressivamente un’infrastruttura agentica invece di dipendere interamente da un SaaS.
Il vantaggio è la flessibilità.
Il costo è la responsabilità operativa.
Quando un servizio cloud come Manus è più semplice
Se il tuo obiettivo è delegare attività complesse senza occuparti direttamente del Gateway e della relativa infrastruttura, un servizio hosted può richiedere meno lavoro operativo.
Manus AI, per esempio, offre un ambiente agentico gestito dal provider e, nelle versioni correnti, anche ambienti cloud persistenti per determinate attività.
Il trade-off cambia.
Con un servizio di questo tipo rinunci a parte del controllo infrastrutturale ma acquisti semplicità operativa.
Con OpenClaw acquisti controllo e componibilità, ma devi gestire molte più decisioni.
Non è quindi un confronto “quale AI è migliore”.
È un confronto tra chi deve amministrare l’ambiente nel quale l’agente lavora.
Quando Claude Code o un tool specializzato è una scelta migliore
Se il problema è principalmente sviluppo software, un coding agent specializzato può essere più diretto.
Claude Code, per esempio, è costruito attorno al lavoro su codebase, terminale, Skill, hook, subagent e integrazioni dedicate allo sviluppo.
OpenClaw può orchestrare agenti e strumenti, ma non per questo deve sostituire ogni applicazione specialistica.
In alcuni setup i due livelli possono persino convivere.
La cosa importante è non costruire un Gateway complesso per risolvere un task che un singolo strumento dedicato svolge già bene.
Lo stesso vale per MCP Server e Model Context Protocol.
MCP è uno standard aperto che permette alle applicazioni AI di collegarsi in modo strutturato a sistemi esterni che espongono strumenti, risorse e prompt. OpenClaw opera a un livello più ampio di orchestrazione: Gateway, agenti, sessioni, policy e canali. Le due tecnologie possono quindi incontrarsi, ma non sono sinonimi.
Quando è meglio un’automazione deterministica
Sceglierei un’automazione classica quando:
- ogni passaggio può essere definito prima dell’esecuzione;
- gli input hanno struttura prevedibile;
- gli errori devono essere gestiti con regole precise;
- non serve interpretazione linguistica;
- il margine di decisione autonoma del modello aggiunge più rischio che valore.
Un agente è utile quando serve giudizio contestuale.
Non è automaticamente il modo migliore per eseguire qualsiasi processo.
Questa distinzione diventerà sempre più importante man mano che strumenti come OpenClaw renderanno facile concedere agli agenti capacità che fino a poco tempo fa richiedevano integrazioni molto più manuali.
Conclusione
OpenClaw è interessante soprattutto perché sposta una parte importante del controllo dall’applicazione AI al tuo ambiente.
Il Gateway può collegare canali, agenti, modelli e strumenti e permetterti di costruire un assistente persistente che non dipende da una singola interfaccia o da un singolo provider.
Ma il suo vero vantaggio non è “l’AI che può fare tutto”.
È la possibilità di decidere cosa può fare, per chi e dentro quali limiti.
Ed è anche il criterio con cui lo valuterei.
Se vuoi soltanto conversare con un modello o delegare qualche attività senza gestire infrastruttura, una piattaforma hosted è probabilmente più semplice.
Se invece vuoi controllare Gateway, provider, canali, policy e strumenti, OpenClaw offre un livello di componibilità difficile da ottenere con un assistente SaaS tradizionale.
Partirei comunque dal minimo.
Un solo Gateway. Un canale. Un workflow a basso rischio. Pochi strumenti. Pairing e allowlist. Audit di sicurezza.
Poi allargherei il perimetro soltanto quando una nuova capacità risolve un problema concreto.
Con un agente che può agire sul tuo sistema, più autonomia non è automaticamente più valore. Il vantaggio nasce quando l’autorità concessa rimane proporzionata al lavoro che vuoi davvero delegare.