

Una AI hallucination è una risposta generata da un sistema di intelligenza artificiale che appare plausibile e ben formulata, ma contiene informazioni false, inventate o non supportate dalle fonti disponibili. Può essere un nome inesistente, una data sbagliata, uno studio mai pubblicato, una citazione attribuita alla persona sbagliata o una conclusione che il documento fornito non permette di sostenere.
Il problema non è soltanto che l’AI possa sbagliare. Un errore evidente è relativamente facile da intercettare; un’allucinazione è più insidiosa perché può avere la stessa forma linguistica di una risposta corretta. Tono sicuro, dettagli precisi e una spiegazione fluida non sono prove di accuratezza.
Per questo le allucinazioni AI vanno gestite con un metodo diverso dal semplice “fidarsi o non fidarsi” del modello. Serve capire che tipo di errore stai cercando, quali fonti dovrebbe usare la risposta, quanto è alto il rischio se sbaglia e quale verifica è proporzionata al contesto.
AI hallucination: cosa significa e quando si verifica
Nel contesto dei Large Language Model (LLM), il termine hallucination indica generalmente un output fattualmente errato o non supportato che il modello presenta come risposta plausibile.
La definizione operativa più utile è semplice: il modello genera qualcosa che sembra poter essere vero, ma non dispone di una base sufficiente per affermarlo come vero.
OpenAI descrive le allucinazioni dei modelli linguistici come affermazioni plausibili ma false e collega una parte del problema sia alla previsione del token successivo sia agli incentivi delle valutazioni che possono premiare il tentativo di indovinare invece dell’ammissione di incertezza. Questo aiuta a correggere un equivoco frequente: un modello non deve necessariamente “impazzire” o produrre testo senza senso per avere un’allucinazione. Spesso fa l’opposto: produce una risposta estremamente ordinata.
Quando un errore dell’AI è davvero un’allucinazione
Non ogni risposta sbagliata va classificata nello stesso modo. Se chiedi a un modello di calcolare un valore e il calcolo è errato, potresti avere un errore di ragionamento. Se la risposta utilizza informazioni vecchie perché il sistema non dispone di dati aggiornati, il problema può essere la freschezza della conoscenza. Se invece inventa un documento, una fonte o un fatto e lo presenta come reale, siamo nel caso tipico di hallucination.
Una distinzione pratica è questa:
| Fenomeno | Cosa succede | Esempio | Controllo più utile |
|---|---|---|---|
| Allucinazione | viene generata un’informazione falsa o non supportata | una sentenza inesistente citata come reale | verifica della fonte primaria |
| Errore di ragionamento | i dati possono essere corretti, ma la conclusione non segue | calcolo o deduzione errata | ricostruzione dei passaggi |
| Informazione obsoleta | la risposta usa un dato non più valido | prezzo, versione o incarico non aggiornato | fonte corrente |
| Bias | l’output è distorto in modo sistematico | rappresentazione sbilanciata di un gruppo | audit di dati, criteri e risultati |
La distinzione con i bias nell’intelligenza artificiale è particolarmente importante. Un bias è una distorsione sistematica; un’allucinazione riguarda invece l’affidabilità fattuale o il grounding di una specifica risposta. I due problemi possono convivere, ma non richiedono necessariamente la stessa diagnosi o la stessa mitigazione.
Perché i modelli AI hanno allucinazioni
Capire perché si verifica una AI hallucination richiede di distinguere almeno tre livelli: come il modello genera il testo, quali informazioni ha a disposizione e come il sistema viene valutato o istruito quando non è sicuro.
La spiegazione “l’AI inventa perché non capisce davvero” è troppo generica per essere utile. Per ridurre il problema bisogna capire quale componente del processo sta fallendo.
Predizione del token e conoscenza incompleta
Un modello linguistico genera una risposta stimando, passo dopo passo, quali token siano più compatibili con il contesto precedente. Questa capacità produce linguaggio sorprendentemente coerente, ma la coerenza linguistica non contiene automaticamente una verifica fattuale.
Durante il pretraining, il modello apprende regolarità da grandi quantità di testo. Non riceve per ogni frase una semplice etichetta universale “vero/falso” capace di trasformare la generazione in un database perfettamente verificato. Se un fatto è raro, ambiguo, poco rappresentato o confuso con pattern simili, il modello può completare la risposta con una sequenza plausibile ma sbagliata.
Il punto pratico è questo: predire una continuazione credibile e verificare un fatto sono due operazioni diverse.
Perché un modello può indovinare invece di dichiarare l’incertezza
Anche il modo in cui valutiamo i sistemi conta. Una ricerca pubblicata da OpenAI mostra perché un modello può essere incentivato a fornire comunque una risposta quando non conosce il fatto: se una valutazione assegna valore soltanto alla risposta esatta, tentare può essere più conveniente che astenersi.
Per l’utente la conseguenza è importante. Una risposta più lunga, sicura o dettagliata non significa che il modello disponga di più evidenza. In alcuni scenari, la risposta migliore è proprio un’ammissione di incertezza, una richiesta di chiarimento o l’indicazione che serve consultare una fonte esterna.
Per questo, quando progetti un workflow professionale, non chiedere soltanto al modello di “rispondere bene”. Devi anche consentirgli di non rispondere quando mancano elementi sufficienti.
Contesto, grounding, retrieval e strumenti contano quanto il modello
Un LLM usato senza fonti esterne dipende soprattutto dalla propria conoscenza parametrica e da ciò che gli fornisci nel prompt. Un sistema collegato a documenti, database, ricerca web o altri strumenti può invece recuperare informazioni da usare come base della risposta.
Questo processo di grounding può migliorare molto l’affidabilità, ma non sostituisce la verifica. Se il sistema recupera una fonte irrilevante, interpreta male il documento o genera una conclusione che va oltre ciò che la fonte sostiene, l’output può restare errato.
Google DeepMind, nella propria FACTS Benchmark Suite, separa infatti factuality parametrica, ricerca, multimodalità e grounding. È un dettaglio metodologico importante: non esiste un solo tipo di accuratezza e un unico “tasso di allucinazione” valido per qualsiasi task.
Tipi di allucinazioni AI: esempi da riconoscere
Le allucinazioni diventano più facili da intercettare quando smetti di cercare genericamente “errori” e inizi a controllare categorie concrete.
Fatti, nomi, numeri e date inventati
È il caso più intuitivo. Chiedi una biografia, un dato economico o la data di un evento e il modello produce un valore specifico che non corrisponde a una fonte affidabile.
I numeri meritano particolare attenzione perché danno una forte impressione di precisione. Percentuali, statistiche, costi, benchmark e risultati di studi dovrebbero far scattare una domanda automatica: da dove arriva questo dato?
Se il modello non può indicare una fonte verificabile, il numero non diventa attendibile solo perché è plausibile.
Citazioni, studi e URL inesistenti
Le citazioni inventate sono una delle forme più pericolose perché simulano l’evidenza. Il modello può generare un titolo accademico plausibile, attribuirlo a un autore reale e completarlo con rivista, anno o DOI credibili.
Lo stesso può avvenire con sentenze, articoli di legge, documentazione tecnica e URL.
La procedura corretta non è chiedere al modello “sei sicuro che esista?”. Devi aprire la fonte, cercare il documento nel repository ufficiale o nel database pertinente e verificare che sostenga davvero l’affermazione per cui viene citato.
Risposte non supportate dal documento fornito
Un output può essere falso anche senza inventare una fonte esterna. Se fornisci un contratto, un report o una documentazione e chiedi una sintesi, il modello può aggiungere dettagli non presenti nel materiale.
Qui il problema è il grounding: la risposta non è completamente sostenuta dal contesto disponibile.
Un controllo utile consiste nel chiedere al sistema di collegare le affermazioni materiali ai passaggi del documento da cui derivano, per poi verificare direttamente quei passaggi. La citazione automatica aiuta la revisione, ma non deve diventare una nuova forma di fiducia cieca.
Errori logici e tecnici
Nei task tecnici l’output può contenere comandi, funzioni, parametri o librerie inesistenti. In altri casi gli elementi citati esistono, ma vengono combinati in un modo che non funziona.
Qui la verifica richiede più del fact-checking tradizionale: documentazione ufficiale, ambiente di test, controllo della versione e revisione del codice o della procedura.
Una libreria dal nome realistico non va installata solo perché il modello l’ha suggerita. Un comando plausibile non va eseguito su un server di produzione senza averne verificato sintassi ed effetti.
Come riconoscere un’allucinazione AI
Riconoscere una AI hallucination non significa cercare un particolare tono o stile. Non esiste un segnale visivo che permetta di distinguere sempre una risposta corretta da una falsa. La sicurezza del tono, la quantità di dettagli e persino la presenza di citazioni possono essere ingannevoli.
Per questo è più efficace usare trigger di verifica.
I segnali che devono farti controllare una risposta
Alza il livello di controllo quando l’output contiene:
- numeri, percentuali o statistiche molto specifiche;
- nomi di studi, sentenze, norme o documenti;
- citazioni testuali;
- URL, DOI o riferimenti bibliografici;
- prezzi, versioni, funzionalità o informazioni che cambiano nel tempo;
- istruzioni tecniche con effetti su dati, sicurezza o sistemi di produzione;
- affermazioni mediche, legali o finanziarie;
- una risposta molto sicura a una domanda rara, ambigua o poco documentata;
- dettagli che non riesci a ritrovare nella fonte che il modello dichiara di aver usato.
Non significa che queste informazioni siano sicuramente false. Significa che il costo di una verifica è inferiore al costo potenziale dell’errore.
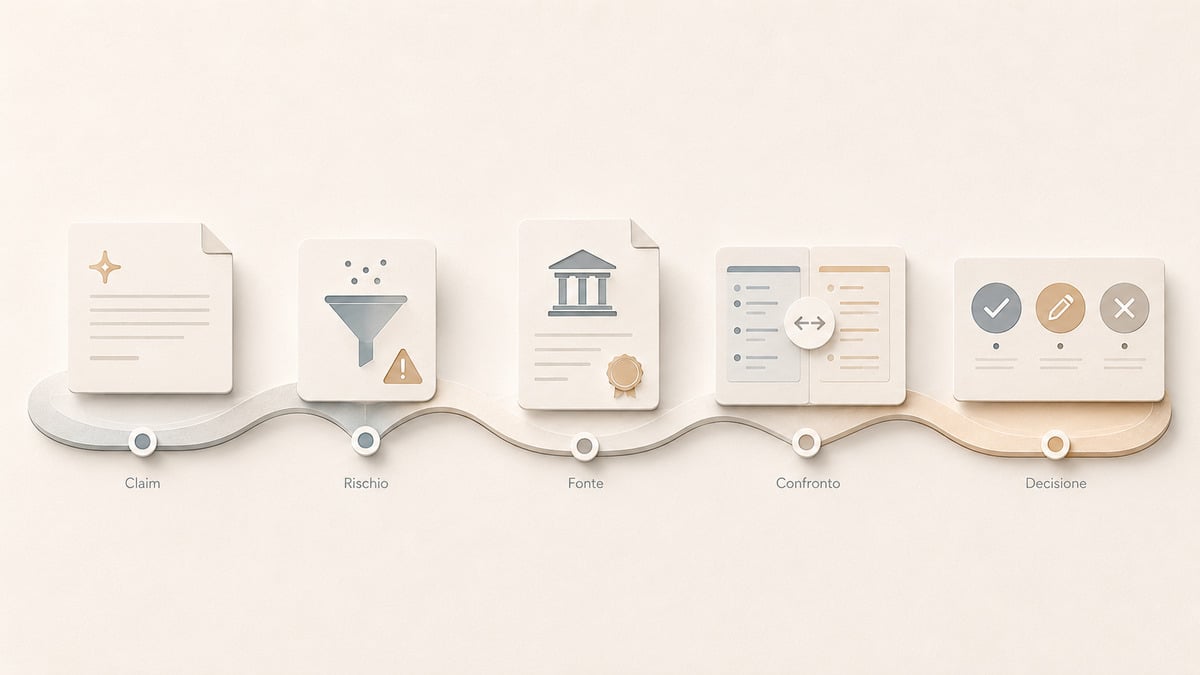
Un metodo di verifica in 5 passaggi
Per contenuti editoriali, ricerca e attività professionali puoi usare questo flusso:
- isola le affermazioni verificabili: separa fatti, numeri, citazioni e conclusioni dal testo puramente esplicativo;
- classifica il rischio: chiediti cosa succede se quella singola informazione è falsa;
- vai alla fonte primaria: documentazione ufficiale, paper originale, normativa, database istituzionale o pagina del fornitore;
- controlla che la fonte sostenga davvero il claim: trovare una pagina pertinente non basta se il passaggio citato dice qualcosa di diverso;
- riduci o elimina ciò che non puoi verificare: quando l’evidenza non c’è, una formulazione più prudente è migliore di una falsa precisione.
Questo metodo è meno spettacolare di un “hallucination detector”, ma nella pratica risolve il problema giusto: verificare le affermazioni materiali, non indovinare se il testo sembra generato dall’AI.
Come fare un test di allucinazione di un LLM
Se vuoi confrontare modelli o configurazioni, non usare una sola domanda difficile e non trasformare l’esito in una classifica universale.
Costruisci invece un piccolo set di test coerente con il tuo utilizzo reale. Se devi usare l’AI su documentazione interna, prepara domande la cui risposta è chiaramente presente oppure chiaramente assente nei documenti. Se devi fare ricerca web, includi domande che richiedono fonti correnti. Se devi estrarre dati, controlla valori, omissioni e attribuzioni.
Per ogni risposta registra almeno:
- corretta e supportata;
- errata;
- non supportata dalla fonte;
- astensione appropriata;
- fonte corretta ma interpretazione sbagliata.
Questo approccio è più utile di un singolo “hallucination rate”, perché ti mostra dove il sistema fallisce. La FACTS Benchmark Suite di Google DeepMind segue una logica simile separando più dimensioni della factuality invece di trattarle come un’unica capacità.
Come ridurre le allucinazioni: cosa funziona e cosa non basta
Non esiste una tecnica che elimini tutte le allucinazioni in ogni situazione. La strategia efficace combina più livelli di controllo e li adatta al rischio.
Prompt e istruzioni aiutano, ma non garantiscono la verità
Un prompt ben costruito può ridurre ambiguità e rendere più verificabile l’output. Puoi chiedere al modello di:
- distinguere fatti da ipotesi;
- dichiarare quando non dispone di informazioni sufficienti;
- non inventare fonti;
- citare solo materiale effettivamente consultato;
- indicare quali affermazioni richiedono verifica esterna.
Sono istruzioni utili, ma restano istruzioni. Non trasformano il modello in una fonte primaria e non garantiscono che obbedisca perfettamente.
Un prompt migliore migliora il processo. Non sostituisce il fact-checking.
Grounding e RAG: vantaggi e limiti
La Retrieval-Augmented Generation, o RAG, permette al sistema di recuperare contenuti esterni e usarli per formulare la risposta. È particolarmente utile quando il modello deve lavorare su knowledge base aziendali, documentazione aggiornata o corpus specifici.
Il vantaggio è evidente: il modello non deve affidarsi soltanto a ciò che ha appreso durante il training.
Il limite è altrettanto importante. Un sistema RAG può recuperare il documento sbagliato, recuperare un frammento insufficiente, perdere informazioni necessarie o generare una conclusione non supportata. Per questo un buon sistema non si valuta soltanto sul fatto che “usa RAG”, ma su retrieval, qualità delle fonti, grounding della risposta e comportamento quando le fonti non bastano.
Ricerca web, tool e fonti verificabili
Dare al modello accesso alla ricerca o ad altri strumenti può essere molto utile per fatti correnti. Ma “ha accesso al web” non equivale a “ha verificato correttamente il web”.
La qualità del risultato dipende da quali fonti vengono selezionate, da come vengono lette e dalla capacità del sistema di sintetizzarle senza introdurre passaggi non supportati.
Per questo, nei workflow editoriali, conviene chiedere non solo la risposta ma anche quali fonti primarie sostengono ciascun claim materiale. Poi quelle fonti vanno controllate.
Permettere al modello di dire “non lo so”
È una delle correzioni più sottovalutate.
Se il sistema è costretto a produrre sempre una risposta, può essere incentivato a colmare i vuoti con una continuazione plausibile. Consentire l’astensione riduce invece la pressione a indovinare.
La ricerca di OpenAI sulle allucinazioni mette proprio in evidenza questo problema: valutazioni basate soltanto sull’accuratezza possono premiare il tentativo anche quando l’incertezza sarebbe la risposta più responsabile.
In un’applicazione reale puoi tradurre il principio in regole operative: “se le fonti non supportano la risposta, dichiaralo”, “se la domanda è ambigua, chiedi chiarimenti”, “se mancano dati, non completare con supposizioni”.
Evaluation, monitoraggio e revisione umana
Per un uso occasionale può bastare verificare le risposte importanti. Per un sistema usato ogni giorno serve invece un processo ripetibile.
Costruisci un set di casi rappresentativi, salva gli errori reali, aggiungi regressioni quando emerge un nuovo failure mode e controlla separatamente factuality, grounding, completezza e capacità di astensione.
La revisione umana resta particolarmente importante quando l’output può influire su salute, diritti, denaro, sicurezza, reputazione o decisioni aziendali. “Human in the loop” non significa che una persona debba leggere tutto manualmente: significa che le decisioni ad alto impatto non vengono delegate a un output non verificato.
Come gestire le allucinazioni nei diversi casi d’uso
Il livello di controllo deve dipendere dal danno potenziale, non dalla semplice presenza dell’AI.
Ricerca e studio
Usa il modello per orientarti, organizzare domande e spiegare concetti, ma tratta nomi, citazioni, date e riferimenti come elementi da verificare.
Se stai preparando una bibliografia, non copiare direttamente le fonti generate: cerca ogni paper nel repository originale e controlla titolo, autori e contenuto.
Content marketing e pubblicazione
Nel lavoro editoriale il rischio tipico non è soltanto un errore clamoroso. Sono più frequenti le “micro-allucinazioni”: numeri senza fonte, feature software non più disponibili, dichiarazioni eccessivamente certe, esempi presentati come casi reali.
Un workflow robusto separa scrittura e verifica. Prima si produce una bozza; poi si identificano i claim materiali e si rivalidano con fonti correnti.
Per la SEO c’è anche un equivoco da eliminare: Google non documenta una specifica “penalizzazione per hallucination”. La documentazione di Google sull’uso dei contenuti generati con AI concentra invece l’attenzione su utilità, originalità, valore per l’utente e rispetto delle spam policy. Pubblicare informazioni false resta un problema editoriale serio, ma non va trasformato in un ranking factor inventato.
Chatbot e assistenti aziendali
Qui è utile progettare il sistema in modo che la risposta sia auditabile.
Quando possibile, conserva le fonti recuperate, mostra i riferimenti pertinenti e definisci cosa deve accadere quando il sistema non trova evidenza sufficiente. Per alcune richieste la risposta corretta può essere “non ho abbastanza informazioni” oppure l’escalation a un operatore.
Un confidence score generato dal sistema può avere una funzione, ma non va interpretato automaticamente come probabilità calibrata che la risposta sia vera. Se quel punteggio deve guidare decisioni, va validato sul caso d’uso reale.
Medicina, diritto e altri contesti ad alto impatto
Più aumenta il danno potenziale, meno ha senso affidarsi a un controllo informale.
Un output AI può aiutare a organizzare informazioni o preparare una prima analisi, ma le decisioni e le affermazioni materiali devono essere verificate da fonti e professionisti appropriati al dominio.
Anche la governance va trattata separatamente dalla factuality tecnica. L’Artificial Intelligence Act introduce un quadro normativo basato sul rischio e obblighi che dipendono dal ruolo e dal tipo di sistema: non esiste una regola universale secondo cui ogni hallucination produce automaticamente la stessa conseguenza giuridica.
Le allucinazioni stanno diminuendo nei modelli più recenti?
In diversi sistemi moderni la factuality è migliorata, ma sarebbe scorretto concludere che il problema sia risolto.
OpenAI segnala tassi di allucinazione più bassi nei modelli più recenti in alcune valutazioni, pur chiarendo che gli errori continuano a verificarsi. Google DeepMind mostra a sua volta miglioramenti sostanziali in diversi benchmark di factuality, ma i risultati cambiano molto in base al tipo di prova.
Questo porta a una regola utile: “modello più nuovo” non significa automaticamente “nessuna allucinazione”, e “modello più grande” non è una misura sufficiente dell’affidabilità.
Perché gli hallucination rate non sono sempre confrontabili
Un numero isolato può sembrare definitivo, ma dipende dal benchmark.
Una valutazione può misurare domande fattuali senza strumenti; un’altra può fornire documenti da usare come contesto; un’altra ancora può permettere la ricerca web. Cambiano anche criteri di scoring, difficoltà, capacità di astensione e formato della risposta.
Perciò evita confronti del tipo “modello A allucina il 5% e modello B il 10%” se i numeri provengono da test differenti.
Prima di usare una percentuale per scegliere un modello, chiedi:
- cosa misura esattamente il benchmark?
- il modello disponeva di ricerca o strumenti?
- l’astensione viene premiata, ignorata o penalizzata?
- il task assomiglia davvero al mio caso d’uso?
- il dato misura accuratezza, errore, grounding o una combinazione?
La factuality è una proprietà da valutare nel contesto del task, non un’etichetta assoluta appesa al nome del modello.
AI hallucination e SEO: cosa cambia davvero per chi pubblica contenuti
Il problema SEO di una AI hallucination non deriva dall’uso dell’AI in sé, ma dalla possibilità di pubblicare un’informazione falsa, non verificata o priva di valore per chi legge.
L’AI può accelerare ricerca, strutturazione e produzione editoriale, ma aumenta anche la necessità di distinguere velocità da affidabilità.
La guida di Google sull’uso dei contenuti generati con AI non stabilisce che un contenuto venga penalizzato semplicemente perché è stato creato con strumenti generativi. Google richiama invece le Search Essentials e le spam policy e segnala come problema l’uso dell’AI per produrre molte pagine senza valore per gli utenti.
Quindi è utile separare tre livelli.
Confermato da Google: l’uso dell’AI non è, da solo, una violazione. La generazione su larga scala senza valore può invece rientrare nelle pratiche abusive.
Conseguenza editoriale: un’allucinazione pubblicata può rendere la pagina inesatta, fuorviante o poco affidabile e può costringerti a correzioni successive.
Non confermato: l’esistenza di una specifica “hallucination penalty” o di un ranking factor dedicato alle allucinazioni AI.
Per un publisher, il controllo migliore non è quindi inseguire un detector. È costruire un processo in cui ogni claim importante ha un proprietario, una fonte e un livello di verifica adeguato.
Domande frequenti sulle allucinazioni AI
Le allucinazioni AI si possono eliminare completamente?
Non in modo affidabile per ogni modello, domanda e contesto. Possono essere ridotte con modelli migliori, grounding, strumenti, istruzioni, valutazioni e revisione, ma il workflow deve continuare a prevedere la possibilità di errore.
RAG elimina le allucinazioni?
No. Il RAG fornisce al modello informazioni recuperate da fonti esterne e può migliorare il grounding, ma la risposta può restare sbagliata se il retrieval è scarso, il contesto è insufficiente o il modello interpreta male le fonti.
Un prompt migliore basta a impedire le allucinazioni?
No. Un prompt può rendere il compito più chiaro, imporre vincoli e incoraggiare l’ammissione di incertezza, ma non garantisce la verità dell’output.
Come verificare una citazione fornita da un LLM?
Cerca il documento nella fonte originale o in un database affidabile, verifica che esista e poi controlla che il passaggio citato sostenga realmente l’affermazione. Non fermarti alla presenza di un titolo o di un URL plausibile.
Conclusione
Le AI hallucination non sono un’anomalia da risolvere con un singolo prompt o un detector magico. Sono un problema di affidabilità che può nascere dalla generazione probabilistica, dalla conoscenza incompleta, dal contesto disponibile, dal retrieval, dal modo in cui il sistema viene valutato e dalla pressione a fornire comunque una risposta.
La difesa più solida è quindi stratificata: fonti verificabili, grounding quando serve, possibilità di dichiarare l’incertezza, evaluation sul proprio caso d’uso e revisione proporzionata al rischio.
Se usi l’AI per attività a basso impatto, un controllo rapido può essere sufficiente. Se la risposta influenza decisioni, denaro, reputazione, salute, diritti o sistemi di produzione, la regola cambia: l’output deve essere trattato come una proposta da verificare, non come una fonte.
È questa la differenza tra usare un modello perché scrive bene e usarlo in modo affidabile.