
WordPress headless significa usare WordPress per gestire contenuti e dati, ma affidare la parte visibile del sito a un frontend separato. Il CMS continua quindi a occuparsi di articoli, pagine, media, tassonomie, utenti e contenuti strutturati; il frontend recupera queste informazioni tramite API e decide come presentarle.
È un’architettura che può avere molto senso quando hai bisogno di un frontend indipendente, vuoi distribuire gli stessi contenuti su più applicazioni o stai costruendo un prodotto digitale che supera i confini di un normale tema WordPress.
Non significa però che un sito diventi automaticamente più veloce, più sicuro o migliore per la SEO.
La separazione tra backend e frontend sposta diverse responsabilità dal CMS al progetto: rendering, caching, metadati SEO, preview, autenticazione, deploy, gestione dei blocchi, aggiornamento dei contenuti e alcune funzionalità che in WordPress tradizionale vengono risolte da temi e plugin.
La domanda utile, quindi, non è “WordPress headless è meglio?”. È un’altra:
il vantaggio ottenuto separando WordPress dal frontend giustifica la complessità aggiuntiva?
In questa guida vediamo come funziona realmente l’architettura, quali scelte devi fare tra REST API e GraphQL, come cambiano SEO e workflow editoriale, cosa succede con un’area riservata o WooCommerce e soprattutto quando scegliere WordPress headless e quando restare su un’architettura tradizionale.
WordPress headless in breve: cosa cambia rispetto a WordPress tradizionale
In un normale sito WordPress, gestione dei contenuti e presentazione fanno parte dello stesso sistema.
Scrivi una pagina nel backend, WordPress recupera i dati necessari e il tema produce l’HTML che arriva al browser. Plugin, template, menu, widget, blocchi e molte altre funzioni lavorano all’interno della stessa architettura.
Con WordPress headless la catena viene separata:
WordPress → API → frontend → utente
WordPress rimane il sistema di gestione dei contenuti. Il tema non è più responsabile del sito pubblico. Una seconda applicazione recupera i dati e costruisce l’esperienza visibile.
La WordPress REST API è già parte del core e permette ad applicazioni esterne di leggere e, quando autorizzate, modificare dati tramite JSON. La documentazione ufficiale la descrive esplicitamente come un’interfaccia utilizzabile anche per costruire frontend separati e applicazioni esterne.
Backend WordPress, API e frontend separato
Il modo più semplice per capire il modello è distinguere tre livelli.
WordPress è il content layer. Qui lavori con editor, media library, utenti, custom post type, tassonomie e metadati. Puoi continuare a usare Gutenberg e strumenti come Advanced Custom Fields per strutturare i dati.
Le API sono il livello di comunicazione. Trasformano i contenuti in informazioni che un’altra applicazione può richiedere.
Il frontend è il presentation layer. Decide URL, layout, navigazione, componenti, rendering, interazioni e parte importante delle prestazioni percepite dall’utente.
Il vantaggio architetturale non sta quindi nel “togliere WordPress”. Sta nel rendere indipendenti gestione del contenuto e presentazione.
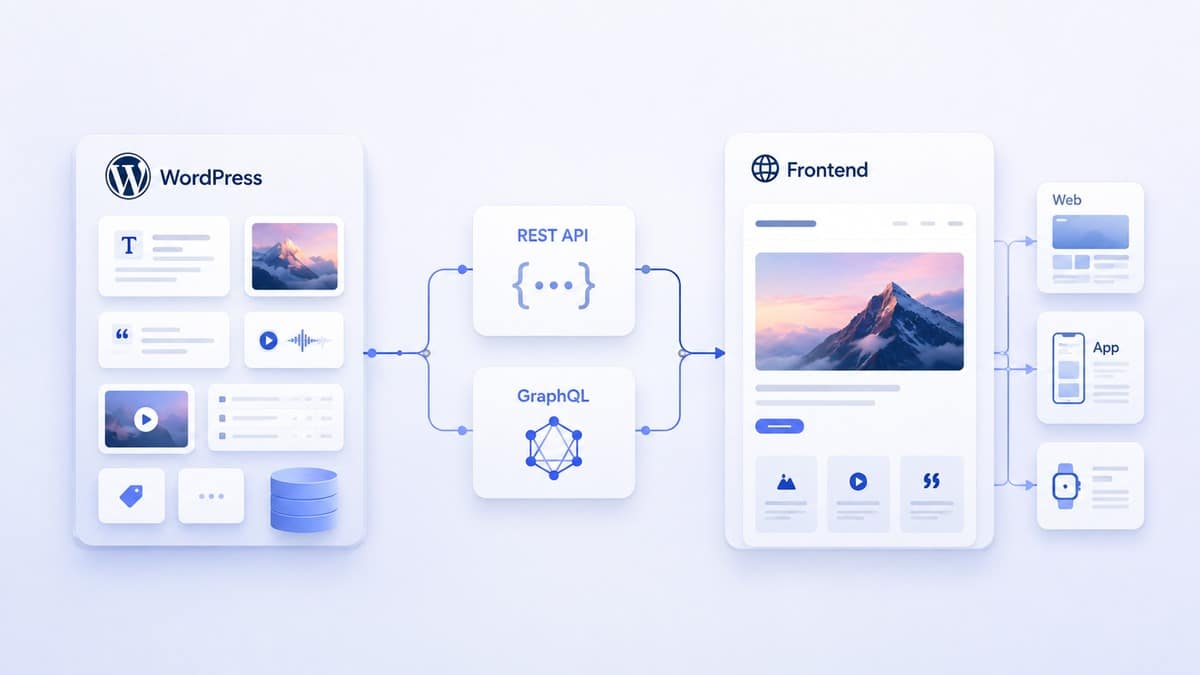
Questa indipendenza è utile, per esempio, quando lo stesso catalogo editoriale deve alimentare un sito, un’app mobile e un’altra interfaccia. Oppure quando il frontend fa parte di un prodotto più ampio e WordPress deve occuparsi soltanto dei contenuti.
Headless, decoupled e WordPress statico non sono la stessa cosa
Qui conviene correggere una confusione abbastanza comune.
Un sito WordPress trasformato in una serie di file HTML statici non è necessariamente una vera implementazione headless.
Se generi una copia statica delle pagine prodotte dal tema WordPress, stai soprattutto cambiando come distribuisci il risultato. Il sistema editoriale e la rappresentazione possono rimanere strettamente legati.
In una vera architettura headless, invece, il frontend è un’applicazione autonoma che consuma i dati di WordPress attraverso un contratto API.
Possiamo quindi avere:
| Modello | Chi gestisce i contenuti | Chi produce il frontend |
|---|---|---|
| WordPress tradizionale | WordPress | tema WordPress |
| WordPress statico | WordPress | HTML generato dal sito WordPress |
| WordPress headless | WordPress | applicazione separata |
| CMS completamente headless | CMS API-first | applicazione separata |
La distinzione conta perché cambiano completamente manutenzione, preview, API, deploy e responsabilità del team.
Se vuoi approfondire il modello più generale, nella guida dedicata abbiamo confrontato CMS tradizionali, decoupled e headless.
Come funziona oggi un’architettura WordPress headless
Una volta separato il frontend, iniziano le decisioni che determinano realmente la qualità del progetto.
La prima riguarda i dati: come vengono esposti da WordPress?
Poi devi decidere come strutturarli, come recuperarli, quando renderizzare le pagine e come sincronizzare pubblicazione e frontend.
REST API o WPGraphQL: quale livello API scegliere
WordPress dispone nativamente della REST API. Post, pagine, media, tassonomie e altri tipi di dato vengono esposti attraverso endpoint organizzati per risorsa. Per dati pubblici molte richieste possono essere eseguite senza autenticazione, mentre contenuti e operazioni protette richiedono autorizzazione.
È spesso la scelta più lineare quando:
- vuoi evitare una dipendenza aggiuntiva;
- il modello dei contenuti è relativamente semplice;
- gli endpoint standard rispondono bene al tuo caso;
- il team conosce già REST;
- devi integrare WordPress con sistemi che lavorano naturalmente con API REST.
L’altra possibilità è WPGraphQL, plugin open source che aggiunge a WordPress uno schema GraphQL estendibile. Il client può descrivere i dati di cui ha bisogno e recuperare relazioni e strutture attraverso query tipizzate.
GraphQL può diventare particolarmente comodo quando una pagina deve combinare molte entità correlate o quando il frontend lavora naturalmente con uno schema GraphQL.
Non significa però che GraphQL sia automaticamente più veloce di REST.
La performance reale dipende da query, caching, struttura dei dati, origine, backend, frontend e modo in cui le richieste vengono eseguite. Inoltre WPGraphQL introduce una componente applicativa ulteriore da mantenere.
La scelta corretta è quindi:
REST quando gli endpoint risolvono bene il problema; GraphQL quando il modello delle query e delle relazioni porta un vantaggio concreto al progetto.
Custom post type, ACF e blocchi Gutenberg nel content model
Quando WordPress diventa una sorgente di dati, la progettazione dei contenuti acquista ancora più peso.
In un tema tradizionale puoi permetterti di legare parte della struttura alla presentazione. In headless devi chiederti quali dati devono continuare a esistere anche se domani cambi completamente frontend.
Supponiamo di avere un portfolio.
Una soluzione fragile potrebbe inserire cliente, anno, tecnologie e URL direttamente nel testo della pagina.
Un modello più solido separa:
Progetto → Cliente → Settore → Anno → Tecnologie → Gallery → URL
Il frontend può quindi utilizzare ogni informazione nel modo appropriato.
È proprio qui che ACF diventa utile: i campi non servono solo a costruire il template WordPress, ma possono diventare parte del contratto dati tra CMS e applicazione.
C’è però una correzione importante rispetto a molta documentazione vecchia: ACF supporta l’integrazione con la WordPress REST API dalla versione 5.11. I Field Group non vengono esposti automaticamente: va abilitata l’opzione Show in REST API per i gruppi interessati.
Non è quindi corretto impostare il progetto sulla vecchia idea che serva necessariamente ACF Pro soltanto per leggere normali campi attraverso REST.
Con Gutenberg la decisione diventa ancora più interessante.
Puoi trattare il contenuto dei blocchi come HTML già renderizzato, oppure costruire una corrispondenza tra blocchi WordPress e componenti del frontend. La seconda soluzione offre maggiore controllo, ma aumenta anche il contratto tecnico da mantenere.
Tool come Faust.js supportano, tra le altre cose, il mapping dei blocchi WordPress verso componenti Next.js.
Il principio da tenere a mente è semplice:
più strutturato è il frontend, più importante diventa progettare WordPress come modello di contenuto e non come semplice editor di pagine.
Frontend e rendering: SSG, SSR e approcci ibridi
“Usare React” non descrive come verrà servita una pagina.
Devi decidere quando viene prodotto l’HTML.
Con lo Static Site Generation (SSG) le pagine possono essere prerenderizzate durante il processo di build. È una soluzione efficace per contenuti relativamente stabili, ma richiede una strategia di rebuild o revalidation quando WordPress cambia.
Con il Server-Side Rendering (SSR) il server produce la risposta in funzione della richiesta. Può essere utile per contenuti dinamici o personalizzati, ma introduce costi e dipendenze runtime diversi.
Gli approcci moderni possono anche essere ibridi: alcune pagine sono statiche, altre dinamiche, altre vengono rigenerate quando cambia il contenuto.
La documentazione di Next.js mantiene il supporto alla generazione statica e ai diversi modelli di caching e revalidation; Astro, invece, documenta direttamente l’uso di WordPress come CMS headless.
Questo spiega perché “headless = sito statico” è una semplificazione troppo forte.
Un progetto headless può essere statico, server-rendered, dinamico oppure una combinazione delle tre cose.
Next.js, Astro e altri framework: la scelta dipende dal progetto
Next.js è una soluzione molto presente nell’ecosistema WordPress headless e dispone anche di strumenti specifici come Faust.js, ma non è l’unica scelta possibile.
Astro documenta ufficialmente l’integrazione con WordPress come headless CMS e può essere interessante soprattutto nei progetti content-driven in cui vuoi controllare con attenzione la quantità di JavaScript inviata al browser.
Team basati su Vue possono orientarsi verso soluzioni del relativo ecosistema; altri progetti possono utilizzare frontend completamente differenti.
Non partire quindi dal framework.
Parti da queste domande:
quanto è dinamico il progetto? Quanto conta l’interattività? Esistono aree autenticate? Quanto frequentemente cambiano i contenuti? Quali competenze ha il team? Come funzioneranno preview e deploy?
Il framework arriva dopo.
Vantaggi e svantaggi reali di WordPress headless
I vantaggi esistono, ma sono conseguenze di precise decisioni architetturali. Non sono caratteristiche automatiche dell’etichetta “headless”.
Performance e scalabilità: cosa può migliorare e cosa non è automatico
Separare WordPress può permetterti di prerenderizzare pagine, usare sistemi di caching indipendenti e distribuire il frontend senza eseguire PHP e query WordPress per ogni normale visualizzazione.
Questo può produrre un’architettura molto efficiente.
Puoi però ottenere anche il risultato opposto: troppo JavaScript, richieste API in cascata, hydration costosa, immagini pesanti, caching sbagliato e dipendenze frontend possono rendere lento anche un sito headless.
La relazione corretta è quindi:
headless → maggiore controllo architetturale → possibilità di ottimizzare
non:
headless → performance garantite.
Lo stesso vale per la scalabilità. Separare i livelli può consentire di dimensionare backend e frontend in modo indipendente, ma introduce anche due sistemi da osservare, proteggere e mantenere.
Libertà frontend e riutilizzo dei contenuti
Questo è probabilmente il vantaggio più strutturale.
WordPress può diventare una sorgente condivisa da:
- sito pubblico;
- app mobile;
- applicazione web;
- portale clienti;
- display o interfacce verticali;
- altri servizi autorizzati.
Non devi necessariamente duplicare lo stesso contenuto per ogni canale.
Il valore cresce quando il contenuto ha una vita indipendente dal sito che lo mostra.
Se invece tutto ciò che pubblichi esiste soltanto per una normale pagina web, il vantaggio può ridursi sensibilmente.
Costi, manutenzione e due pipeline da gestire
Un sito tradizionale concentra molte responsabilità in WordPress.
Con il modello headless ne hai almeno due:
backend WordPressfrontend applicativo
A questi livelli si aggiungono API, repository, build, deployment, variabili di ambiente, caching, monitoraggio e sincronizzazione.
Un errore può quindi nascere:
- in WordPress;
- nell’API;
- nel frontend;
- nel rendering;
- nella cache;
- nel deployment;
- nella comunicazione fra questi componenti.
La separazione è un vantaggio quando permette a team diversi di lavorare meglio. Diventa invece un costo quando un piccolo progetto deve mantenere un’infrastruttura che non risolve nessun problema reale.
Plugin, preview e workflow editoriale: cosa perdi separando il frontend
Uno degli errori più frequenti è valutare headless soltanto dal punto di vista del visitatore.
Devi valutare anche cosa succede all’editor.
In un sito tradizionale, quando installi un plugin che produce output frontend, spesso il plugin conosce già il tema e l’ambiente in cui deve lavorare.
In headless quella relazione può scomparire.
Un plugin può continuare a gestire dati nel backend ma il frontend deve sapere come utilizzarli. Altri plugin dipendono invece completamente dal rendering PHP e richiedono una sostituzione o una nuova integrazione.
Anche la preview merita attenzione. Se la pagina pubblica vive in una seconda applicazione, il normale pulsante Anteprima deve sapere come raggiungerla e come mostrarle contenuti non ancora pubblici.
Faust.js, per esempio, include strumenti specifici per autenticazione, post preview, template hierarchy e Block Editor all’interno di progetti WordPress + Next.js.
Non significa che devi usare Faust. Significa che preview e workflow editoriale devono entrare nel progetto dall’inizio.
Quando WordPress headless conviene e quando WordPress classico resta la scelta migliore
Non esiste una checklist in cui tre risposte “sì” rendono automaticamente headless la scelta corretta.
Serve confrontare il vantaggio ottenuto con il costo dell’architettura.
| Scenario | Headless |
|---|---|
| normale sito aziendale | spesso non necessario |
| blog tradizionale | spesso non necessario |
| contenuti distribuiti su più frontend | molto più interessante |
| web application con area editoriale WordPress | possibile forte fit |
| frontend con requisiti molto custom | da valutare |
| portale content-driven complesso | può avere senso |
| progetto con molte funzioni dipendenti da plugin frontend | attenzione |
| team senza competenze frontend/API | costo operativo elevato |
| proof of concept o sito temporaneo | normalmente sovradimensionato |
Progetti multicanale, applicazioni e frontend complessi
Headless acquista molto valore quando la separazione delle responsabilità è già parte del problema da risolvere.
Immagina una piattaforma in cui WordPress gestisce articoli, guide e knowledge base, mentre l’applicazione principale dispone di una propria autenticazione, dashboard, billing e logica applicativa.
Costringere tutto dentro un tema WordPress può diventare innaturale.
In questo scenario WordPress può fare ciò che sa fare bene — gestione editoriale — lasciando il prodotto al frontend e ai servizi applicativi dedicati.
Lo stesso vale se un unico modello di contenuti deve essere pubblicato su più destinazioni.
Siti aziendali, blog e progetti plugin-heavy dove headless aggiunge solo complessità
Un sito aziendale può essere veloce, accessibile, personalizzato e ben ottimizzato senza diventare headless.
Se il progetto viene risolto correttamente da:
WordPress + tema ben progettato + plugin selezionati + caching + buona infrastruttura
separare il frontend potrebbe non aggiungere nessun vantaggio per l’utente.
Anzi, può significare ricostruire manualmente caratteristiche che WordPress aveva già risolto.
Questo vale ancora di più quando il progetto dipende fortemente da plugin il cui valore è nel frontend: moduli, membership, ricerca, filtri, page builder, widget, aree riservate o altre funzioni devono essere controllate una per una.
Una matrice decisionale basata sul problema, non sulla tecnologia
Prima di scegliere headless, chiediti:
- Quale limite dell’architettura attuale sto cercando di risolvere?
- Quel limite richiede davvero di separare il frontend?
- Quali funzioni WordPress devo ricostruire dopo la separazione?
- Chi manterrà frontend, backend e API?
- Come funzioneranno preview, autenticazione, deploy e rollback?
- Il contenuto deve essere riutilizzato altrove?
- Il valore ottenuto resterà anche tra due o tre anni?
Se non riesci a identificare un vantaggio concreto, non è ancora il momento di scegliere la tecnologia.
SEO per WordPress headless: cosa devi implementare davvero
WordPress headless non compromette automaticamente la SEO e non la migliora automaticamente.
Google può elaborare JavaScript, ma la propria documentazione descrive un processo in cui crawling e rendering sono fasi distinte. Per questo è importante verificare cosa riceve Google, quali risorse può caricare e quale HTML viene prodotto dopo il rendering.
Il punto non è quindi evitare JavaScript a qualsiasi costo. È costruire un frontend che renda disponibili in modo affidabile contenuto, link e segnali SEO.
Crawling, rendering e indicizzazione del frontend JavaScript
Il problema nasce quando contenuti essenziali vengono resi disponibili soltanto dopo interazioni non eseguite dal crawler oppure quando errori JavaScript impediscono di produrre correttamente la pagina.
Google raccomanda di usare strumenti come URL Inspection e Rich Results Test per controllare il rendering e diagnosticare problemi JavaScript.
Per un progetto headless devi quindi verificare almeno:
- HTML effettivamente prodotto;
- link navigabili;
- status HTTP;
- robots directives;
- contenuto principale;
- canonical;
- sitemap;
- errori di rendering;
- risorse bloccate.
Non basta aprire il sito nel browser e vedere che “funziona”.
Title, meta description, canonical e structured data
Quando WordPress non produce il frontend, devi stabilire come i metadati arrivano al frontend.
Potresti mantenere alcuni dati SEO in WordPress e recuperarli tramite API. Oppure gestirli direttamente nel sistema frontend.
Qualunque soluzione tu scelga, il risultato finale deve essere coerente.
Il frontend deve produrre correttamente, quando necessari:
<title>meta descriptioncanonicalrobotshreflang
Open Graph
structured data
sitemap
La parte importante non è quale plugin hai installato nel backend. È quello che il browser e i crawler ricevono dal frontend.
Link interni, sitemap, redirect e status HTTP
Anche navigazione e gestione degli URL passano sotto il controllo del frontend.
Google raccomanda link crawlable con normali elementi <a> e href, in modo che gli URL possano essere scoperti.
Devi inoltre prevedere cosa accade quando:
- cambia lo slug di un contenuto;
- un articolo viene eliminato;
- una pagina deve essere reindirizzata;
- WordPress restituisce un dato inesistente;
- il frontend riceve un errore;
- una pagina deve produrre un vero 404.
Un’applicazione che mostra graficamente “pagina non trovata” ma restituisce sempre HTTP 200 crea un problema differente da un corretto response status.
In headless la SEO tecnica non scompare: si sposta nell’applicazione che produce il sito pubblico.
Core Web Vitals: il framework non garantisce le performance
Next.js, Astro o qualsiasi altro framework non rappresentano una scorciatoia verso buoni Core Web Vitals.
Le prestazioni dipendono dal risultato effettivo:
- JavaScript inviato;
- immagini;
- CSS;
- font;
- risposta del server;
- caching;
- componenti client;
- script di terze parti;
- layout;
- comportamento durante le interazioni.
Per questo scegliere headless “perché sarà più veloce” è una motivazione incompleta.
Sceglilo quando l’architettura ti offre gli strumenti e il controllo necessari per raggiungere un risultato che il progetto richiede.
Area riservata e autenticazione in WordPress headless
Un frontend pubblico può recuperare senza autenticazione i dati che WordPress rende pubblici.
Il problema cambia quando arrivano:
- bozze;
- contenuti privati;
- profili utenti;
- dashboard;
- membership;
- aree clienti;
- operazioni di scrittura.
La REST API applica le stesse logiche di accesso di WordPress: i dati pubblici possono essere esposti anonimamente mentre risorse protette richiedono autenticazione e permessi appropriati.
Contenuti pubblici, privati e permessi API
WordPress supporta diversi meccanismi di autenticazione. Le Application Passwords sono disponibili nel core per l’accesso esterno alla REST API e possono essere utilizzate da applicazioni autorizzate su connessioni HTTPS.
Questo non significa però che una Application Password vada consegnata al JavaScript pubblico nel browser.
Le credenziali e i segreti che permettono operazioni privilegiate devono essere gestiti in un livello sicuro dell’architettura.
Se utilizzi WPGraphQL esistono ulteriori meccanismi e integrazioni per autenticazione, inclusi Application Passwords e soluzioni basate su JWT.
La scelta deve derivare dal modello di sicurezza e dal tipo di utente, non dalla comodità del primo tutorial trovato online.
Login, sessioni e caching cambiano il progetto
Un’area riservata non è semplicemente “un’altra chiamata API”.
Devi definire:
identità → autenticazione → autorizzazione → sessione → dati accessibili → caching
Se una pagina contiene informazioni specifiche dell’utente, non puoi trattarla nello stesso modo di un articolo pubblico statico distribuito tramite cache condivisa.
Devi inoltre stabilire:
- dove avviene il login;
- chi emette e valida la sessione;
- quali endpoint sono protetti;
- quali dati possono essere memorizzati in cache;
- quando una sessione scade;
- come vengono gestiti logout e revoca;
- cosa può fare ogni ruolo.
Questo è uno dei motivi per cui area riservata headless merita una valutazione architetturale separata prima di iniziare lo sviluppo.
WordPress headless con WooCommerce
WooCommerce può essere utilizzato in un’architettura headless, ma qui bisogna distinguere almeno due API.
La normale WooCommerce REST API è pensata per interagire con risorse del negozio mediante credenziali e permessi: prodotti, ordini e altre informazioni gestionali. La documentazione ufficiale prevede infatti la generazione di API key con privilegi associati a un utente.
La Store API ha uno scopo differente: offre endpoint pubblici rivolti alle funzionalità customer-facing di prodotti, carrello e checkout. WooCommerce la descrive esplicitamente come API adatta anche a storefront custom e headless.
WooCommerce REST API e Store API hanno ruoli differenti
Una separazione utile è questa:
| API | Uso principale |
|---|---|
| WooCommerce REST API | gestione e integrazione dei dati del negozio |
| WooCommerce Store API | esperienza pubblica di catalogo, cart e checkout |
Questo cambia un’affermazione frequente nelle vecchie guide: non è corretto dire semplicemente che “WooCommerce headless richiede di ricostruire tutto da zero”.
Esistono API specifiche per costruire parti importanti dello storefront.
Rimane però da costruire il frontend che le usa.
Prodotti, carrello e checkout in un frontend separato
Un ecommerce reale comprende molto più di una pagina prodotto.
Devi considerare:
- catalogo;
- varianti;
- disponibilità;
- ricerca e filtri;
- prezzi;
- promozioni;
- carrello;
- checkout;
- pagamenti;
- account cliente;
- spedizioni;
- tasse;
- estensioni WooCommerce;
- analytics;
- consent management.
Ogni plugin WooCommerce che modifica l’esperienza di acquisto deve essere verificato per capire se espone dati o API utilizzabili dal nuovo frontend.
La Store API riduce parte del lavoro infrastrutturale, ma non elimina la progettazione dello storefront.
Quando un ecommerce headless giustifica davvero la complessità
Un WooCommerce headless può avere senso quando il frontend commerciale è un vero prodotto digitale, quando deve essere condiviso con altri servizi o quando esistono requisiti di interazione e architettura che il normale frontend WooCommerce non soddisfa bene.
Ha molto meno senso se l’obiettivo è soltanto:
“voglio un ecommerce più veloce”.
Prima di separare l’architettura conviene capire se il problema può essere risolto intervenendo su hosting, query, tema, plugin, caching, immagini o JavaScript.
La soluzione deve seguire la causa.
Come iniziare un progetto WordPress headless senza rifare tutto alla cieca
Il modo più sicuro per iniziare non è scegliere subito Next.js, GraphQL o un provider di hosting.
È costruire un piccolo modello del problema.
Parti dal problema e dal content model
Prendi una sezione reale del progetto.
Per esempio un archivio “Progetti” con:
- titolo;
- cliente;
- settore;
- data;
- tecnologie;
- immagine;
- descrizione.
Definisci quali dati appartengono a WordPress e quali al frontend.
Poi stabilisci come vengono esposti.
Se la normale REST API restituisce già tutto ciò che serve, non hai bisogno di aggiungere GraphQL soltanto perché il progetto è headless.
Costruisci un proof of concept prima della migrazione
Un proof of concept dovrebbe dimostrare una catena completa:
contenuto WordPress → API → frontend → pubblicazione
Non limitarti a recuperare cinque titoli da /wp-json/.
Verifica anche:
- pagina singola;
- archivio;
- immagini;
- link interni;
- custom field;
- preview;
- aggiornamento del contenuto;
- metadata SEO;
- errore 404;
- cache;
- deploy.
Se il progetto prevede utenti o ecommerce, aggiungi un piccolo flusso autenticato o commerciale.
Il proof of concept serve proprio a far emergere la complessità che una demo perfetta tende a nascondere.
API, frontend, preview, deploy e monitoraggio: cosa validare
Prima di migrare l’intero sito dovresti sapere rispondere a queste domande:
Come viene pubblicato un contenuto?
Quanto tempo passa prima che l’aggiornamento sia visibile?
Come funziona l’anteprima di una bozza?
Cosa succede se WordPress non risponde?
Cosa succede se fallisce il deploy?
Come vengono gestiti redirect e 404?
Come vengono protetti dati e credenziali?
Come controlli che Google riceva la pagina corretta?
Quali funzioni dei plugin attuali devono essere ricostruite?
Quando queste risposte sono chiare, puoi stimare il valore dell’architettura.
Prima, stai ancora valutando una tecnologia.
Conclusione
WordPress headless ha senso quando la separazione tra gestione dei contenuti e frontend risolve un problema reale.
È particolarmente interessante se WordPress deve alimentare più esperienze, se il frontend appartiene a un’applicazione più ampia o se sviluppo ed editoria hanno bisogno di evolvere in modo indipendente.
Non sceglierei invece headless per un normale sito WordPress soltanto con la promessa di ottenere automaticamente più velocità, sicurezza o SEO. Un’architettura separata aggiunge API, rendering, deploy, preview, autenticazione e manutenzione: quel costo deve produrre un vantaggio proporzionato.
La decisione migliore parte quindi dal progetto.
Se il tema e l’ecosistema WordPress risolvono bene il problema, restare su WordPress tradizionale può essere la scelta tecnicamente più razionale.
Se invece il frontend è diventato un prodotto autonomo e WordPress deve concentrarsi sulla gestione strutturata dei contenuti, allora headless può diventare un’architettura molto efficace.
Prima di migrare, costruirei comunque un proof of concept limitato e verificherei l’intero flusso: contenuti, API, rendering, SEO, preview, deploy e, quando servono, autenticazione e WooCommerce.
Se devi valutare la fattibilità tecnica di un progetto esistente, un’analisi preventiva evita spesso di trasformare una buona idea architetturale in complessità inutile. In questi casi puoi partire anche da una consulenza e assistenza WordPress focalizzata sul progetto e sulle integrazioni realmente necessarie.