
Lo schema markup è un modo per descrivere in forma strutturata le informazioni presenti in una pagina web. In pratica, aggiunge al codice dati che aiutano i motori di ricerca a riconoscere più chiaramente entità e proprietà: per esempio che una pagina parla di un articolo, un prodotto, un’azienda, un evento o un’attività locale.
La parte che genera più confusione è un’altra: Schema.org, dati strutturati e rich result non sono la stessa cosa.
Puoi avere markup Schema.org tecnicamente valido senza ottenere alcun risultato arricchito su Google. Puoi utilizzare un tipo presente nel vocabolario Schema.org che Google Search non usa per una propria feature. E puoi implementare correttamente un markup supportato da Google senza avere la garanzia che quella particolare presentazione venga mostrata in SERP.
Capire queste differenze è molto più utile che aggiungere Schema a ogni pagina sperando in un vantaggio SEO automatico.
Schema markup, dati strutturati e Schema.org: qual è la differenza
I tre termini vengono spesso usati come sinonimi, ma indicano livelli differenti dello stesso sistema.
I dati strutturati sono informazioni organizzate secondo un formato comprensibile anche dalle macchine. Lo schema markup è il codice con cui quelle informazioni vengono inserite o associate alla pagina. Schema.org è invece uno dei vocabolari utilizzati per definire quali entità e proprietà possiamo descrivere.
Google spiega che utilizza i dati strutturati trovati sul web per comprendere meglio il contenuto delle pagine e, quando esiste una funzionalità compatibile, per alimentare determinate presentazioni avanzate nei risultati di ricerca. La documentazione introduttiva di Google sui dati strutturati è il riferimento corretto per capire questa relazione.
Dati strutturati, Schema.org e markup sono tre cose diverse
Un esempio rende la distinzione più semplice.
Immagina una pagina che presenta un evento.
Il contenuto visibile può dire:
- nome dell’evento;
- data;
- luogo;
- organizzatore;
- prezzo del biglietto.
Schema.org mette a disposizione tipi e proprietà con cui queste informazioni possono essere descritte in maniera standardizzata.
Il markup è il codice che associa quei valori alle relative proprietà.
Google può poi utilizzare alcune di queste informazioni se la pagina e il markup rispettano i requisiti previsti per una feature Search supportata.
La sequenza corretta è quindi:
contenuto reale → dati da descrivere → vocabolario → markup → eventuale utilizzo da parte del motore di ricerca
Non:
aggiungo Schema → Google deve mostrarmi un rich result
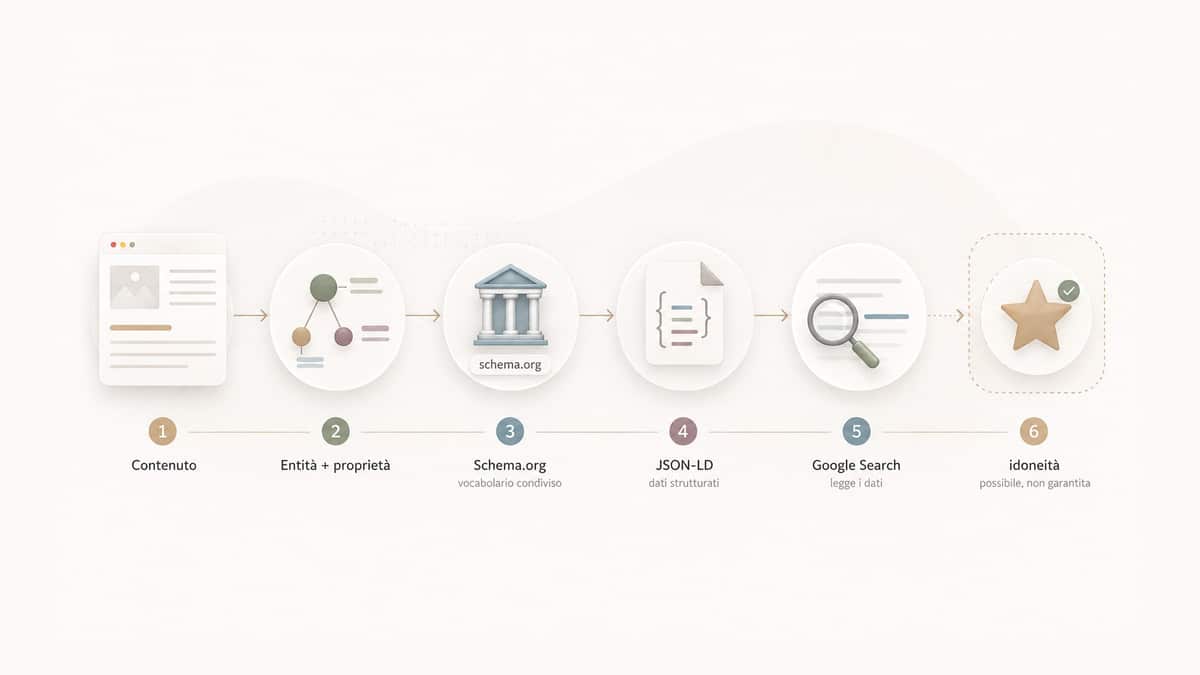
Questa distinzione evita molti degli errori che si incontrano nelle implementazioni reali.
Entità, proprietà e relazioni: cosa comunica davvero il markup
Schema.org lavora soprattutto attraverso entità e proprietà.
Un’entità può essere, per esempio:
- una
Organization; - una
Person; - un
Article; - un
Product; - un
Event; - un
LocalBusiness.
Le proprietà descrivono quell’entità. Un’organizzazione può avere un nome, un URL, un logo, un indirizzo o altri attributi pertinenti. Un articolo può avere un titolo, un autore e una data di pubblicazione.
Il vero valore del markup emerge quando queste informazioni sono coerenti con ciò che la pagina comunica realmente.
Non serve inserire ogni proprietà disponibile. Google raccomanda, in generale, di privilegiare dati completi e accurati rispetto a grandi quantità di proprietà incomplete o imprecise.
A cosa serve lo schema markup nella SEO
Lo schema markup fa parte degli strumenti che puoi utilizzare nella SEO tecnica, ma il suo ruolo va delimitato correttamente.
Serve principalmente a rappresentare informazioni già presenti nella pagina in una forma strutturata e, per le tipologie supportate, può rendere il contenuto idoneo a determinate funzionalità avanzate di Google Search.
Questo non lo trasforma in una scorciatoia per il ranking.
Comprensione del contenuto e idoneità ai rich results
Google mantiene una galleria delle funzionalità Search supportate dai dati strutturati.
È una distinzione fondamentale: Schema.org contiene molti più tipi e proprietà di quelli utilizzati da Google per produrre rich result.
Aggiungere un tipo perché esiste su Schema.org non significa quindi che Google mostrerà qualcosa di diverso nella SERP.
Quando una feature è supportata, il markup corretto è una delle condizioni che possono rendere la pagina idonea. Restano però valide le linee guida specifiche del tipo, le policy generali, la qualità del contenuto e la decisione finale dei sistemi di Google.
Le linee guida generali sui dati strutturati precisano infatti che una pagina può essere marcata correttamente e superare il Rich Results Test senza che il rich result venga necessariamente mostrato.
Lo schema markup migliora il ranking?
Non userei lo schema markup come una leva autonoma per “salire di posizione”.
Google documenta i dati strutturati soprattutto come strumento di comprensione e di eligibility per determinate search feature, non come meccanismo che assegna automaticamente posizioni migliori.
C’è anche un’indicazione utile nelle linee guida: una eventuale azione manuale specifica per structured data può rimuovere l’idoneità ai rich result senza modificare direttamente il ranking della pagina nella normale ricerca web.
Questo non significa che lo schema sia inutile.
Significa che dobbiamo separare:
ranking → capacità di una pagina di competere nei risultati
da:
search appearance → modi in cui quella pagina può essere presentata
Una pagina con un risultato più informativo può ottenere un comportamento degli utenti diverso, ma non bisogna trasformare questa possibilità nella formula semplicistica “Schema aumenta il CTR e quindi Google ti premia”.
Title, contenuto, intento, concorrenza, posizione, layout della SERP e feature mostrate cambiano continuamente il contesto. Lo schema markup è solo una componente del sistema.
Per la stessa ragione, va integrato in una strategia di SEO on-page e tecnica coerente, non trattato come un intervento isolato.
Schema markup, AI Overviews e AI Mode: cosa serve davvero
Con l’arrivo della ricerca generativa è comparsa anche l’idea di uno “schema per GEO” o di markup speciali necessari per essere utilizzati dalle AI.
Per Google questo modello non è corretto.
Nella guida ufficiale all’ottimizzazione per le funzionalità generative, Google chiarisce che i dati strutturati non sono richiesti per la ricerca generativa e non esiste uno Schema.org speciale da aggiungere per AI Overviews o AI Mode.
Continuano ad avere senso per le normali funzioni per cui sono stati progettati, comprese le search feature che supportano structured data.
Quindi non aggiungerei una FAQ, un Organization, un Article o qualsiasi altro tipo con l’obiettivo di “farmi citare dall’AI”.
Il criterio resta:
descrivere correttamente il contenuto e l’entità presenti nella pagina.
Se vuoi approfondire il rapporto fra questi elementi e i motori di risposta, nella guida all’Answer Engine Optimization abbiamo separato crawling, contenuto, Schema.org, llms.txt e ricerca generativa proprio per evitare questo tipo di sovrapposizione.
JSON-LD, Microdata e RDFa: quale formato scegliere
Schema.org definisce il vocabolario. Serve poi un formato con cui inserirlo nella pagina.
Per Google Search i tre formati supportati sono:
- JSON-LD;
- Microdata;
- RDFa.
Google raccomanda JSON-LD quando possibile.
Perché Google raccomanda generalmente JSON-LD
JSON-LD significa JavaScript Object Notation for Linked Data.
È importante correggere qui un errore piuttosto diffuso: la sigla non significa “Linked Objects”.
Il vantaggio pratico del JSON-LD è che permette di mantenere il blocco di dati strutturati separato dalla maggior parte del markup HTML visibile.
Invece di aggiungere attributi a molti singoli elementi della pagina, puoi inserire una struttura dedicata:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Titolo dell'articolo"
}
</script>
Questo tende a rendere l’implementazione più leggibile e, soprattutto, più facile da mantenere quando la struttura della pagina cambia.
Non significa però che JSON-LD sia automaticamente corretto. Puoi avere JSON perfettamente valido che contiene informazioni sbagliate, incomplete o incoerenti con il contenuto visibile.
Quando Microdata o RDFa possono ancora avere senso
Microdata inserisce le informazioni strutturate direttamente negli elementi HTML tramite attributi specifici.
Un esempio estremamente semplificato potrebbe essere:
<article itemscope itemtype="https://schema.org/Article">
  <h1 itemprop="headline">Titolo dell'articolo</h1>
</article>
RDFa segue una logica simile, usando attributi che permettono di associare dati semantici agli elementi del documento.
Entrambi continuano a essere formati supportati da Google. Se un progetto esistente li utilizza correttamente, non c’è una regola che imponga di migrare tutto a JSON-LD soltanto per moda.
Per un’implementazione nuova, però, JSON-LD è normalmente la soluzione che sceglierei: riduce l’accoppiamento fra presentazione HTML e livello dei dati strutturati e rende più semplice gestire strutture complesse.
Quali tipi di schema markup usare oggi
La domanda più utile non è “quali tipi di Schema esistono?”, perché il vocabolario Schema.org è molto ampio.
La domanda è:
quale entità sto realmente descrivendo e che cosa può fare Google con quel markup?
Alcuni casi frequenti sono questi:
| Scenario | Schema da valutare | Possibile utilizzo in Google |
|---|---|---|
| Articolo o post | Article, BlogPosting | Informazioni articolo e relative feature |
| Gerarchia di navigazione | BreadcrumbList | Breadcrumb nei risultati |
| Azienda | Organization | Informazioni sull’organizzazione |
| Attività con presenza locale | sottotipo appropriato di LocalBusiness | Funzionalità locali supportate |
| Ecommerce | Product, ProductGroup, Offer | Product snippet e merchant listing |
| Evento | Event | Esperienze relative agli eventi |
| Offerta di lavoro | JobPosting | Esperienza di ricerca lavoro |
| Software/app | SoftwareApplication | Feature compatibili quando applicabili |
Questa non è una lista universale da applicare a tutte le pagine.
Un blog non deve aggiungere Product perché il tipo esiste. Una web agency non deve marcare ogni pagina come LocalBusiness. Una recensione non deve inventare AggregateRating se i dati richiesti non esistono realmente sulla pagina.
Schema.org non coincide con i rich result supportati da Google
Questa distinzione va mantenuta anche quando Google ritira una feature.
Un tipo può continuare a esistere nel vocabolario Schema.org oppure essere utilizzato da altri sistemi anche se Google decide di non produrre più uno specifico risultato avanzato.
Allo stesso modo, Google può aggiornare requisiti, proprietà supportate e feature senza che il vocabolario Schema.org cambi nello stesso momento.
Per questo, quando l’obiettivo è Google Search, controlla sempre prima la Search Gallery corrente e poi la documentazione specifica del tipo.
I markup più utili per blog, aziende, attività locali ed ecommerce
Per un normale blog partirei da ciò che descrive realmente il sito:
ArticleoBlogPostingper gli articoli quando appropriato;BreadcrumbListper rappresentare il percorso della pagina;OrganizationoPersona livello coerente con l’identità del sito.
Per una attività locale va valutato il sottotipo di LocalBusiness più preciso che corrisponde all’attività reale.
Per un ecommerce il lavoro diventa più articolato. Product, offerte, varianti, disponibilità, prezzo, spedizione e resi possono avere relazioni concrete con le esperienze Shopping. In questo caso l’accuratezza diventa particolarmente importante perché i dati possono cambiare frequentemente.
Il criterio non cambia:
prima il contenuto e il dato reale, poi il markup.
FAQ, HowTo e altri tipi ritirati: cosa è cambiato
Questa è una delle aree in cui molte guide online sono ormai datate.
Google non mostra più il FAQ rich result in Search dal 7 maggio 2026 e ha rimosso successivamente la relativa documentazione dalle feature supportate.
Anche il HowTo rich result era già stato ritirato e la relativa documentazione eliminata.
Questo non significa che sul tuo sito non possano più esistere FAQ o tutorial passo-passo. Una sezione di domande frequenti può essere molto utile per gli utenti, così come una buona procedura resta utile anche senza un risultato speciale in SERP.
Significa semplicemente che non bisogna aggiungerle per ottenere una feature Google che non esiste più.
Google ha inoltre continuato a semplificare il supporto ai dati strutturati nel tempo. Nel 2025 ha annunciato il ritiro da Search di feature come Course Info, Claim Review, Estimated Salary, Learning Video, Special Announcement e Vehicle Listing, con successive rimozioni dai relativi strumenti e report.
Il changelog corrente di Google Search è quindi una fonte da controllare quando lavori su un’implementazione che dipende da una specifica feature.
Come aggiungere schema markup a un sito web
Esistono tre approcci principali:
- generazione automatica da CMS o plugin;
- JSON-LD inserito direttamente nel template o nel codice;
- generazione dinamica attraverso JavaScript.
La scelta dipende da come sono gestiti i dati del sito.
Implementazione manuale con JSON-LD
Il metodo manuale offre molto controllo.
Puoi generare il JSON-LD lato server o inserirlo direttamente nel template della pagina, usando valori provenienti dal contenuto o dal database.
È una buona soluzione quando:
- il sito è custom;
- devi modellare relazioni specifiche;
- il CMS non produce il tipo necessario;
- hai bisogno di controllare direttamente ogni proprietà.
Lo svantaggio è evidente: la responsabilità dell’aggiornamento è tua.
Se una pagina prodotto cambia prezzo e il valore nel JSON-LD rimane vecchio, hai creato una discrepanza.
La stessa cosa può accadere con date, disponibilità, autore, nome dell’azienda o qualsiasi informazione dinamica.
Schema markup su WordPress: plugin SEO o codice personalizzato
Su WordPress non è normalmente necessario scrivere ogni blocco a mano.
Plugin SEO come Rank Math possono generare parte dello schema markup utilizzando i dati del sito e del contenuto.
Questa strada riduce il lavoro manuale, ma introduce una responsabilità diversa: devi sapere cosa sta già generando il tuo stack.
Tema, plugin SEO, WooCommerce, plugin per recensioni, plugin per eventi e codice custom possono tutti produrre dati strutturati.
Prima di aggiungere un secondo sistema controlla quindi il sorgente o il DOM della pagina.
Il problema non è semplicemente “avere due blocchi JSON-LD”. Più nodi possono essere perfettamente legittimi.
Il problema nasce quando due sistemi descrivono la stessa entità in maniera incompatibile: autori differenti, organizzazioni duplicate con dati divergenti, prodotti con prezzi diversi, breadcrumb concorrenti o proprietà obsolete.
JavaScript e Google Tag Manager: quando hanno senso
Google può elaborare structured data generato tramite JavaScript e documenta anche l’utilizzo di Google Tag Manager e custom JavaScript.
La guida ufficiale alla generazione di dati strutturati con JavaScript mostra entrambi gli approcci.
GTM può essere utile quando non hai accesso semplice ai template oppure devi creare un livello dinamico controllato.
Non lo trasformerei però nella scelta predefinita.
Se il dato è già disponibile nel CMS o sul server, generarlo vicino alla sua fonte tende a ridurre il rischio di divergenza.
Google segnala inoltre una cautela specifica per il markup Product generato dinamicamente quando contiene informazioni che cambiano rapidamente, come disponibilità e prezzo.
In questi casi la domanda non è solo “Google riesce a leggere il JavaScript?”, ma:
il markup rimarrà sempre sincronizzato con il dato commerciale reale?
Esempio pratico di schema markup in JSON-LD
Vediamo un esempio volutamente semplice riferito a un articolo.
Non è un template universale da copiare alla cieca: serve a capire la struttura.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Schema markup: cos'è e come funziona",
  "description": "Guida ai dati strutturati e allo schema markup.",
  "author": {
    "@type": "Person",
    "name": "Nome Autore"
  },
  "publisher": {
    "@type": "Organization",
    "name": "Nome Azienda",
    "url": "https://www.example.com/"
  },
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": "https://www.example.com/schema-markup/"
  }
}
</script>
Come leggere @context, @type e le proprietà
@context indica il vocabolario utilizzato.
"@context": "https://schema.org"
@type identifica il tipo di entità che stiamo descrivendo:
"@type": "BlogPosting"
headline descrive il titolo.
author non contiene una semplice stringa: contiene un’altra entità, in questo caso Person.
Lo stesso accade con publisher, descritto come Organization.
mainEntityOfPage collega invece il post alla pagina principale che lo rappresenta.
Questo esempio mostra un punto importante: Schema non è soltanto una raccolta di etichette. Può costruire un grafo di entità collegate fra loro.
Perché i dati devono corrispondere al contenuto visibile
Il codice non deve raccontare una versione differente della pagina.
Se il markup dice che l’autore è Mario Rossi ma la pagina indica Laura Bianchi, hai una contraddizione.
Se dichiari un prezzo non mostrato all’utente, il dato non rappresenta correttamente il contenuto visibile.
Se aggiungi una recensione aggregata che il lettore non può trovare sulla pagina, il problema non è soltanto tecnico: hai descritto qualcosa che la pagina non sostiene.
Google include proprio questa coerenza fra le proprie linee guida di qualità.
Per questo il controllo migliore non parte dal validator.
Parte da una domanda più semplice:
il JSON-LD sta descrivendo fedelmente ciò che questa pagina è e ciò che mostra?
Come testare e validare i dati strutturati
Una delle debolezze più frequenti delle implementazioni Schema è usare lo strumento sbagliato per la domanda che si vuole risolvere.
Il Rich Results Test e lo Schema Markup Validator non fanno lo stesso lavoro.
Rich Results Test: verifica delle feature Google
Il Rich Results Test serve a verificare quali rich result supportati da Google possono essere generati a partire dai dati strutturati della pagina.
È quindi il primo strumento da utilizzare quando il tuo obiettivo è una specifica feature Google Search.
Puoi testare:
- un URL pubblico;
- un blocco di codice.
Il test può segnalare errori e proprietà mancanti in relazione alle feature che Google supporta.
Ma un risultato valido non significa:
“questo rich result verrà sicuramente mostrato”.
Significa:
“questa implementazione supera i controlli applicabili del test e può essere idonea alla feature”.
La decisione di mostrarla resta separata.
Schema Markup Validator: controllo del markup Schema.org
Il Schema Markup Validator svolge un lavoro diverso.
Serve per verificare genericamente il markup basato su Schema.org, anche quando il tipo non corrisponde a una search feature supportata da Google.
È quindi molto utile quando vuoi capire se la struttura Schema.org è corretta senza limitarti al sottoinsieme delle funzionalità Google.
Google stesso distingue i due strumenti nella propria pagina dedicata al test dei dati strutturati.
In pratica:
| Domanda | Strumento |
|---|---|
| Questo markup è riconosciuto per una rich feature Google? | Rich Results Test |
| Questo markup Schema.org è strutturalmente valido? | Schema Markup Validator |
| Google ha trovato problemi dopo la pubblicazione? | Search Console |
Search Console: cosa controllare dopo la pubblicazione
Il test prima della pubblicazione non chiude il lavoro.
Dopo che Google ha ricrawlato e reindicizzato le pagine, controlla Search Console.
Per le feature supportate e rilevate sul sito possono comparire specifici report sullo stato dei rich result. Non tutti i tipi di structured data hanno necessariamente un report dedicato.
Il punto è importante perché un template può essere corretto oggi e rompersi in seguito:
- modifica del tema;
- aggiornamento plugin;
- cambio di un custom field;
- migrazione;
- modifica dei dati prodotto;
- nuova versione del markup.
Il controllo deve quindi diventare:
implementazione → test → pubblicazione → crawling → monitoraggio → eventuale correzione
non:
test verde → lavoro finito
Gli errori più comuni con lo schema markup
La maggior parte degli errori non nasce dalla sintassi JSON.
Nasce dal modello mentale sbagliato con cui Schema viene utilizzato.
Usare un tipo Schema.org aspettandosi automaticamente un rich result
È probabilmente l’errore più comune.
Il vocabolario Schema.org e le search feature Google sono due insiemi differenti.
Prima di implementare un markup chiediti quindi:
- rappresenta realmente la pagina?
- il tipo esiste nel vocabolario corrente?
- se voglio una feature Google, Google la supporta ancora?
- sto rispettando i requisiti specifici della feature?
Questo passaggio avrebbe evitato, per esempio, molte implementazioni FAQ e HowTo mantenute soltanto per una presentazione SERP che Google ha poi ritirato.
Markup non coerente con il contenuto della pagina
Google chiede che i dati strutturati rappresentino il contenuto principale e che le informazioni descritte siano accessibili anche agli utenti quando previsto dalle linee guida.
Un markup tecnicamente valido può quindi essere comunque inappropriato.
Non usare Schema per dichiarare:
- recensioni inesistenti;
- prezzi differenti da quelli reali;
- servizi non presenti;
- autori sbagliati;
- eventi scaduti descritti come correnti;
- proprietà riempite solo per eliminare un warning.
Completezza non significa compilare tutto.
Significa fornire i dati necessari e pertinenti in maniera accurata.
Plugin, tema e codice custom che generano dati in conflitto
Su WordPress questo problema merita sempre un controllo.
Un plugin SEO può creare Article, BreadcrumbList e Organization.
WooCommerce può aggiungere dati sul prodotto.
Un plugin recensioni può aggiungere rating.
Il tema o un vecchio snippet custom potrebbe generare altro markup.
Il risultato non è automaticamente sbagliato, perché una pagina può contenere più entità correlate.
Devi però controllare che il grafo finale sia coerente.
Quando effettuo un audit, quindi, non guarderei soltanto la configurazione del plugin. Guarderei l’output finale della pagina, perché è quello che il crawler riceve.
Se il problema riguarda più template, entità duplicate o implementazioni tecniche che non riesci a ricostruire, è anche uno dei controlli che ha senso includere in un SEO audit più ampio.
Markup valido ma nessun rich result: perché può succedere
Questo è un caso normale, non necessariamente un errore.
Google specifica chiaramente che la presenza di structured data valido non garantisce la visualizzazione di un rich result.
Può decidere che per quella ricerca sia preferibile un normale risultato testuale.
Possono inoltre incidere:
- feature non più supportata;
- mancato rispetto delle linee guida;
- dati non rappresentativi del contenuto;
- contenuto nascosto o incoerente;
- problemi di crawling o indicizzazione;
- requisiti specifici del tipo non soddisfatti;
- contesto della query e del risultato.
Per questo non bisogna modificare compulsivamente un JSON-LD perfettamente valido solo perché una particolare SERP non mostra il risultato avanzato desiderato.
Prima identifica la causa.
Checklist per implementare schema markup correttamente
Prima di pubblicare o modificare i dati strutturati di una pagina controllerei questi punti:
- identifica l’entità principale della pagina;
- verifica se esiste un tipo Schema.org appropriato;
- se l’obiettivo riguarda Google Search, controlla che la relativa feature sia ancora supportata;
- usa JSON-LD quando è la soluzione più adatta al progetto, senza convertire automaticamente implementazioni Microdata o RDFa già valide;
- inserisci soltanto informazioni reali e coerenti con il contenuto;
- evita proprietà compilate solo per “fare punteggio”;
- su WordPress verifica cosa stanno già generando tema, plugin SEO e altri plugin;
- controlla eventuali entità duplicate o contraddittorie;
- testa le feature Google con Rich Results Test;
- usa Schema Markup Validator quando ti serve una validazione Schema.org più generale;
- dopo la pubblicazione verifica URL e report pertinenti in Search Console;
- ricontrolla le implementazioni quando Google ritira o modifica una feature;
- per prodotti, eventi e altri dati dinamici verifica che markup e contenuto rimangano sincronizzati;
- non aggiungere Schema speciale per AI Overviews, AI Mode o presunte formule GEO;
- considera il markup parte dell’architettura tecnica del contenuto, non una scorciatoia SEO.
Conclusione
Lo schema markup è utile quando descrive meglio ciò che la pagina è già in grado di dimostrare.
Il modello corretto non è “aggiungo Schema e ottengo più ranking”, né “aggiungo un tipo e Google mi assegna un rich result”.
È più semplice:
contenuto corretto → entità corretta → proprietà corrette → markup coerente → validazione → monitoraggio
Schema.org offre il vocabolario. JSON-LD, Microdata e RDFa offrono i formati. Google decide quali parti utilizzare nelle proprie search feature e può modificarle nel tempo.
Per un nuovo progetto partirei normalmente da JSON-LD e dai dati già gestiti dal CMS. Su WordPress sfrutterei il plugin SEO quando produce un output corretto, intervenendo manualmente solo quando serve maggiore controllo. Su ecommerce, attività locali o sistemi con molte entità dinamiche darei invece molta più importanza alla sincronizzazione dei dati.
E prima di implementare un tipo perché “funziona bene nella SEO”, farei sempre l’ultima verifica: Google lo supporta ancora per l’obiettivo che sto cercando di raggiungere?
È questa distinzione, più del numero di proprietà inserite, che evita gran parte degli errori con i dati strutturati.