
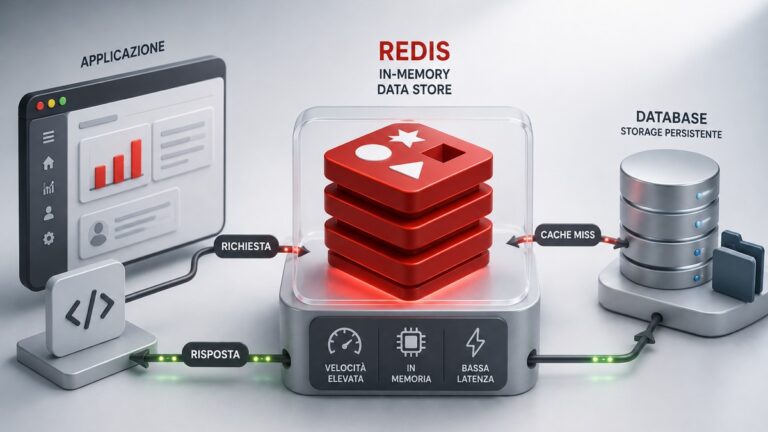
Redis è un database in-memory basato su strutture dati, utilizzato soprattutto quando un’applicazione deve leggere o aggiornare informazioni con latenze molto basse. Può funzionare come cache, session store, coda, contatore, archivio per dati temporanei, database primario per alcuni workload e, nelle versioni attuali, anche come base per ricerca e applicazioni che lavorano con vettori.
La velocità, però, è solo una parte della storia. Per usarlo bene bisogna capire quali dati conviene tenere in memoria, per quanto tempo, cosa succede quando la RAM si riempie e quale livello di persistenza serve realmente.
È proprio qui che molte implementazioni diventano fragili: installare questo data store non rende automaticamente più veloce un’applicazione, così come aggiungerlo a WordPress non significa aver risolto qualsiasi problema di performance.
In questa guida vediamo come funziona Redis, come utilizzarlo come cache, quali sono le differenze rispetto a Valkey e Memcached e cosa è cambiato con Redis 8.
Redis: cos’è e a cosa serve
Redis nasce attorno a un’idea abbastanza semplice: mantenere i dati su cui devi lavorare rapidamente vicino all’applicazione e principalmente nella memoria RAM, evitando di dover interrogare continuamente una sorgente dati più lenta.
Viene spesso descritto come un database key-value, ma la definizione è riduttiva. Una chiave non deve necessariamente contenere una semplice stringa: sono disponibili diverse strutture dati che possono modellare problemi applicativi differenti.
Puoi usare, per esempio:
- stringhe per token, contatori e valori semplici;
- hash per rappresentare oggetti;
- liste e sorted set per code, classifiche e sequenze;
- set per collezioni di valori univoci;
- stream per flussi di eventi;
- JSON per dati strutturati;
- strutture probabilistiche e funzionalità di ricerca per workload più evoluti.
La differenza rispetto a una cache minimale è quindi importante: non conserva soltanto blob temporanei, ma permette anche di manipolare direttamente strutture dati attraverso comandi atomici.
Redis non è soltanto una cache
Il caching resta uno dei casi d’uso più comuni perché si presta perfettamente al funzionamento in memoria.
Immagina un’applicazione che deve recuperare per ogni richiesta la stessa scheda prodotto dal database. Senza cache, cento richieste possono trasformarsi in cento interrogazioni. Con Redis puoi salvare temporaneamente il risultato e servirlo direttamente fino alla sua scadenza o invalidazione.
Può essere impiegato anche per:
- sessioni utente;
- rate limiting;
- code e job asincroni;
- contatori;
- leaderboard;
- Pub/Sub;
- flussi di eventi tramite Streams;
- locking distribuito;
- dati temporanei;
- ricerca full-text e vector search;
- sistemi di raccomandazione e retrieval.
In questi scenari non sostituisce necessariamente il database principale. Spesso lavora accanto a MySQL, PostgreSQL o un altro data store, risolvendo la parte del problema in cui latenza e frequenza di accesso contano maggiormente.
I casi d’uso in cui Redis ha davvero senso
Questo tipo di data store tende a essere particolarmente utile quando hai dati consultati molto più spesso di quanto vengano modificati oppure operazioni ripetitive che puoi evitare di calcolare ogni volta.
Pensa a un catalogo ecommerce. Prezzo e disponibilità devono restare corretti, ma molte informazioni della scheda prodotto possono essere richieste migliaia di volte tra due aggiornamenti. Una cache ben progettata evita di ricostruire continuamente gli stessi risultati.
Un altro scenario classico sono le sessioni. Se più server applicativi devono conoscere lo stato dello stesso utente, un archivio condiviso in memoria permette di evitare che la sessione rimanga legata a una singola macchina.
È interessante anche quando la struttura dati stessa semplifica il problema. Un sorted set, ad esempio, permette di costruire classifiche senza dover riprodurre continuamente la stessa logica sul database relazionale.
Quando Redis non è la scelta giusta
La sua presenza nell’architettura aggiunge anche un nuovo componente da configurare, proteggere, monitorare e aggiornare.
Se un’applicazione ha poco traffico e il database risponde già velocemente, introdurre un ulteriore data store può aumentare la complessità senza produrre un beneficio percepibile. Lo stesso vale quando il dataset è troppo grande rispetto alla RAM disponibile oppure quando il workload richiede soprattutto interrogazioni relazionali complesse.
C’è poi una distinzione essenziale: una cache dovrebbe contenere dati ricostruibili. Se la perdita di una chiave provoca la perdita definitiva dell’unica copia di un’informazione critica, non stai più usando il sistema semplicemente come cache e devi progettare persistenza, replica e backup con criteri diversi.
La domanda corretta, quindi, non è “Redis è veloce?”, ma “quale parte del mio workload trae realmente beneficio dal funzionamento in memoria?”.
Come funziona Redis
Per capire perché raggiunge latenze molto basse bisogna separare tre aspetti: dove conserva i dati, come li rappresenta e come elabora i comandi.
Il primo è il più intuitivo. Il working dataset viene mantenuto principalmente in RAM, molto più adatta del normale storage persistente per accessi frequenti e casuali.
Questo non significa che “non usa il disco”. Come vedremo, può creare snapshot RDB e file AOF per rendere persistenti i dati. La RAM rimane però il luogo centrale in cui avvengono le normali operazioni sul dataset.
Perché lavorare in memoria riduce la latenza
Se un’applicazione deve leggere continuamente le stesse informazioni da un database, parte del tempo viene consumata dal database stesso: parsing della richiesta, individuazione dei record, eventuali join, lettura degli indici, trasferimento dei risultati.
Una cache in memoria modifica il percorso:
applicazione → cache → dato già disponibile
invece di:
applicazione → database → elaborazione → dato
Quando il valore non è presente in cache, il database continua naturalmente a essere necessario. La convenienza deriva quindi dal rapporto tra cache hit e cache miss, dal costo della query evitata e dalla frequenza con cui il dato viene richiesto.
Per questo una cache con una hit ratio molto bassa può persino essere controproducente: aggiungi un controllo intermedio per finire comunque sul database originale.
Event loop, esecuzione dei comandi e I/O thread: cosa significa davvero
Una delle semplificazioni più comuni consiste nel dire che “Redis è single-threaded”. La frase aiuta a capire una parte della sua architettura, ma nelle versioni moderne va qualificata.
L’esecuzione di molti comandi continua a beneficiare di un modello in cui le operazioni vengono elaborate in modo fortemente serializzato, evitando buona parte della sincronizzazione che sarebbe necessaria se più thread modificassero contemporaneamente gli stessi dati.
Il software utilizza però anche thread per attività specifiche e le versioni recenti hanno esteso il lavoro degli I/O thread. Redis 8 espone persino statistiche dedicate agli I/O thread.
Questo ha una conseguenza pratica: non devi interpretare “single-threaded” come “usa sempre un solo core per qualsiasi attività”, né pensare che un comando costoso diventi innocuo solo perché il resto del sistema è veloce.
Un comando che richiede molto lavoro può comunque aumentare la latenza delle altre operazioni. Per questo in produzione conviene monitorare comandi lenti, dimensione delle strutture dati e comportamento sotto il carico reale.
Stringhe, hash, liste, set, stream, JSON e vector set
La vera differenza rispetto a un semplice key-value cache sta nelle operazioni disponibili sui valori.
Con un hash puoi aggiornare un singolo campo senza riscrivere necessariamente un intero oggetto. Con uno sorted set puoi aggiungere elementi con un punteggio e recuperarli già ordinati. Con uno stream puoi modellare un log append-only e usare consumer group per distribuire l’elaborazione degli eventi.
La scelta del tipo di dato incide quindi su due fronti: logica applicativa e uso della memoria.
Non conviene serializzare qualsiasi cosa in una grande stringa JSON solo perché è possibile. Se devi incrementare un contatore, filtrare un insieme o gestire una classifica, una struttura nativa può rendere il codice più semplice e ridurre il lavoro necessario.
Redis come cache: come funziona nella pratica
Usarlo come cache significa decidere almeno quattro cose:
- chi inserisce il dato;
- quando il dato scade;
- come viene invalidato quando cambia l’origine;
- cosa succede quando l’istanza esaurisce la memoria disponibile.
È questa logica, più del comando GET o SET, a determinare se una cache funzionerà bene.
Cache-aside, write-through e write-behind: cosa gestisce Redis e cosa deve gestire l’applicazione
Nel cache-aside l’applicazione prova prima a recuperare il valore dalla cache.
Se lo trova, lo utilizza. Se non lo trova, interroga il database, ottiene il dato e lo inserisce in memoria per le richieste successive.
Il flusso è quindi:
richiesta → Redis → cache miss → database → Redis → risposta
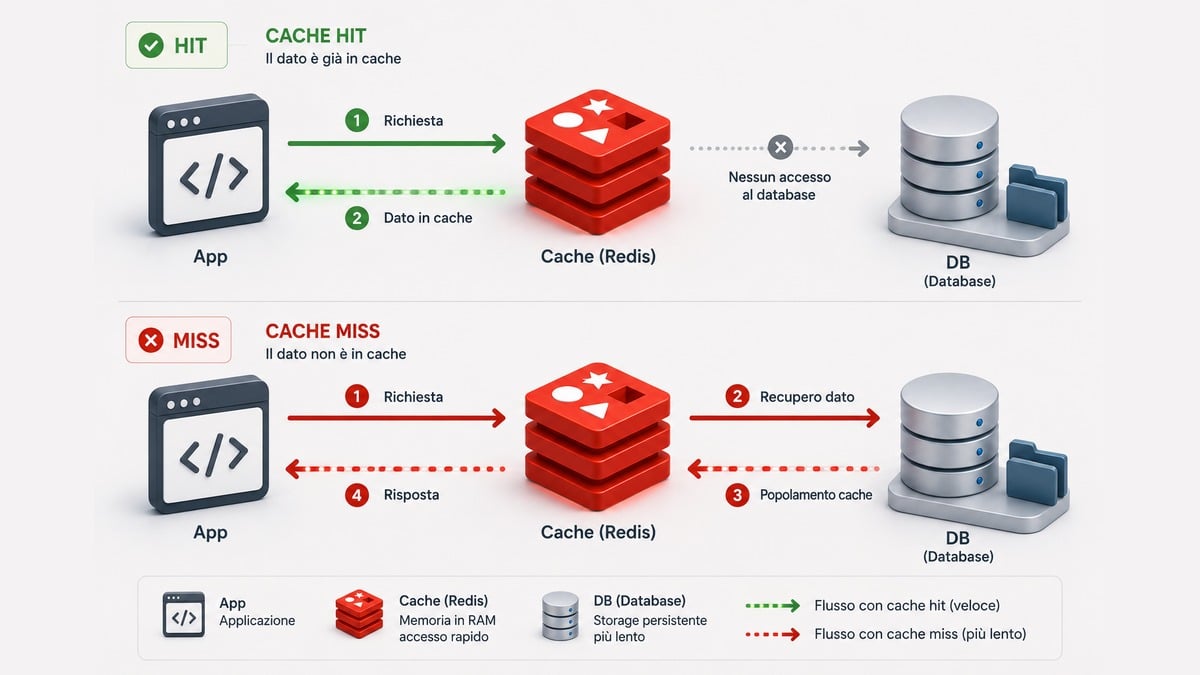
È un pattern semplice ed efficace, ma lascia all’applicazione la responsabilità di stabilire quando invalidare la copia cached.
Nel write-through una scrittura aggiorna il sistema persistente e la cache seguendo una logica coordinata, mentre nel write-behind alcune scritture possono essere accumulate o propagate alla sorgente persistente in un secondo momento.
Qui c’è una distinzione importante rispetto a molte descrizioni superficiali: questi sono pattern architetturali, non modalità magiche applicate automaticamente a qualsiasi database collegato. Il comportamento va implementato nell’applicazione, nel client o in un componente dell’infrastruttura.
TTL, invalidazione ed eviction policy
TTL ed eviction risolvono problemi diversi.
Il TTL, Time To Live, stabilisce per quanto tempo una determinata chiave può esistere. Se imposti una scadenza di cinque minuti, la chiave diventerà non disponibile una volta terminato il periodo.
L’eviction, invece, entra in gioco quando configuri un limite di memoria e il sistema deve decidere cosa rimuovere per poter continuare a lavorare.
La documentazione sulle eviction policy di Redis permette di scegliere strategie differenti, tra cui varianti LRU, LFU e policy che considerano soltanto le chiavi con scadenza.
La scelta dipende dal workload.
Se quasi tutto ciò che salvi è una cache ricostruibile, allkeys-lru o allkeys-lfu possono avere senso in determinati scenari. Se nella stessa istanza conservi dati con importanza differente, la decisione richiede maggiore cautela.
Con noeviction, quando viene superato maxmemory, il sistema non elimina automaticamente le chiavi per creare spazio: i comandi che richiedono ulteriore memoria possono fallire.
Il punto è che TTL non sostituisce una strategia di memoria e l’eviction non sostituisce una corretta invalidazione.
Client-side caching e CLIENT TRACKING
È disponibile anche il server-assisted client-side caching.
In questo modello alcune informazioni lette dal server vengono conservate direttamente nella memoria dell’applicazione. Una richiesta successiva può quindi essere soddisfatta senza attraversare nuovamente la rete.
Il problema evidente è l’invalidazione: se il valore cambia sul server, come può il client sapere che la copia locale non è più valida?
CLIENT TRACKING consente al server di inviare notifiche di invalidazione ai client interessati.
Questo livello aggiuntivo ha senso soprattutto quando le letture sono molto frequenti e il costo di rete verso il server è diventato significativo. Non è invece una configurazione da attivare per principio: introduce un altro livello di stato e richiede un client che gestisca correttamente il protocollo di invalidazione.
Cache stampede e dati obsoleti: gli errori da prevenire
Un problema tipico appare quando una chiave molto richiesta scade improvvisamente.
Immagina che mille richieste arrivino quasi insieme dopo l’expiration di un dato costoso. Se tutte rilevano il cache miss e interrogano contemporaneamente il database, la cache non sta più proteggendo l’origine proprio nel momento in cui servirebbe maggiormente.
È il fenomeno conosciuto come cache stampede.
Le contromisure dipendono dall’applicazione: locking, rigenerazione anticipata, TTL con una componente casuale, stale-while-revalidate applicativo o altre forme di coordinamento.
Anche TTL identici su migliaia di chiavi possono creare picchi concentrati. Aggiungere un piccolo jitter alle scadenze può distribuire le rigenerazioni nel tempo.
L’altro rischio è l’opposto: mantenere dati troppo a lungo. Un TTL elevato aumenta le hit, ma rende più probabile servire una copia non aggiornata.
La configurazione corretta nasce quindi dal compromesso fra costo della rigenerazione e tolleranza alla staleness.
Come iniziare a usare Redis
Per capire il funzionamento non serve partire da un cluster. Puoi creare un’istanza locale, collegarti con redis-cli e provare direttamente alcuni comandi.
La documentazione ufficiale di installazione copre Docker, Linux e macOS; su Windows la strada documentata per Redis Open Source passa da Docker.
Installazione con Docker, Linux o macOS
Con Docker puoi avviare rapidamente un’istanza locale:
docker run -d --name redis -p 6379:6379 redis
Per aprire la CLI all’interno del container:
docker exec -it redis redis-cli
A questo punto puoi verificare la connessione:
PING
La risposta attesa è:
PONG
Questa configurazione va bene per imparare e fare test locali. Non va copiata direttamente in produzione senza affrontare autenticazione, persistenza, rete, backup e limiti di memoria.
Collegarsi con redis-cli
redis-cli è il client da riga di comando ufficiale e permette di interrogare il server direttamente.
In una configurazione locale standard il comando può essere semplicemente:
redis-cli
Su server remoti dovrai invece specificare host, porta e sistema di autenticazione appropriato. In produzione evita di inserire password in script, cron o cronologia della shell senza considerare come verranno protette.
Una volta collegato puoi usare INFO, MEMORY, SLOWLOG e altri comandi anche per analizzare il comportamento dell’istanza.
SET, GET, EXPIRE e HSET: un esempio minimo ma reale
Per salvare una stringa:
SET prodotto:42:nome "Tastiera meccanica"
Per recuperarla:
GET prodotto:42:nome
Per assegnare una scadenza di 300 secondi:
EXPIRE prodotto:42:nome 300
Puoi controllare il tempo residuo:
TTL prodotto:42:nome
Se invece vuoi rappresentare più proprietà dello stesso oggetto, un hash è spesso più naturale:
HSET prodotto:42 nome "Tastiera meccanica" prezzo "89.90" stock "12"
e recuperare un singolo campo:
HGET prodotto:42 prezzo
L’esempio serve soprattutto a mostrare il modello mentale: scegli una chiave riconoscibile e poi una struttura dati coerente con le operazioni che dovrai eseguire.
Redis e WordPress: object cache, page cache e Memcached non sono la stessa cosa
Nel contesto WordPress la parola “cache” crea spesso confusione perché indica livelli differenti dell’architettura.
Una page cache conserva l’HTML già generato e può evitare buona parte dell’esecuzione di WordPress quando un visitatore richiede una pagina compatibile con la cache.
La persistent object cache conserva invece oggetti e risultati riutilizzabili tra richieste differenti, riducendo il numero di operazioni costose che WordPress deve ripetere.
La documentazione di WordPress distingue esplicitamente questi livelli e indica Redis e Memcached tra i possibili backend per una cache oggetti persistente. Se vuoi approfondire il quadro complessivo, nella nostra guida al caching in WordPress trovi le differenze tra i diversi livelli.
Una object cache basata su Redis non sostituisce quindi automaticamente la page cache, né la cache del browser o PHP OPcache.
Quando Redis può alleggerire il lavoro del database WordPress
Questo backend diventa interessante soprattutto nei siti in cui WordPress deve continuare a eseguire PHP e interrogare il database per molte richieste.
È il caso, per esempio, di:
- ecommerce WooCommerce;
- utenti autenticati;
- aree riservate;
- WordPress Multisite;
- cataloghi consistenti;
- siti con molte query ripetitive;
- applicazioni costruite sopra WordPress;
- backend con elaborazioni dinamiche frequenti.
Con una persistent object cache correttamente integrata, informazioni già recuperate possono restare disponibili tra richieste diverse invece di essere ricalcolate continuamente.
Se il problema principale è un backend lento, conviene comunque misurare prima di intervenire. Nella guida su come ridurre il tempo di risposta del server WordPress trovi un approccio più ampio alla diagnosi del TTFB.
Quando una object cache persistente non produce un vantaggio reale
Un blog prevalentemente statico, con page cache efficace e poche operazioni dinamiche, può ottenere un miglioramento marginale dall’introduzione di una cache oggetti persistente.
Lo stesso vale quando il vero collo di bottiglia è altrove: PHP sottodimensionato, plugin inefficienti, chiamate API esterne lente, query non indicizzate o hosting insufficiente.
Una object cache non rende più rapido un codice che continua a eseguire lavoro inutile. Può ridurre parte delle interrogazioni e dei calcoli ripetuti, ma va misurata nel contesto dell’intero stack.
Per questo, prima di aggiungere nuovi componenti, è utile verificare le altre leve descritte nella guida per velocizzare un sito WordPress.
Persistenza Redis: RDB, AOF e modalità ibrida
Il working dataset risiede principalmente in memoria, ma può essere scritto su storage persistente.
Le opzioni fondamentali sono:
- RDB;
- AOF;
- RDB e AOF insieme;
- nessuna persistenza.
Non esiste una scelta universale. Dipende da quanto dato puoi perdere, dalla velocità di recovery richiesta e dal ruolo che questo componente svolge nell’architettura.
Quando una snapshot è sufficiente
RDB crea snapshot point-in-time del dataset.
È un modello adatto quando puoi tollerare la perdita delle modifiche avvenute dopo l’ultima snapshot oppure quando i dati in memoria sono comunque ricostruibili da un sistema primario.
Un vantaggio operativo è avere file compatti e adatti anche a procedure di disaster recovery.
Se l’istanza viene usata esclusivamente come cache di informazioni ricostruibili, puoi persino decidere che la persistenza non sia necessaria. Al riavvio la cache ripartirà vuota e verrà ripopolata dall’applicazione.
Naturalmente questo produce un periodo iniziale con molte cache miss, aspetto da considerare su sistemi trafficati.
Quando serve maggiore durabilità
AOF registra le operazioni di scrittura e permette di ricostruire il dataset riproducendole.
Il comportamento esatto dipende dalla configurazione di appendfsync: la maggiore durabilità comporta normalmente anche più lavoro di sincronizzazione verso lo storage.
È inoltre possibile utilizzare RDB e AOF insieme.
La decisione deve partire da un requisito concreto:
quanta informazione posso perdere se l’istanza si interrompe in questo momento?
Se la risposta è “nessuna”, la discussione non può fermarsi alla semplice attivazione di una modalità di persistence: devi valutare architettura, replica, failover e caratteristiche reali della durabilità richiesta dall’applicazione.
Persistenza non significa backup
Questo punto merita di essere tenuto separato.
Un file persistente mantiene uno stato recuperabile dopo un riavvio, ma non protegge automaticamente da:
- cancellazioni accidentali;
- corruzione propagata;
- errori applicativi;
- compromissione dell’host;
- perdita dell’intero storage;
- modifiche indesiderate già registrate.
Un backup deve essere conservato secondo una politica indipendente e testato attraverso procedure di restore.
Persistence, replica e backup risolvono problemi differenti.
Memoria, performance e gestione in produzione
Una configurazione che funziona in locale può comportarsi in modo molto diverso quando il dataset cresce.
Il controllo più importante riguarda spesso la RAM. Un data store in-memory non dispone di memoria infinita e il modo in cui reagisce al raggiungimento del limite deve essere intenzionale.
maxmemory ed eviction policy
maxmemory permette di stabilire quanta memoria può essere destinata ai dati prima di applicare il comportamento previsto dalla policy.
Per una cache questo valore va progettato insieme alla eviction policy.
Il principio è semplice:
decidi in anticipo cosa deve succedere quando la cache è piena.
Affidarsi alla configurazione senza comprenderla significa scoprire il comportamento dell’istanza durante un picco di traffico, cioè nel momento peggiore.
La corretta dimensione della memoria dipende anche dall’overhead delle strutture utilizzate, dalla frammentazione, dalla replica e dal tipo di workload. Per questo è preferibile misurare il dataset reale invece di stimarlo soltanto sommando le dimensioni dei valori applicativi.
Monitorare latenza, memoria e hot key
In produzione non basta sapere quanta RAM è allocata.
È utile osservare almeno:
- memoria effettivamente utilizzata;
- hit e miss;
- numero di eviction;
- scadenze;
- connessioni;
- comandi lenti;
- latenza;
- traffico di rete;
- replica;
- eventuali hot key.
Una chiave richiesta in modo sproporzionato può concentrare carico anche quando il resto del dataset è distribuito correttamente.
Allo stesso modo, un aumento dei cache miss può essere il sintomo di TTL troppo corti, memoria insufficiente, chiavi costruite male oppure cambiamenti nel pattern di traffico.
Monitorare serve quindi non solo a capire se il server sta funzionando, ma soprattutto se la strategia di caching sta ancora funzionando.
ACL, TLS e perché Redis non va esposto direttamente a Internet
Un’istanza Redis è un componente backend e va trattata di conseguenza.
La documentazione ufficiale sulla sicurezza Redis richiama esplicitamente il rischio delle istanze raggiungibili da reti esterne e il software dispone di protected mode proprio per limitare alcune configurazioni insicure.
In produzione la regola di partenza dovrebbe essere: l’istanza non deve essere pubblicamente raggiungibile se non esiste una ragione architetturale molto specifica e una protezione adeguata.
Usa reti private, firewall o security group, autenticazione e ACL; quando il modello di comunicazione lo richiede, valuta TLS.
E soprattutto mantieni il software aggiornato. Le patch non sono un dettaglio: possono correggere vulnerabilità oltre ai normali bug.
Cosa è cambiato nelle versioni attuali di Redis 8
Redis 8 ha modificato in modo sostanziale anche il modo corretto di descrivere il prodotto.
Nelle vecchie architetture era comune ragionare in termini di Redis Core più Redis Stack o una serie di moduli separati. Con Redis 8, Search, JSON, Time Series e strutture probabilistiche sono entrati nella distribuzione Redis Open Source e seguono lo stesso versioning.
Al momento di questo aggiornamento, agosto 2026, la serie corrente è Redis Open Source 8.10 e la release 8.10.1 contiene anche correzioni di sicurezza. Per i dettagli puntuali sulle minor release è preferibile consultare le release note ufficiali di Redis 8.10 invece di progettare un’architettura sulla base di una fotografia congelata.
Redis Open Source integra Search, JSON, Time Series e strutture probabilistiche
La conseguenza non è soltanto organizzativa.
La piattaforma può oggi coprire nello stesso ecosistema esigenze che in passato richiedevano l’installazione e la gestione separata di componenti aggiuntivi.
Questo rende più naturale utilizzare:
- documenti JSON;
- indici e full-text search;
- vector search;
- serie temporali;
- Bloom filter e altre strutture probabilistiche.
Non significa che debba sostituire ogni database specializzato. Significa che il confine del prodotto è diventato più ampio e che confrontarlo con il solo modello “cache key-value” rischia di far perdere una parte importante delle sue capacità attuali.
Vector set, ricerca e nuovi workload
Uno dei cambiamenti più interessanti della generazione Redis 8 riguarda i vettori.
Redis Search permette di indicizzare vettori memorizzati in hash o JSON e combinarli con filtri e altre forme di ricerca. Questo rende la piattaforma utilizzabile nei sistemi che devono recuperare rapidamente contenuti semanticamente vicini, ad esempio in pipeline RAG, recommendation system e semantic search.
Redis 8 ha inoltre introdotto i Vector Set come nuova struttura specializzata per similarity search.
Il vantaggio potenziale è la vicinanza tra dati operativi, cache e retrieval. Il limite è lo stesso che vale per qualsiasi scelta infrastrutturale: la presenza della feature non dimostra che Redis sia il vector database migliore per qualsiasi dimensione, volume o pattern di query.
Va confrontato sul workload effettivo.
Cosa non usare più come riferimento: RedisAI e RedisGears
Le guide più datate collegano spesso il futuro AI di Redis a RedisAI e RedisGears.
Quel modello non rappresenta più bene l’ecosistema corrente. RedisGears compare nella documentazione tra le funzionalità deprecate e l’attuale direzione AI ruota molto più attorno a vector search, retrieval, JSON e strumenti dedicati alla gestione del contesto.
Per un progetto nuovo non costruirei quindi una strategia AI partendo da tutorial RedisGears o RedisAI di alcuni anni fa.
Il punto più generale è utile anche per gli aggiornamenti futuri: questo ecosistema evolve rapidamente e le guide basate sulle vecchie famiglie di moduli invecchiano molto più velocemente delle spiegazioni sui concetti fondamentali.
Redis, Valkey e Memcached: quale scegliere
Redis, Valkey e Memcached vengono spesso messi nella stessa lista perché tutti possono essere usati per caching in memoria. Oggi, però, rappresentano scelte differenti.
| Tecnologia | Modello | Strutture dati | Persistenza | Licenza corrente | Scenario tipico |
|---|---|---|---|---|---|
| Redis 8+ | data structure store / database in-memory | molto ricche, più Search, JSON, Time Series e probabilistic | RDB, AOF o entrambe | AGPLv3, RSALv2 o SSPLv1 | cache evoluta, sessioni, dati real-time, ricerca, workload complessi |
| Valkey | in-memory data store nato dal fork di Redis OSS 7.2 | strutture dati ricche e sviluppo autonomo | sì | BSD 3-Clause | cache e data store quando governance/licenza permissiva sono criteri importanti |
| Memcached | distributed memory object cache | modello molto più essenziale | non è progettato come database persistente | BSD | caching semplice di piccoli dati ricostruibili |
Non esiste un vincitore assoluto. Il criterio deve essere il problema da risolvere.
Redis vs Valkey dopo la separazione dei due progetti
Valkey nasce dal fork di Redis OSS 7.2 ed è un progetto sotto l’ecosistema Linux Foundation. Da allora i due progetti hanno continuato a evolvere.
Questo rende ormai sbagliato descrivere Valkey come una copia “compatibile al 100%” con qualsiasi versione moderna.
La documentazione di migrazione Valkey indica una compatibilità diretta con Redis OSS 7.2 e versioni open source precedenti, mentre per release successive bisogna verificare formato dei file, comandi, configurazione e feature realmente utilizzate.
Per un nuovo progetto sceglierei Redis quando le capacità specifiche della piattaforma attuale — Search, JSON, vector search o relativo ecosistema — sono parte concreta dei requisiti.
Valkey merita invece una valutazione molto seria quando desideri una licenza BSD permissiva, un progetto community-governed o quando il provider cloud che utilizzi lo propone come motore principale.
Non trasformerei però la discussione in una scelta ideologica: Redis e Valkey oggi vanno confrontati sui requisiti del progetto corrente, non sulla fotografia del fork nel 2024.
Redis vs Memcached
Memcached rimane una soluzione molto più focalizzata sul caching di dati arbitrari in memoria.
Questa semplicità può essere un vantaggio.
Se ti serve soltanto una cache distribuita di valori ricostruibili e non hai bisogno di strutture dati avanzate, persistenza, stream, ricerca o altre funzioni più evolute, Memcached può essere perfettamente adeguato.
Redis diventa più interessante quando la cache è solo una parte del problema e vuoi utilizzare la stessa piattaforma anche per contatori, sorted set, sessioni, code, scadenze sofisticate o altri modelli applicativi.
La scelta corretta non è quindi “quale è più veloce in assoluto”, ma quale fa il lavoro necessario con meno complessità e con il comportamento operativo che ti serve.
Licenze: AGPLv3, RSALv2, SSPLv1 e BSD senza semplificazioni
La storia recente delle licenze è importante perché molte guide online riportano ancora una situazione ormai superata.
Redis 7.2 e precedenti rimangono sotto BSD 3-Clause. Con Redis 7.4 sono arrivate RSALv2 e SSPLv1. Da Redis 8 è stata aggiunta una terza opzione: AGPLv3, che è una licenza open source approvata dalla OSI.
La pagina ufficiale delle licenze Redis specifica quindi per Redis 8+ una tri-license composta da RSALv2, SSPLv1 e AGPLv3.
Valkey continua invece con una licenza BSD 3-Clause.
La distinzione pratica può essere rilevante soprattutto se modifichi il software, lo redistribuisci, offri servizi o hai policy aziendali specifiche sulle licenze. In questi scenari non affidarti a una semplificazione trovata in un tutorial: verifica i termini applicabili al tuo utilizzo e, quando la compliance è materiale, coinvolgi chi segue gli aspetti legali del progetto.
Redis nel cloud
Gestire direttamente un’istanza significa occuparsi di aggiornamenti, replica, failover, monitoraggio, sicurezza, capacità e backup.
Per questo molti progetti utilizzano un servizio gestito.
Le alternative attuali non si limitano più alla vecchia formula “AWS Redis, Google Redis, Azure Redis”. Anche il mercato cloud ha risentito della separazione Redis/Valkey e dei cambiamenti di licenza.
Redis Cloud
Redis offre direttamente Redis Cloud come servizio gestito.
È una scelta naturale quando vuoi utilizzare l’ecosistema mantenendo disponibile una piattaforma gestita senza occuparti dell’intera infrastruttura sottostante.
Come per qualsiasi servizio cloud, la valutazione non deve fermarsi alla facilità di provisioning. Devi confrontare costi, dimensionamento, disponibilità geografica, networking, backup, alta disponibilità e feature realmente incluse nel piano che ti interessa.
AWS ElastiCache e Google Cloud Memorystore
Amazon ElastiCache supporta attualmente Valkey, Redis OSS e Memcached. Questo rende la scelta del motore una decisione esplicita anche all’interno dello stesso servizio AWS.
Google Cloud dispone invece di prodotti Memorystore e oggi propone anche un servizio Memorystore for Valkey.
Questo è un cambiamento importante rispetto alle vecchie guide: il nome del cloud provider non ti dice più automaticamente quale implementazione o fork utilizzerai.
Prima di migrare controlla quindi almeno:
- engine effettivo;
- versione supportata;
- compatibilità di comandi e client;
- persistence e backup;
- replica e disponibilità;
- funzionalità di networking;
- autenticazione e TLS;
- possibilità di migrazione futura;
- costi del traffico e del dimensionamento.
Azure Managed Redis e il ritiro di Azure Cache for Redis
Nel mondo Microsoft la distinzione è ancora più importante.
Azure Cache for Redis è in fase di ritiro. Microsoft indica il 31 marzo 2027 per Enterprise ed Enterprise Flash e il 30 settembre 2028 per Basic, Standard e Premium, raccomandando la migrazione verso Azure Managed Redis.
Per i dettagli e le eventuali modifiche del calendario conviene controllare direttamente la FAQ ufficiale sul ritiro di Azure Cache for Redis.
Per un nuovo progetto Azure, quindi, non imposterei oggi l’architettura sulla vecchia Azure Cache for Redis come se fosse ancora il servizio di riferimento a lungo termine. Il prodotto da valutare è Azure Managed Redis, basato su Redis Enterprise.
Questo esempio mostra bene perché la revalidation è necessaria: un’architettura cloud corretta nel 2024 o nel 2025 può non essere più la scelta consigliabile oggi.
Conclusione
Redis continua a essere una delle tecnologie più utili quando devi evitare lavoro ripetitivo e mantenere dati frequentemente utilizzati vicino all’applicazione. Ma il vero vantaggio non viene dalla semplice installazione: nasce da una progettazione corretta di chiavi, TTL, invalidazione, memoria e persistenza.
Se devi soltanto memorizzare temporaneamente valori semplici, anche Memcached può essere sufficiente. Se preferisci una licenza BSD permissiva o il tuo ecosistema cloud si sta spostando verso quel progetto, Valkey è ormai un’alternativa autonoma da valutare seriamente. Se invece ti servono le strutture dati e le capacità più ampie della piattaforma attuale, Redis 8 va molto oltre il ruolo storico di semplice cache.
Su WordPress la stessa logica resta valida: una object cache basata su Redis ha senso quando riduce realmente query e calcoli ripetuti, soprattutto sui siti dinamici. Non sostituisce page cache, browser cache o un’infrastruttura adeguata.
Prima di introdurla misura quindi il problema. Se il collo di bottiglia è il database e il workload si presta a essere memorizzato o riutilizzato, una cache persistente può cambiare sensibilmente il comportamento del backend. Se il problema è altrove, aggiungere un altro servizio renderà soltanto lo stack più complesso.
Quando la configurazione della object cache e le performance server richiedono un intervento sull’infrastruttura WordPress, puoi valutare anche il nostro servizio di assistenza WordPress per analizzare il problema prima di modificare lo stack.