
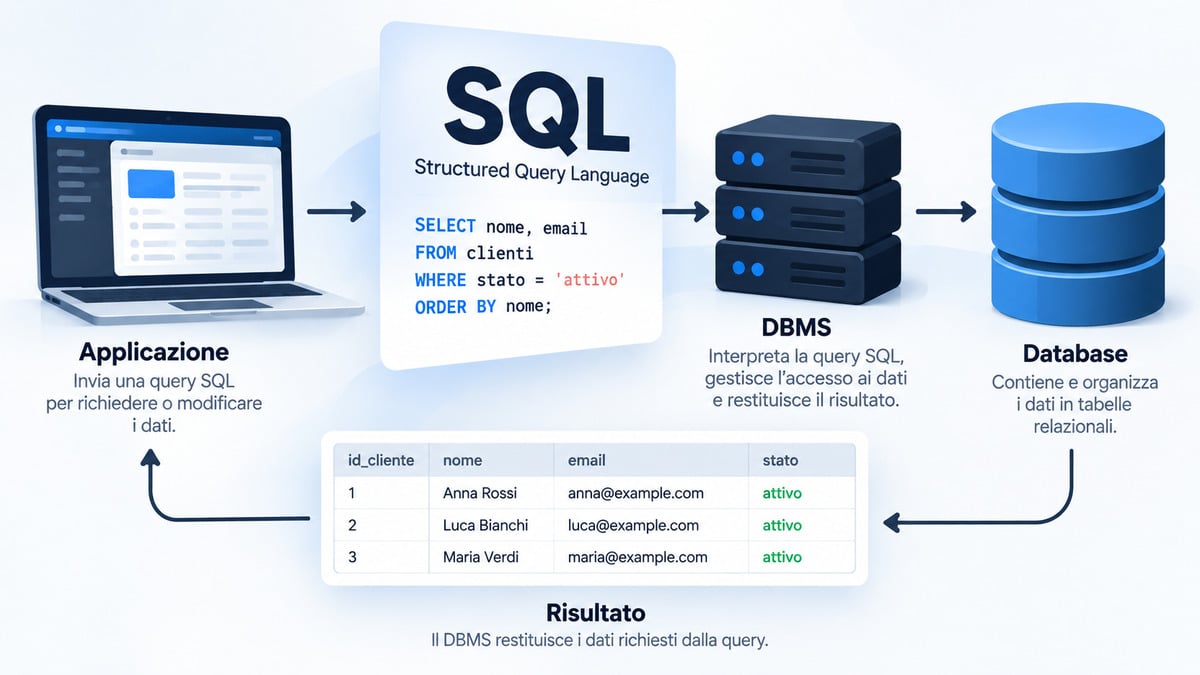
SQL è il linguaggio con cui applicazioni, sviluppatori e strumenti possono leggere, inserire, modificare e organizzare dati gestiti da molti database relazionali. Dietro una ricerca di prodotti, l’apertura di un ordine o il recupero di un account può esserci una query che descrive quali informazioni servono e a quali condizioni.
Il punto che crea più confusione è distinguere il linguaggio dagli altri componenti. SQL non è MySQL, non è PostgreSQL e non è il database stesso. Se vuoi partire da questa distinzione più generale, nella guida ai database trovi separati database, DBMS, modello relazionale e sistemi non relazionali.
In questa guida partiamo invece dal linguaggio: vediamo cosa significa, come funziona una query, quali sono i comandi fondamentali, perché servono i JOIN e che cosa cambia quando passi da un DBMS a un altro.
Cos’è SQL e a cosa serve
SQL significa Structured Query Language. È un linguaggio standardizzato pensato per lavorare con dati organizzati secondo il modello relazionale.
Con questo linguaggio puoi, tra le altre cose:
- recuperare righe e colonne;
- filtrare e ordinare risultati;
- combinare dati provenienti da tabelle correlate;
- aggiungere, modificare o cancellare record;
- creare e modificare strutture come tabelle;
- gestire transazioni;
- intervenire su utenti e privilegi quando il DBMS lo consente.
Lo standard è definito dalla famiglia ISO/IEC 9075. La parte Framework pubblicata da ISO descrive il quadro concettuale e la terminologia utilizzati dalle altre parti dello standard.
Questo non significa che ogni database lo implementi nello stesso modo. Lo standard fornisce una base comune; i singoli sistemi aggiungono funzioni, tipi, sintassi e comportamenti propri.
Un linguaggio dichiarativo: cosa significa davvero
Uno dei modi più utili per capirlo è considerarlo un linguaggio largamente dichiarativo.
Quando scrivi una query, normalmente descrivi quale risultato vuoi ottenere. Non specifichi passo dopo passo come il motore debba leggere fisicamente i file, scegliere un indice, combinare i dati in memoria o ordinare le operazioni interne.
Per esempio:
SELECT nome, email
FROM clienti
WHERE stato = 'attivo'
ORDER BY nome;
La richiesta è comprensibile quasi direttamente:
dammi nome ed email dei clienti attivi, ordinati per nome.
Non stai indicando al DBMS quale pagina su disco leggere per prima. Il database riceve l’istruzione, la analizza e decide un piano di esecuzione adatto alle strutture disponibili.
È questa separazione tra risultato richiesto e procedura interna utilizzata per ottenerlo che rende il modello dichiarativo così importante nei database relazionali.
Linguaggio, database e DBMS: tre concetti diversi
I tre termini vengono spesso usati come se fossero equivalenti:
- il database contiene e organizza i dati;
- il DBMS è il software che gestisce quei dati;
- SQL è il linguaggio attraverso cui puoi formulare molte delle operazioni che il DBMS deve eseguire.
Un flusso semplificato può essere:
applicazione → istruzione → DBMS → database → risultato
È lo stesso motivo per cui dire “SQL e MySQL sono la stessa cosa” è sbagliato.
Nella guida su che cos’è MySQL questa distinzione diventa concreta: MySQL è un RDBMS, mentre SQL è il linguaggio che il sistema interpreta.
Lo stesso principio vale per altri sistemi relazionali.
Standard SQL e dialetti: perché la sintassi non è identica ovunque
La parte fondamentale del linguaggio è molto trasferibile. Un SELECT, una condizione WHERE, un JOIN o un GROUP BY mantengono un modello mentale riconoscibile tra database differenti.
La compatibilità, però, non è identità.
MySQL documenta esplicitamente proprie estensioni e differenze rispetto allo standard. PostgreSQL mantiene una documentazione specifica sulla conformità. SQLite descrive il linguaggio supportato dal motore, comprese peculiarità e funzionalità proprie. Microsoft utilizza invece Transact-SQL come propria implementazione estesa.
È utile quindi distinguere due livelli:
Nucleo trasferibile
Concetti, logica relazionale e sintassi comune che puoi riutilizzare tra DBMS.
Dialetto specifico
Funzioni, tipi, estensioni, clausole e comportamenti propri del sistema che stai usando.
Imparare prima il livello comune rende molto più semplice passare in seguito da un prodotto a un altro.
Come funziona una query SQL
Una query è una richiesta formulata verso un sistema che gestisce dati.
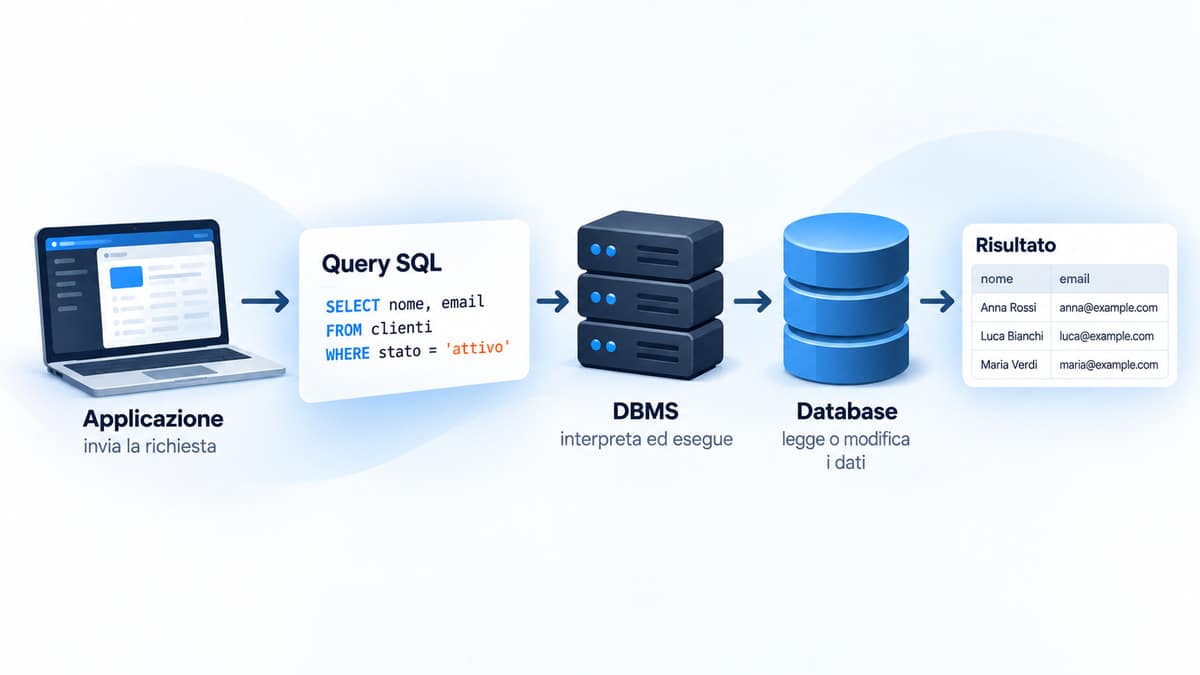
Il linguaggio non coincide quindi con il concetto generale di query. Una query può esistere anche in altri contesti e con altri linguaggi. Nella guida dedicata trovi più in dettaglio che cos’è una query e come funziona.
Nel contesto SQL, una query può chiedere per esempio:
- quali prodotti appartengono a una categoria;
- quali ordini sono ancora da spedire;
- quanto ha speso ogni cliente;
- quanti articoli sono stati pubblicati in un certo periodo;
- quali righe di due tabelle sono collegate dalla stessa chiave.
Dalla richiesta al risultato: cosa fa il DBMS
Consideriamo questa istruzione:
SELECT nome, prezzo
FROM prodotti
WHERE categoria = 'mouse';
Per il lettore la logica è semplice.
SELECT nome, prezzo stabilisce quali colonne devono essere restituite.
FROM prodotti indica da quale tabella provengono i dati.
WHERE categoria = 'mouse' limita il risultato alle righe che soddisfano la condizione.
Il DBMS deve poi trasformare quella richiesta in un’operazione eseguibile. Può analizzare la query, verificare tabelle e colonne, controllare i permessi, scegliere un piano e recuperare i dati necessari.
La documentazione dei principali DBMS tratta infatti SELECT come l’istruzione utilizzata per recuperare righe, mentre clausole come WHERE, GROUP BY e ORDER BY modificano il modo in cui viene costruito il risultato.
La sintassi di base: SELECT, FROM, WHERE e ORDER BY
Una forma semplice è:
SELECT colonna1, colonna2
FROM tabella
WHERE condizione
ORDER BY colonna1;
Non tutte le clausole sono obbligatorie.
Se vuoi ottenere tutti i clienti:
SELECT id_cliente, nome, email
FROM clienti;
Se vuoi soltanto quelli attivi:
SELECT id_cliente, nome, email
FROM clienti
WHERE stato = 'attivo';
Se vuoi anche ordinarli:
SELECT id_cliente, nome, email
FROM clienti
WHERE stato = 'attivo'
ORDER BY nome;
Il punto importante è capire la funzione di ogni parte. Memorizzare una query senza sapere perché contiene FROM o WHERE aiuta poco quando il problema cambia.
Una prima query SQL spiegata riga per riga
Prendiamo un esempio leggermente più realistico:
SELECT nome, email
FROM clienti
WHERE stato = 'attivo'
ORDER BY nome ASC;
La query può essere letta così:
SELECT nome, email
Vogliamo restituire soltanto queste due colonne.
FROM clienti
I valori arrivano dalla tabella clienti.
WHERE stato = 'attivo'
Sono ammesse solo le righe in cui la colonna stato contiene il valore indicato.
ORDER BY nome ASC
Il risultato viene ordinato per nome in senso crescente.
Questa capacità di leggere una query come una frase logica è più utile della memorizzazione meccanica della sintassi.
I comandi SQL fondamentali
Quando inizi, è facile imbattersi in sigle come DDL, DML, DCL o TCL.
Sono classificazioni utili per orientarsi, ma non serve trasformarle in una lista da imparare prima ancora di avere scritto una query. Per un uso pratico conviene partire dalla funzione dell’istruzione.
Leggere i dati con SELECT
SELECT è normalmente il primo comando che impari perché permette di interrogare i dati senza modificarli.
Puoi scegliere colonne specifiche:
SELECT nome, prezzo
FROM prodotti;
filtrare:
SELECT nome, prezzo
FROM prodotti
WHERE prezzo < 100;
oppure ordinare:
SELECT nome, prezzo
FROM prodotti
ORDER BY prezzo DESC;
Man mano che il problema cresce, SELECT può includere JOIN, aggregazioni, sottoquery, espressioni e molte altre clausole.
Non serve però affrontarle tutte insieme. Se non è chiaro cosa rappresenta il risultato atteso, una query più sofisticata non risolve il problema concettuale.
Inserire e modificare dati con INSERT, UPDATE e DELETE
Quando devi scrivere nel database entrano in gioco altre istruzioni.
Per aggiungere una riga:
INSERT INTO clienti (nome, email, stato)
VALUES ('Mario Rossi', '[email protected]', 'attivo');
Per modificare una riga esistente:
UPDATE clienti
SET stato = 'inattivo'
WHERE id_cliente = 42;
Per eliminarla:
DELETE FROM clienti
WHERE id_cliente = 42;
Qui compare una regola pratica importante: prima di eseguire UPDATE o DELETE, controlla con attenzione la condizione WHERE.
Questa istruzione:
UPDATE clienti
SET stato = 'inattivo';
non modifica un singolo cliente. In assenza di filtro, può coinvolgere tutte le righe della tabella.
Per questo le operazioni di scrittura meritano più cautela delle prime query di lettura.
Creare e modificare la struttura con CREATE e ALTER
SQL non serve soltanto a lavorare sui record già presenti. Può definire anche strutture del database.
Un esempio semplice:
CREATE TABLE clienti (
    id_cliente INTEGER PRIMARY KEY,
    nome VARCHAR(100) NOT NULL,
    email VARCHAR(255) NOT NULL
);
Qui non stiamo inserendo clienti. Stiamo definendo la tabella che potrà contenerli.
Se in seguito serve una nuova colonna, molti DBMS permettono di usare ALTER TABLE:
ALTER TABLE clienti
ADD COLUMN telefono VARCHAR(30);
La sintassi precisa e le funzionalità supportate possono variare tra sistemi. È uno dei casi in cui la distinzione tra SQL comune e dialetto diventa pratica, non teorica.
Transazioni e permessi: COMMIT, ROLLBACK, GRANT e REVOKE
Alcune operazioni non dovrebbero essere considerate singolarmente.
Immagina un trasferimento tra due conti: togliere una somma da un conto e aggiungerla all’altro costituisce logicamente un’unica operazione. Se una metà riesce e l’altra fallisce, il dato finale è incoerente.
Le transazioni servono a trattare più operazioni come un’unità controllata. Concetti come COMMIT e ROLLBACK permettono rispettivamente di confermare o annullare una transazione secondo le regole del DBMS.
Allo stesso modo, istruzioni come GRANT e REVOKE riguardano i privilegi concessi agli utenti.
La sintassi completa cambia tra prodotti, quindi ha più senso imparare prima il concetto e approfondire poi la documentazione del sistema realmente utilizzato.
Relazioni e JOIN: quando una query coinvolge più tabelle
Un database relazionale diventa interessante quando le informazioni non sono concentrate in una tabella enorme, ma distribuite in strutture collegate.
Potresti avere:
- una tabella
clienti; - una tabella
ordini; - una tabella
prodotti; - una tabella che collega ordini e prodotti.
Un ordine può riferirsi a un cliente tramite un identificatore comune. È qui che entrano in gioco i JOIN.
Chiavi e relazioni: cosa serve sapere prima dei JOIN
Supponiamo che clienti contenga:
| id_cliente | nome |
|---|---|
| 1 | Anna |
| 2 | Luca |
e che ordini contenga:
| id_ordine | id_cliente | totale |
|---|---|---|
| 101 | 1 | 79.90 |
| 102 | 1 | 35.00 |
| 103 | 2 | 120.00 |
La colonna id_cliente permette di capire a chi appartiene ogni ordine.
Non serve ripetere nome ed email del cliente dentro ogni riga di ordini. Il legame viene rappresentato tramite gli identificatori.
INNER JOIN e LEFT JOIN con un esempio pratico
Se vuoi ottenere cliente, ordine e totale:
SELECT
    c.nome,
    o.id_ordine,
    o.totale
FROM clienti AS c
INNER JOIN ordini AS o
    ON o.id_cliente = c.id_cliente;
INNER JOIN restituisce le combinazioni per cui esiste una corrispondenza tra le due tabelle.
Se invece vuoi mantenere nell’elenco anche i clienti che non hanno ordini, puoi usare un LEFT JOIN:
SELECT
    c.nome,
    o.id_ordine,
    o.totale
FROM clienti AS c
LEFT JOIN ordini AS o
    ON o.id_cliente = c.id_cliente;
La differenza non è cosmetica.
Con INNER JOIN stai chiedendo le righe che trovano una corrispondenza.
Con LEFT JOIN chiedi di preservare tutte le righe della tabella a sinistra e aggiungere, quando esistono, i dati corrispondenti della tabella a destra.
Le documentazioni di PostgreSQL e MariaDB trattano questi operatori come parte centrale delle query che combinano più tabelle.
GROUP BY e funzioni aggregate: trasformare righe in informazioni
A volte non vuoi vedere ogni ordine. Vuoi ottenere una sintesi.
Per esempio:
SELECT
    id_cliente,
    COUNT(*) AS numero_ordini,
    SUM(totale) AS totale_speso
FROM ordini
GROUP BY id_cliente;
In questo caso le righe vengono raggruppate per cliente.
COUNT(*) conta gli ordini.
SUM(totale) somma i relativi importi.
GROUP BY id_cliente stabilisce il criterio di raggruppamento.
È un passaggio importante perché mostra che SQL non serve soltanto a “cercare record”: può trasformare insiemi di righe in risultati aggregati utili per analisi, report e logica applicativa.
SQL, MySQL, PostgreSQL e altri DBMS: cosa cambia davvero
Una delle competenze più utili è capire quale parte di ciò che stai imparando appartiene al nucleo comune e quale dipende dallo specifico database.
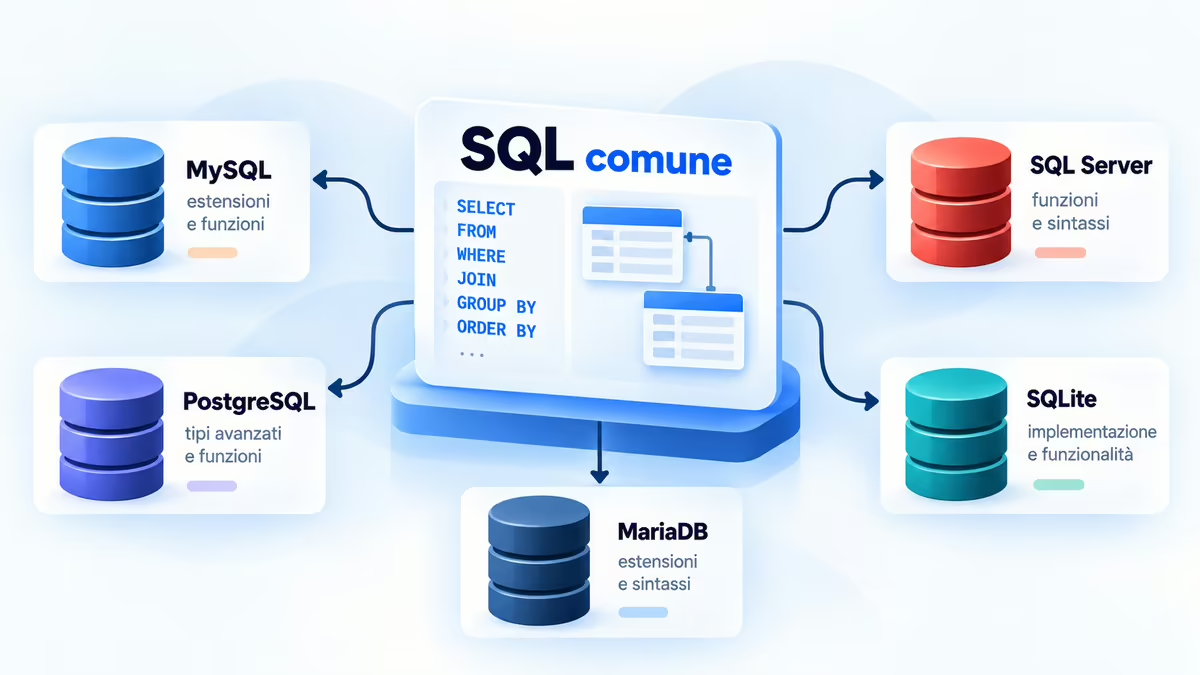
Se oggi usi MySQL e domani passi a PostgreSQL, non riparti da zero. Tabelle, relazioni, query, filtri, JOIN e aggregazioni restano concetti familiari.
Non puoi però assumere che tutto il codice funzioni senza modifiche.
SQL è il linguaggio, il DBMS è il sistema che lo esegue
Il modello mentale può essere ridotto a:
istruzione → DBMS → database → risultato
MySQL, PostgreSQL e MariaDB sono quindi sistemi distinti che utilizzano SQL ma non coincidono con il linguaggio.
Anche Microsoft SQL Server utilizza un proprio dialetto, Transact-SQL. SQLite supporta gran parte del linguaggio standard aggiungendo e omettendo funzionalità proprie.
Cosa resta trasferibile tra i principali DBMS
Per chi inizia, le competenze più trasferibili sono:
- pensare in tabelle, righe e colonne;
- capire chiavi e relazioni;
- costruire
SELECT; - filtrare con
WHERE; - ordinare con
ORDER BY; - combinare tabelle con
JOIN; - aggregare con
GROUP BY; - distinguere lettura, scrittura e modifica dello schema;
- ragionare su transazioni e integrità dei dati.
Sono questi concetti che conviene imparare prima.
Le estensioni vendor-specifiche diventano importanti quando servono davvero al progetto.
Perché una query valida su un DBMS può richiedere modifiche su un altro
Le differenze possono riguardare:
- tipi di dati;
- funzioni;
- conversioni;
- gestione di date e orari;
- auto-incremento degli identificatori;
- limiti e paginazione;
- JSON;
- procedure e funzioni;
- gestione degli errori;
- privilegi;
- sintassi di alcune operazioni;
- funzionalità avanzate dell’ottimizzatore.
MySQL, per esempio, documenta separatamente le proprie estensioni e le differenze rispetto allo standard. SQLite dichiara esplicitamente di supportare la maggior parte del linguaggio standard con proprie omissioni ed estensioni.
La conseguenza pratica è semplice: una query che funziona non è automaticamente portabile.
Se sai distinguere standard, concetto e dialetto, puoi leggere la documentazione corretta e capire rapidamente quale parte deve cambiare.
Come imparare SQL evitando gli errori più comuni
Imparare il linguaggio non significa memorizzare il maggior numero possibile di istruzioni.
Un percorso più efficace segue la dipendenza tra i concetti.
Parti da SELECT, filtri e ordinamento prima delle funzioni avanzate
Il primo obiettivo dovrebbe essere riuscire a leggere una tabella e formulare domande semplici sui dati.
Inizia da:
SELECT → FROM → WHERE → ORDER BY
Poi aggiungi:
- operatori di confronto;
- condizioni multiple;
- valori
NULL; - alias;
- funzioni semplici.
Puoi esercitarti da riga di comando, con un client dedicato o attraverso strumenti grafici. Se lavori con MySQL o MariaDB, phpMyAdmin consente anche di eseguire query tramite browser.
Lo strumento, però, non sostituisce la comprensione della query. Un’interfaccia può aiutarti a eseguire il codice; non può decidere quale relazione tra i dati ha senso per il tuo problema.
Passa a JOIN e aggregazioni quando hai capito le relazioni
Imparare JOIN prima di capire perché esistono più tabelle porta spesso a memorizzare sintassi senza modello mentale.
Prima chiarisci:
- qual è l’entità rappresentata da ogni tabella;
- qual è la chiave che identifica una riga;
- quale colonna collega le due tabelle;
- quali righe devono restare nel risultato.
Solo dopo scegli il tipo di JOIN.
Lo stesso vale per GROUP BY: prima definisci quale domanda aggregata vuoi fare, poi costruisci la query.
Non copiare sintassi senza sapere quale dialetto stai usando
Un esempio trovato online può essere perfettamente corretto e comunque non funzionare nel tuo ambiente.
Prima di copiarlo chiediti:
- per quale DBMS è stato scritto?
- quale versione o famiglia di prodotto presuppone?
- usa una funzione standard o proprietaria?
- richiede una modalità particolare?
- modifica dati reali?
La documentazione dei DBMS esiste proprio perché un esempio generico non identifica da solo ogni dettaglio dell’implementazione.
Modifiche ai dati e sicurezza: WHERE, transazioni e query parametrizzate
Quando passi dalla lettura alla scrittura, gli errori diventano più costosi.
Un SELECT sbagliato può restituire dati inutili.
Un UPDATE o un DELETE sbagliato può modificare dati reali.
Conviene quindi:
- controllare il filtro prima della modifica;
- testare su dati non critici quando possibile;
- conoscere le transazioni offerte dal DBMS;
- limitare i privilegi dell’account;
- non concatenare input non affidabili direttamente dentro la stringa della query.
Quest’ultimo punto è essenziale nelle applicazioni web.
Una query costruita concatenando input esterno può permettere a quel contenuto di alterare l’istruzione. La difesa strutturale consiste nell’utilizzare query parametrizzate o prepared statement, separando il codice dai valori. OWASP le indica tra le difese principali contro la SQL injection nella propria SQL Injection Prevention Cheat Sheet.
Se vuoi approfondire il meccanismo e le difese applicative, trovi una guida separata sulla SQL injection.
Quando passare a subquery, CTE, funzioni finestra, indici e ottimizzazione
Dopo aver acquisito sicurezza con query, JOIN e aggregazioni puoi affrontare temi più avanzati.
Le subquery permettono di usare il risultato di una query dentro un’altra operazione.
Le CTE aiutano a strutturare alcune query complesse.
Le funzioni finestra permettono calcoli su insiemi di righe senza ridurli necessariamente a un’unica riga per gruppo.
Gli indici riguardano invece il modo in cui il DBMS può rendere più efficiente l’accesso ai dati.
A quel punto conviene spostare l’attenzione dalla domanda “qual è il prossimo comando da imparare?” a domande più concrete:
- il modello dei dati è corretto?
- la query produce davvero il risultato richiesto?
- sto usando il dialetto giusto?
- il DBMS può eseguirla in modo efficiente?
- l’applicazione tratta input e privilegi in modo sicuro?
Il linguaggio acquista valore soprattutto quando entra in un sistema reale.
Nel backend, per esempio, il database è uno dei componenti che l’applicazione può interrogare per trasformare una richiesta in una risposta. In un profilo full stack developer, conoscere almeno le basi del linguaggio aiuta invece a seguire il flusso dei dati oltre il solo livello dell’interfaccia.
Conclusione
Il modo più utile per imparare SQL non è trattarlo come un dizionario di comandi.
Parti dal modello:
dati → database → DBMS → SQL → query → risultato
Poi costruisci il linguaggio nello stesso ordine in cui cresce il problema: prima SELECT, filtri e ordinamento; poi relazioni e JOIN; quindi aggregazioni, modifiche, transazioni e strumenti più avanzati.
La parte fondamentale resterà trasferibile tra diversi database. Quando una funzione o una sintassi cambia, saprai invece riconoscere che sei entrato nel territorio del singolo dialetto e potrai verificare la documentazione corretta.
È questa distinzione che rende il linguaggio molto meno difficile da imparare: non devi conoscerlo tutto in anticipo. Devi capire quale domanda stai facendo ai dati e quale livello del sistema è responsabile della risposta.