
L’inferenza AI è il momento in cui un modello già addestrato riceve nuovi input e utilizza ciò che ha appreso per produrre un risultato: una classificazione, una previsione, una raccomandazione, del testo, un’immagine o un altro tipo di output.
È una distinzione più importante di quanto sembri. Quando utilizzi un modello non lo stai necessariamente addestrando e non stai automaticamente modificando ciò che ha imparato. Nella maggior parte dei casi stai chiedendo a parametri già determinati di elaborare un nuovo input.
Se l’intelligenza artificiale descrive il campo generale, l’inferenza AI è uno dei passaggi che trasformano un modello addestrato in qualcosa che può essere realmente utilizzato.
La questione diventa ancora più interessante con gli LLM e l’AI generativa. Una risposta non appare semplicemente perché il modello “conosce” il risultato: il sistema deve elaborare il contesto, eseguire calcoli sui parametri del modello e, nel caso di un modello linguistico autoregressivo, generare progressivamente nuovi token.
Capire l’inferenza significa quindi capire che cosa succede tra un input e l’output di un modello, ma anche perché velocità, hardware, modalità di esecuzione e dimensione del workload possono cambiare radicalmente l’esperienza e il costo di utilizzo dello stesso modello.
Cos’è l’inferenza AI
L’inferenza AI è l’utilizzo operativo di un modello per elaborare dati che non costituiscono un nuovo ciclo di addestramento.
Il termine viene usato soprattutto nel machine learning, dove possiamo separare due momenti fondamentali:
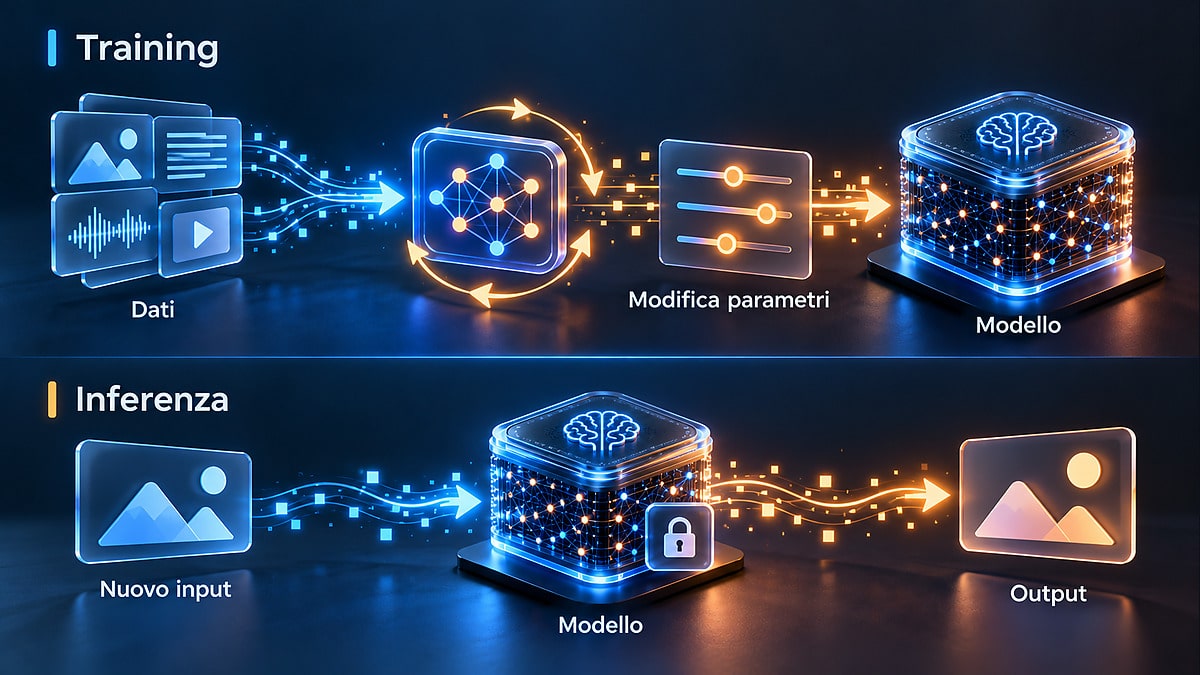
training → costruzione o modifica del modello
inferenza → utilizzo del modello su nuovi input
Prendiamo un classificatore di immagini addestrato a distinguere cani e gatti. Durante il training riceve molti esempi e modifica i propri parametri per ridurre gli errori. Quando in seguito gli mostri una fotografia mai vista e ottieni una previsione, stai eseguendo un’inferenza.
In altre parole, l’inferenza AI è il momento in cui ciò che il modello ha appreso viene applicato a un caso concreto.
Lo stesso concetto vale per sistemi molto diversi. Un modello può stimare il rischio di frode di una transazione, classificare un documento, prevedere la domanda di un prodotto, riconoscere un oggetto o generare una risposta testuale.
Cambia la complessità del modello. Non cambia il principio fondamentale: nuovi input entrano, il modello applica ciò che ha appreso e produce un output.
Questa distinzione corrisponde anche alla definizione operativa dell’inferenza AI descritta da IBM: un modello già addestrato applica ciò che ha appreso a nuovi dati o richieste, invece di avviare automaticamente un nuovo processo di addestramento.
Cosa significa inferenza nel machine learning
Nel machine learning un modello contiene una struttura e un insieme di parametri determinati durante l’addestramento. L’inferenza usa quella configurazione per calcolare un risultato su dati nuovi.
In una regressione il risultato potrebbe essere un valore numerico. In un classificatore potrebbe essere una probabilità associata a diverse classi. In una rete neurale profonda potrebbe essere una rappresentazione, una categoria, una sequenza di token o un altro output molto più complesso.
Questo chiarisce anche la relazione fra algoritmo e modello.
L’algoritmo di apprendimento è il procedimento utilizzato per costruire o ottimizzare il modello. Il modello addestrato è invece ciò che può essere utilizzato successivamente per l’inferenza AI.
In pratica, l’inferenza è il momento in cui il lavoro svolto durante l’addestramento diventa utilizzabile.
Perché inferenza non significa automaticamente apprendimento o “ragionamento”
La parola inferenza può creare confusione perché nel linguaggio comune richiama un processo di deduzione o ragionamento. Nell’AI il significato operativo è più ampio e più concreto.
Quando un classificatore assegna a una fotografia la categoria “gatto”, sta eseguendo inferenza. Non serve attribuirgli una forma di ragionamento simile a quella umana.
Lo stesso vale per un modello generativo. Il fatto che produca una risposta articolata non dimostra, da solo, che durante quella richiesta abbia imparato qualcosa di nuovo o modificato i propri parametri.
Bisogna quindi separare almeno tre concetti:
- inferenza AI: utilizzo del modello per produrre un output;
- apprendimento: processo che determina o modifica i parametri;
- ragionamento: termine utilizzato per descrivere particolari strategie o capacità di elaborazione, ma che non coincide con l’intero processo di inferenza.
Un modello può eseguire inferenza senza essere in fase di apprendimento. Allo stesso modo, ogni output di un modello passa attraverso un processo di inferenza anche quando il task non richiede ciò che normalmente chiameremmo ragionamento complesso.
Come funziona l’inferenza AI
Nella forma più generale, una pipeline di inferenza AI può essere rappresentata così:
input → preparazione → modello → output → eventuale logica applicativa
Dietro questa sequenza possono però esserci sistemi molto differenti.
Un classificatore tabellare, una rete neurale per riconoscere immagini e un grande modello linguistico non eseguono gli stessi calcoli. Per questo è meglio capire il meccanismo comune senza trasformarlo in una descrizione tecnica valida indistintamente per qualsiasi architettura.
Input e preparazione dei dati
L’inferenza comincia da un input compatibile con il modello.
Può essere una fotografia, una sequenza di numeri, un documento, un segnale audio, un prompt o una rappresentazione già elaborata da un altro componente del sistema.
Spesso l’input non viene passato direttamente al modello nella sua forma originale. Deve prima essere trasformato.
Una fotografia può essere ridimensionata e convertita in valori numerici. Una variabile categorica può essere codificata. Una frase destinata a un modello linguistico viene suddivisa in token. Un sistema RAG può recuperare documenti pertinenti e inserirli nel contesto prima che il modello generi una risposta.
Questa fase è importante perché il modello non vede necessariamente ciò che vede l’utente. Riceve una rappresentazione computazionale preparata secondo le regole previste dal sistema.
Per questo l’inferenza AI non dovrebbe essere immaginata come una scatola isolata: nella pratica è spesso una fase inserita all’interno di una pipeline più ampia.
Forward pass: il modello usa i parametri già appresi
Nelle reti neurali, durante l’inferenza l’input attraversa la rete attraverso un forward pass.
I valori vengono trasformati progressivamente dai diversi livelli usando i pesi e gli altri parametri appresi durante il training. Il risultato finale dipende dall’architettura e dal compito del modello.
Un classificatore può restituire una distribuzione di probabilità. Un modello di regressione un valore. Un modello generativo può produrre una rappresentazione dalla quale viene selezionato il token successivo.
Il punto decisivo è ciò che normalmente non avviene durante la normale inferenza AI: non viene eseguita la procedura di backpropagation usata in fase di training per calcolare come modificare i parametri del modello.
Per i modelli non neurali il termine forward pass può non essere quello appropriato, ma il principio resta analogo: viene applicato un modello già costruito senza avviare automaticamente un nuovo ciclo di apprendimento.
Dall’output del modello al risultato usato dall’applicazione
L’output grezzo del modello non coincide sempre con ciò che vede l’utente.
Un modello antifrode potrebbe produrre un punteggio che viene successivamente confrontato con una soglia. Un classificatore può restituire probabilità che l’applicazione trasforma in un’etichetta. Un modello linguistico genera token che l’interfaccia mostra progressivamente come testo.
In una pipeline di inferenza AI, questo passaggio è importante perché l’output del modello può essere soltanto uno degli elementi utilizzati per costruire il risultato finale.
Un sistema AI reale può inoltre aggiungere controlli, filtri, regole, strumenti, database, verifiche o azioni successive.
Per questo modello e sistema AI non sono sinonimi.
Il modello esegue l’inferenza. Il sistema decide come preparare l’input, come usare l’output e quali altre operazioni devono avvenire prima o dopo.
Training e inferenza AI: cosa cambia davvero
Training e inferenza AI utilizzano un modello in momenti differenti del suo ciclo di vita, ma hanno obiettivi diversi.
Durante il training vogliamo modificare il modello affinché svolga meglio un determinato compito. Durante l’inferenza vogliamo utilizzare il modello ottenuto.
| Processo | Cosa succede | I parametri cambiano? | Risultato |
|---|---|---|---|
| Training | il modello apprende dai dati rispetto a un obiettivo | Sì | modello addestrato |
| Fine-tuning | un modello esistente viene ulteriormente adattato | Sì | modello adattato |
| Inferenza | il modello elabora nuovi input | Normalmente no | previsione o output |
| Retrieval | vengono recuperate informazioni esterne | No | nuovo contesto per la richiesta |
| Memoria applicativa | informazioni vengono conservate fuori dal modello | No | contesto riutilizzabile |
Questa tabella risolve un equivoco molto comune: far vedere informazioni nuove a un sistema non significa necessariamente insegnarle al modello.
Nel training i parametri cambiano, nell’inferenza vengono utilizzati
In una rete neurale supervisionata, il training comprende normalmente una previsione, la misura dell’errore e un processo di ottimizzazione che modifica progressivamente i pesi.
L’inferenza utilizza invece quei pesi per elaborare dati nuovi.
Se una rete è stata addestrata per classificare immagini, può ricevere migliaia di nuove fotografie durante l’utilizzo senza che i suoi pesi cambino dopo ogni previsione.
Il confine fra training e inferenza AI è quindi soprattutto un confine fra modifica del modello e utilizzo del modello.
È anche per questo che training e inferenza hanno requisiti computazionali differenti.
L’addestramento deve gestire anche i calcoli necessari all’ottimizzazione e alla modifica dei parametri. L’inferenza punta invece soprattutto a produrre risultati con un compromesso adeguato fra qualità, latenza, capacità e costo.
Questa distinzione diventa particolarmente evidente nel deep learning, dove modelli molto grandi possono richiedere infrastrutture sostanzialmente differenti per addestramento e utilizzo.
Fine-tuning, retrieval, memoria e online learning non sono la stessa cosa
Un’altra fonte di confusione nasce dai sistemi che sembrano “imparare” durante l’utilizzo.
Immagina un assistente che ricorda il tuo nome in una conversazione successiva. Non possiamo concludere che il modello sia stato riaddestrato.
L’informazione potrebbe essere conservata in una memoria esterna e aggiunta al contesto della richiesta seguente.
Lo stesso vale per il retrieval. Se un sistema cerca informazioni in una knowledge base e le passa al modello, sta cambiando il contesto dell’inferenza, non necessariamente i parametri.
Il fine-tuning fa qualcosa di diverso: modifica realmente il modello attraverso un ulteriore processo di addestramento.
Esiste inoltre l’online learning, nel quale un sistema viene progettato per aggiornare il modello sulla base di nuovi dati durante il funzionamento. È una possibilità reale, ma non è una proprietà automatica di qualsiasi applicazione AI.
La distinzione pratica è quindi questa: prima di dire che un sistema “ha imparato”, bisogna chiedere dove è cambiata l’informazione. Nei parametri del modello? Nel prompt? In un database? In una memoria? In un indice di retrieval?
Sono meccanismi differenti e producono conseguenze differenti.
Un esempio concreto è Hermes Agent: il suo approccio “self-improving” si basa soprattutto su memoria persistente e skill riutilizzabili che restano attorno al modello. Il sistema può quindi conservare informazioni e procedure utili tra sessioni successive senza che questo implichi automaticamente un nuovo addestramento o una modifica dei pesi del modello.
Come funziona l’inferenza negli LLM e nell’AI generativa
Con un Large Language Model l’inferenza AI assume una forma particolare perché l’output viene costruito progressivamente.
Con inferenza LLM non intendiamo quindi un singolo calcolo che trasforma l’intero prompt nella risposta completa in un solo passaggio.
Nell’inferenza LLM, la separazione tra elaborazione del contesto e generazione progressiva dell’output è fondamentale per capire dove si concentra il lavoro computazionale.
Per i modelli autoregressivi è utile distinguere due fasi dell’inferenza LLM: prefill e decode. Nel prefill viene elaborato il contesto iniziale; nel decode vengono invece generati progressivamente i nuovi token.
Prefill: cosa succede quando il modello elabora il prompt
Durante il prefill il modello elabora i token presenti nell’input.
Se hai inviato una domanda, un documento, un lungo system prompt o una conversazione precedente, questa fase serve a elaborare il contesto disponibile prima della generazione dei nuovi token.
Nei Transformer utilizzati per molti LLM viene inoltre costruita o popolata la KV cache, una struttura che conserva informazioni intermedie necessarie all’attenzione e consente di evitare di ricalcolare da zero tutto il contesto per ogni token successivo.
Il prefill tende a sfruttare bene il parallelismo computazionale perché molti token dell’input possono essere elaborati insieme.
Un prompt molto lungo, però, richiede più lavoro rispetto a uno corto. È uno dei motivi per cui la lunghezza del contesto può incidere sulla latenza prima che inizi a comparire la risposta.
Questa fase dell’inferenza LLM incide quindi soprattutto sul lavoro necessario a elaborare il contesto disponibile prima che inizi la generazione dell’output.
Decode: perché l’output viene generato token dopo token
Dopo il prefill comincia il decode.
Il modello calcola una distribuzione sulle possibili continuazioni e viene selezionato il token successivo. Quel token entra a sua volta nella sequenza usata per calcolare quello seguente.
Il processo continua:
contesto → token 1 → token 2 → token 3 → …
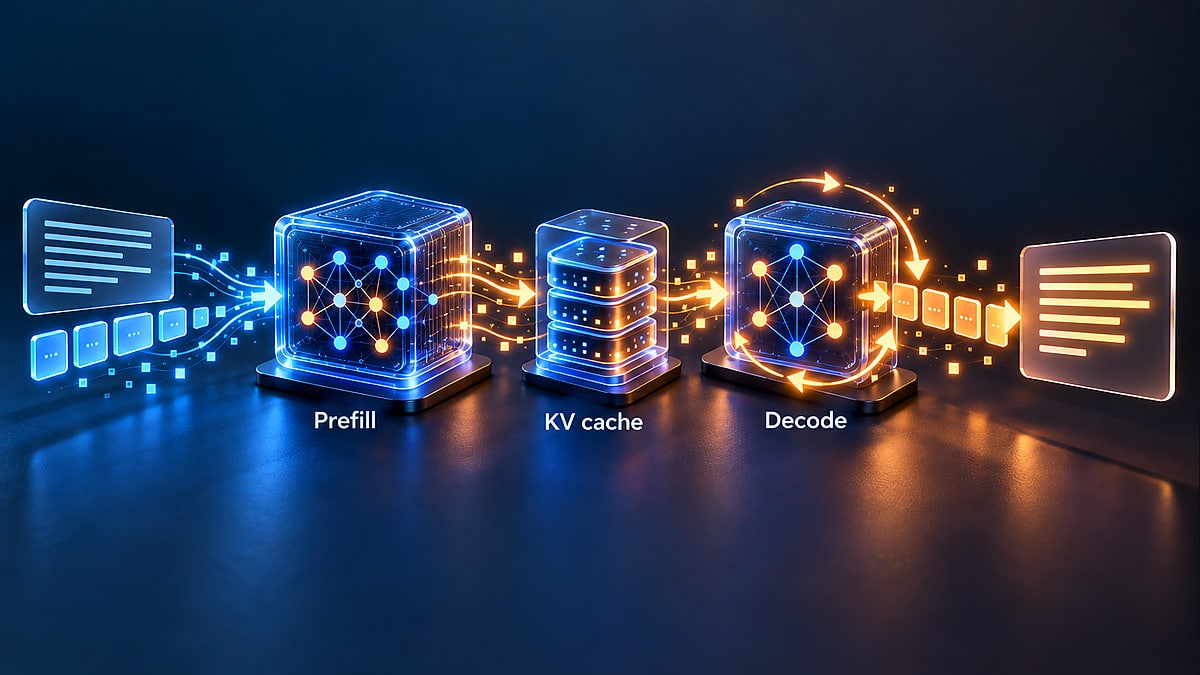
Questa natura autoregressiva rende il decode diverso dal prefill. I nuovi token dipendono dalla sequenza già disponibile e vengono prodotti progressivamente.
È anche il motivo per cui una risposta può iniziare rapidamente ma richiedere ancora parecchio tempo per terminare: tempo al primo token e tempo complessivo di generazione non sono la stessa metrica.
Nell’inferenza AI generativa questa distinzione è importante perché due sistemi possono avere comportamenti molto diversi pur utilizzando lo stesso modello.
Perché contesto e lunghezza della risposta incidono sulle prestazioni
Due richieste allo stesso modello possono avere costi e tempi diversi.
Un prompt breve con una risposta di poche righe è un workload differente da un documento molto lungo che deve produrre migliaia di token.
La lunghezza dell’input incide soprattutto sul lavoro necessario per elaborare il contesto. La lunghezza dell’output aumenta invece il numero di iterazioni di decode.
A questo si aggiungono concorrenza, dimensione del modello, hardware, gestione della memoria, batching e implementazione del sistema di serving.
Per questo una frase come “questo modello è veloce” è poco informativa se non specifichiamo in quale workload e rispetto a quale metrica.
Inferenza batch, in tempo reale ed edge: cosa cambia
Non esiste un unico modo corretto di eseguire inferenza AI.
La modalità appropriata dipende principalmente da quanto è urgente il risultato, dal volume di richieste, dall’hardware disponibile e dal luogo in cui devono essere elaborati i dati.
| Modalità | Quando è utile | Vantaggio principale | Trade-off |
|---|---|---|---|
| Batch | molti input disponibili insieme, risultato non urgente | efficienza e throughput | risposta non immediata |
| Real time | interazioni o decisioni sensibili alla latenza | risposta rapida | capacità pronta e costi operativi |
| Asincrona | richieste lunghe o pesanti che non richiedono risposta immediata | gestione flessibile di workload complessi | risultato differito |
| Edge/on-device | dati o decisioni vicino alla sorgente | latenza, autonomia, privacy | risorse locali più limitate |
La differenza non riguarda ciò che il modello “sa”. Riguarda come viene messo a disposizione.
La distinzione fra inferenza real-time, batch e asincrona riflette infatti esigenze diverse del workload: risposta immediata, elaborazione offline di grandi volumi oppure gestione in coda di richieste lunghe e pesanti.
Inferenza batch
L’inferenza batch raggruppa molti input e li elabora insieme.
È adatta quando non serve una risposta immediata. Un’azienda potrebbe, per esempio, classificare durante la notte un grande archivio di documenti o calcolare previsioni su un insieme di dati già disponibile.
In un workload di questo tipo, l’inferenza batch permette di privilegiare l’efficienza complessiva rispetto al tempo di risposta della singola richiesta.
Il vantaggio è che le risorse possono essere sfruttate con maggiore efficienza. Il sistema non deve necessariamente mantenere un endpoint sempre pronto a rispondere in pochi millisecondi.
Il limite è evidente: se un utente sta aspettando la risposta, una procedura pianificata che verrà completata più tardi non risolve il problema.
Per questo l’inferenza batch è particolarmente adatta quando il valore deriva dalla capacità di elaborare molti elementi in modo efficiente e non dalla risposta immediata al singolo input.
Batch non significa quindi “inferenza lenta”. Significa che la priorità è elaborare un volume di lavoro, non rispondere immediatamente a ogni singola richiesta.
Inferenza online e in tempo reale
L’inferenza in tempo reale serve quando l’output deve arrivare con una latenza compatibile con l’interazione o la decisione da prendere.
Chatbot, sistemi di raccomandazione durante la navigazione, rilevamento di anomalie e alcune applicazioni industriali possono richiedere un endpoint pronto a elaborare gli input appena arrivano.
Per l’inferenza in tempo reale, il tempo percepito dalla singola richiesta diventa quindi una parte essenziale della qualità del servizio.
Qui il problema cambia.
Non basta massimizzare quante richieste possono essere elaborate complessivamente. Bisogna anche controllare quanto attende il singolo utente, come si comporta il sistema durante i picchi e quale capacità mantenere disponibile.
Nell’inferenza in tempo reale, quindi, la capacità di sostenere il carico deve essere valutata insieme alla latenza delle singole richieste.
Tra batch e real time esistono inoltre modalità asincrone: la richiesta viene accettata e messa in coda, mentre il risultato viene restituito quando l’elaborazione è terminata.
Sono utili per workload troppo lunghi o pesanti per una normale risposta interattiva ma che non richiedono nemmeno una grande elaborazione batch pianificata.
La modalità di inferenza AI va quindi scelta in funzione del workload e del tempo entro il quale il risultato deve essere disponibile.
Inferenza edge e on-device
L’inferenza non deve necessariamente avvenire in un grande data center remoto.
Con l’edge inference il calcolo viene portato vicino alla sorgente dei dati. Con l’inferenza on-device il modello viene eseguito direttamente sul dispositivo finale.
Un sistema di visione industriale può elaborare immagini vicino alla macchina che le produce. Uno smartphone può eseguire localmente determinate funzioni di riconoscimento o generazione. Un dispositivo può continuare a funzionare anche con connettività limitata.
I vantaggi possono includere latenza ridotta, minore dipendenza dalla rete e un controllo differente sui dati.
Il rovescio della medaglia è la disponibilità di risorse. Memoria, capacità di calcolo, consumo energetico e dimensione del modello diventano vincoli molto più importanti rispetto a un’infrastruttura cloud scalabile.
Edge, cloud e on-device non sono quindi categorie che stabiliscono quale AI sia “migliore”. Sono scelte architetturali.
Come si valutano prestazioni e costo dell’inferenza
Valutare le prestazioni dell’inferenza AI significa prima di tutto stabilire che cosa stiamo misurando.
Per un classificatore che deve rispondere a una richiesta alla volta può interessare soprattutto la latenza. Per un sistema che elabora milioni di record può contare di più il throughput. Per un LLM interattivo diventano rilevanti sia il tempo prima che compaia il primo token sia la velocità con cui vengono generati quelli successivi.
Ottimizzare una sola metrica può peggiorarne un’altra.
Latenza, throughput e Time to First Token
La latenza misura quanto tempo trascorre fra una richiesta e il relativo risultato, anche se la definizione esatta va sempre specificata nel benchmark.
Il throughput misura invece quanto lavoro il sistema riesce a processare in un determinato intervallo: richieste al secondo, elementi elaborati, token al secondo o altre unità coerenti con il workload.
Negli LLM in streaming è utile anche il Time to First Token (TTFT), cioè il tempo che l’utente attende prima di ricevere il primo token della risposta.
Un sistema può avere un buon throughput aggregato ma una latenza poco adatta a un’applicazione interattiva. Oppure può offrire una risposta iniziale molto rapida ma generare lentamente una risposta lunga.
Non esiste quindi una generica “velocità dell’AI”.
Esistono metriche diverse che descrivono fasi e obiettivi differenti.
Hardware, batching e quantizzazione
L’hardware incide perché l’inferenza AI richiede operazioni matematiche e accesso continuo ai parametri e alle rappresentazioni intermedie del modello.
CPU, GPU, TPU, NPU e altri acceleratori hanno caratteristiche differenti. La scelta dipende dal modello, dal workload, dalla scala e dall’ambiente in cui deve funzionare.
Anche il batching cambia il comportamento del sistema.
Elaborare più richieste insieme può aumentare l’utilizzo dell’hardware e il throughput. Se però aspettiamo troppo per formare batch più grandi possiamo peggiorare la latenza delle singole richieste.
Nei server per LLM viene utilizzato anche il continuous batching, che permette di gestire dinamicamente richieste che iniziano e terminano in momenti differenti.
Un’altra tecnica comune è la quantizzazione, che rappresenta pesi o altre componenti con precisione numerica inferiore. L’obiettivo può essere ridurre memoria e costo computazionale e consentire configurazioni più efficienti.
Non è però una scorciatoia gratuita: il compromesso fra precisione, memoria, velocità e qualità deve essere misurato sul modello e sul task reali.
Perché non esiste una configurazione di inferenza migliore in assoluto
Immagina due applicazioni.
La prima genera report durante la notte su milioni di record. La seconda completa il codice mentre uno sviluppatore scrive.
Per la prima può essere razionale massimizzare throughput ed efficienza anche accettando tempi di attesa elevati per la singola unità di lavoro.
Per la seconda qualche secondo aggiuntivo può rendere l’esperienza fastidiosa anche se il server, nel complesso, è estremamente efficiente.
Un sistema locale può inoltre accettare un modello più piccolo per ottenere privacy, autonomia e latenza prevedibile. Un servizio cloud può preferire modelli più grandi e distribuire il workload fra molti acceleratori.
La domanda corretta non è quindi:
Qual è l’inferenza più veloce?
È:
Quale configurazione di inferenza AI offre il miglior compromesso fra qualità, latenza, throughput, capacità, costo e vincoli del mio caso d’uso?
È questa la domanda che trasforma l’ottimizzazione da gara di benchmark a decisione architetturale.
Esempi di inferenza AI nella pratica
L’inferenza AI è presente quasi ogni volta che un modello addestrato viene utilizzato per produrre un risultato su un nuovo input.
Vederla in contesti differenti aiuta a capire che non appartiene soltanto all’AI generativa.
Classificazione, previsioni e rilevamento delle anomalie
Un filtro antispam riceve una nuova email e stima se appartenga alla categoria spam.
Un modello finanziario riceve nuove variabili e produce una stima.
Un sistema industriale analizza i segnali provenienti da un macchinario e calcola la probabilità di un comportamento anomalo.
In tutti questi casi la struttura generale rimane:
nuovi dati → modello addestrato → output
Il modello può essere molto semplice o estremamente complesso. Ciò che rende il processo inferenza AI è l’utilizzo operativo di ciò che è stato appreso in precedenza.
Raccomandazioni e sistemi decisionali
Un sistema di raccomandazione può utilizzare informazioni disponibili su utenti, prodotti e interazioni per assegnare punteggi agli elementi candidati.
Il risultato dell’inferenza non deve necessariamente essere mostrato direttamente.
Un’applicazione può usare quei punteggi per ordinare prodotti, scegliere contenuti da proporre o attivare un passaggio successivo del workflow.
Lo stesso principio vale per sistemi decisionali più complessi: l’inferenza del modello può essere un componente della decisione, non l’intera decisione.
Questo è particolarmente importante in processi sensibili, dove regole, controlli o supervisione umana possono essere necessari dopo l’output del modello.
Chatbot, LLM e generazione di contenuti
Quando invii un prompt a un modello linguistico, l’inferenza AI comprende l’elaborazione del contesto e la generazione progressiva dell’output.
Ma il prodotto che utilizzi può fare molto di più.
Può recuperare documenti, cercare informazioni, leggere una memoria, chiamare strumenti, applicare filtri o eseguire altre operazioni prima e dopo la generazione.
Per questo non conviene attribuire automaticamente al modello qualsiasi funzione osservata nell’applicazione.
L’inferenza spiega come il modello produce il proprio output. Il sistema completo spiega invece come quell’output viene inserito in un processo che può comprendere dati, memoria, software e azioni esterne.
È una distinzione piccola solo in apparenza. Una volta compresa, diventa molto più semplice orientarsi fra modelli, chatbot, RAG, agenti e infrastrutture AI senza trattarli come sinonimi.
Conclusione
L’inferenza AI è il passaggio che porta un modello dall’addestramento all’utilizzo reale: riceve nuovi input, applica i parametri già appresi e produce un risultato.
Ma fermarsi a questa definizione lascia fuori la parte più utile.
Inferenza non significa automaticamente apprendimento. Retrieval e memoria possono cambiare il contesto senza modificare i parametri. Un LLM elabora inoltre il prompt e genera l’output attraverso fasi con caratteristiche computazionali differenti. Batch, real time, asincrono, edge e on-device rispondono a esigenze diverse. Latenza e throughput misurano problemi diversi.
Per questo il modo più utile di ragionare sull’inferenza AI non è chiedersi semplicemente quanto sia potente un modello.
Bisogna chiedersi quale output deve produrre, con quale qualità, in quanto tempo, per quante richieste, su quale infrastruttura e con quali vincoli.
È in quel passaggio che l’inferenza smette di essere una definizione tecnica e diventa una decisione concreta su come utilizzare davvero un sistema di intelligenza artificiale.