
Il machine learning, o apprendimento automatico, è un approccio che consente di addestrare un software — il modello — usando dati ed esempi, invece di descrivere manualmente tutte le regole necessarie per ottenere un risultato. Una volta addestrato, il modello può usare ciò che ha appreso per classificare nuovi dati, stimare valori, individuare schemi, formulare previsioni o, nel caso dei sistemi generativi, produrre nuovi contenuti. È questa la definizione operativa adottata anche nell’attuale introduzione di Google al machine learning.
C’è però una precisazione importante: una macchina non “impara” nello stesso modo in cui impara una persona e un modello non migliora automaticamente ogni volta che riceve nuovi dati. Il risultato dipende da come viene definito il problema, dalla qualità dei dati, dalla procedura di addestramento, dalla valutazione e da ciò che accade dopo il deployment.
Capire il machine learning significa quindi andare oltre l’idea generica della “macchina che impara”. Bisogna capire che cosa viene appreso, da quali dati, come si verifica se il modello funziona davvero e in quali situazioni sarebbe meglio non usarlo affatto.
Cos’è il machine learning e in che cosa consiste
In un programma tradizionale, uno sviluppatore definisce in modo esplicito le regole che trasformano gli input in un risultato. Se devi calcolare l’IVA su un importo, per esempio, puoi scrivere una formula precisa: non serve alcun apprendimento.
Con il machine learning la logica cambia. Invece di specificare tutte le regole, fornisci al sistema dati dai quali possa stimare una relazione utile.
Immagina di voler riconoscere automaticamente le email indesiderate. Potresti provare a scrivere manualmente centinaia di condizioni: presenza di determinate parole, numero di link, mittente, struttura del testo e così via. Il problema è che gli schemi cambiano e le combinazioni possibili diventano rapidamente difficili da gestire.
Un approccio di apprendimento automatico può invece essere addestrato su esempi già classificati come spam e non spam. Durante il training, il modello cerca relazioni statistiche fra le caratteristiche degli esempi e il risultato desiderato. Successivamente può applicare ciò che ha appreso a messaggi che non aveva mai visto.
Il punto decisivo è la generalizzazione: non interessa costruire un sistema capace di ricordare perfettamente gli esempi del training. Deve riuscire a comportarsi bene anche su casi nuovi.
Machine learning, intelligenza artificiale e deep learning: le differenze
Machine learning e intelligenza artificiale non sono sinonimi.
L’intelligenza artificiale è il campo più ampio e comprende differenti modi di costruire sistemi capaci di svolgere attività che associamo a forme di comportamento intelligente. Il machine learning è uno degli approcci utilizzati all’interno di questo campo: invece di basarsi esclusivamente su regole definite in anticipo, utilizza dati per addestrare modelli.
Il deep learning è a sua volta una parte del machine learning basata su reti neurali con più livelli di elaborazione. Ha assunto un ruolo centrale in ambiti come computer vision, riconoscimento vocale, elaborazione del linguaggio e sistemi generativi. Se vuoi approfondire questo livello, nella guida dedicata spieghiamo cos’è il deep learning e come funziona.
La relazione può quindi essere letta così: l’AI è il campo generale; il machine learning è una famiglia di approcci basati sull’apprendimento dai dati; il deep learning è una famiglia di tecniche di machine learning basata sulle reti neurali profonde.
Algoritmo, modello, training e inferenza: quattro concetti da non confondere
Nelle spiegazioni introduttive algoritmo e modello vengono spesso trattati come se indicassero la stessa cosa. La distinzione aiuta invece a capire che cosa succede realmente.
Un algoritmo di apprendimento descrive il procedimento utilizzato per ricavare una soluzione dai dati. Il modello è il risultato parametrizzato che viene ottenuto attraverso l’addestramento e che può successivamente produrre un output a partire da nuovi input. Nel glossario di Google, un modello viene descritto come la struttura e l’insieme dei parametri necessari per produrre previsioni.
Il training è il processo durante il quale questi parametri vengono determinati o modificati in funzione dei dati e dell’obiettivo.
L’inferenza, invece, avviene quando il modello già addestrato riceve nuovi dati e produce una classificazione, una previsione o un altro tipo di risultato.
È una distinzione semplice, ma evita un equivoco frequente: il modello che stai utilizzando in produzione non deve necessariamente essere in fase di apprendimento. Può essere stato addestrato in precedenza e limitarsi a eseguire inferenze fino al successivo ciclo di aggiornamento.
Come funziona il machine learning: dai dati alle previsioni
Un progetto di machine learning non comincia scegliendo l’algoritmo più sofisticato. Comincia da una domanda: quale problema stiamo cercando di risolvere e quale risultato vogliamo ottenere?
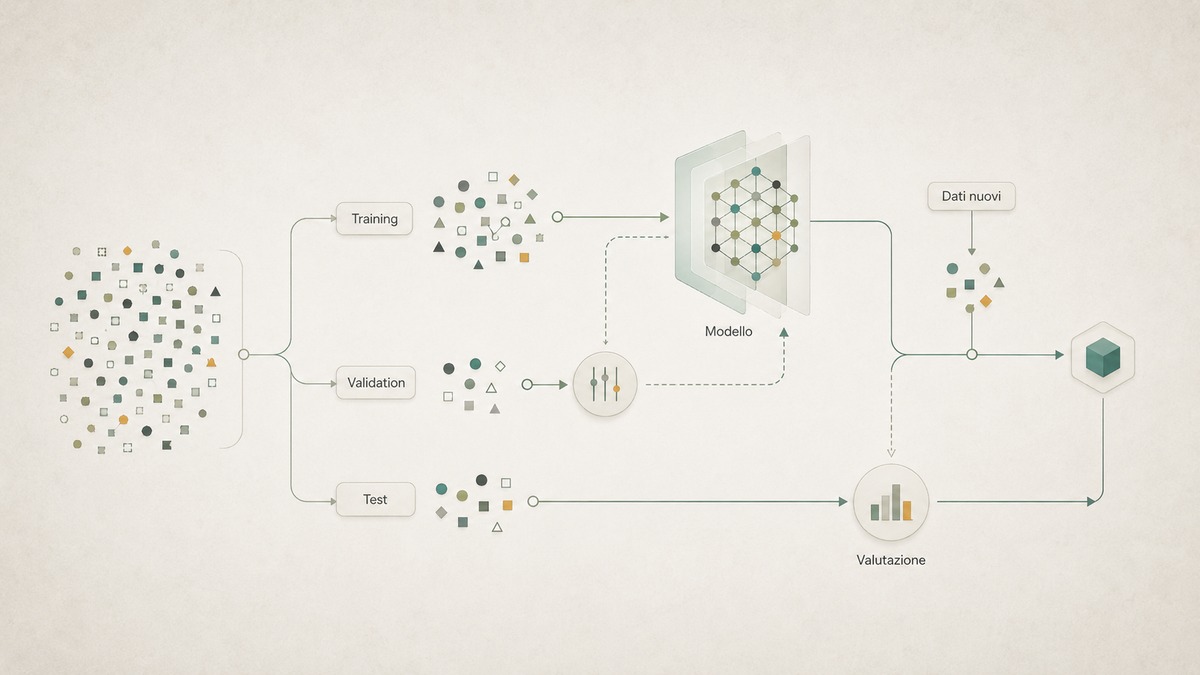
Da qui nasce una pipeline che, in forma semplificata, passa dalla definizione del problema ai dati, dall’addestramento alla valutazione e infine all’utilizzo del modello.
Dati, feature e obiettivo del modello
Supponiamo di voler stimare il prezzo di una casa. Il dataset potrebbe contenere superficie, zona, numero di stanze, anno di costruzione e prezzo delle abitazioni già vendute.
Le variabili utilizzate dal modello come input vengono normalmente chiamate feature. Il valore che vogliamo prevedere costituisce invece il target o, nel supervised learning, la label.
Durante l’addestramento non stiamo fornendo al sistema una formula già pronta. Stiamo chiedendo all’algoritmo di individuare una relazione utile fra input e risultato.
Questo è anche il motivo per cui avere più dati non significa automaticamente avere un modello migliore. Se i dati contengono errori, rappresentano male il fenomeno reale, sono raccolti con criteri incoerenti o includono informazioni che in produzione non saranno disponibili, possono produrre un sistema apparentemente preciso ma poco affidabile.
La preparazione del dataset non è quindi un passaggio preliminare da liquidare velocemente: fa parte del problema di machine learning.
Training, validation e test: perché servono set separati
Per capire se il modello ha realmente imparato qualcosa di utile non è sufficiente misurare quanto riesce a riprodurre gli esempi utilizzati per addestrarlo.
Una procedura comune separa i dati in training set, validation set e test set. La documentazione Google sulla suddivisione dei dataset sottolinea che un modello deve essere valutato su esempi diversi da quelli utilizzati nel training.
Il training set viene usato per apprendere i parametri del modello. Il validation set aiuta a confrontare configurazioni, scegliere iperparametri e prendere decisioni durante lo sviluppo. Il test set dovrebbe restare separato fino alla valutazione finale, in modo da fornire un controllo più credibile su dati che non hanno guidato le scelte precedenti.
Non esiste però una percentuale di suddivisione universale valida per qualsiasi progetto. La strategia dipende dalla quantità dei dati, dalla loro struttura, dalla dimensione temporale e dal problema che stai affrontando.
Con dataset piccoli può essere utile ricorrere alla cross-validation; con serie temporali, invece, una divisione casuale potrebbe addirittura contaminare il test con informazioni provenienti dal futuro.
Generalizzazione, overfitting e data leakage
Il vero obiettivo non è ottenere il miglior risultato possibile sul training set, ma generalizzare.
L’overfitting si verifica quando un modello si adatta troppo agli esempi utilizzati durante il training e perde capacità di funzionare su dati nuovi. Può quindi mostrare prestazioni eccellenti in fase di addestramento e deteriorarsi quando viene utilizzato nel mondo reale.
Un altro problema particolarmente insidioso è il data leakage. Avviene quando durante la costruzione del modello vengono utilizzate informazioni che, nel momento reale della previsione, non sarebbero disponibili.
Immagina un modello che deve prevedere se un cliente annullerà un abbonamento. Se fra le feature inserisci per errore una variabile registrata soltanto dopo la cancellazione, il modello potrebbe sembrare eccezionalmente preciso durante il test. In realtà sta sfruttando un’informazione impossibile da conoscere nel momento in cui dovrebbe fare la previsione.
La documentazione di scikit-learn sui problemi comuni nelle pipeline tratta esplicitamente il leakage e raccomanda di separare correttamente training e test anche durante preprocessing e trasformazioni.
Questo esempio chiarisce un principio importante: una metrica molto alta non dimostra da sola che un modello sia buono. Prima bisogna capire come è stata ottenuta.
Inferenza, monitoraggio e data drift
Quando il modello supera la fase di valutazione può essere integrato in un’applicazione, un servizio, una pipeline aziendale o un altro sistema. Da quel momento inizia la fase di inferenza sui dati reali.
Ma il deployment non conclude il progetto.
I dati utilizzati nel mondo reale possono cambiare. Cambiano comportamenti degli utenti, prodotti, condizioni economiche, sensori, processi aziendali e perfino il modo in cui le informazioni vengono raccolte.
Quando la distribuzione dei dati si sposta rispetto a quella utilizzata durante lo sviluppo si parla, in senso generale, di data drift. In altri casi può cambiare proprio la relazione fra input e risultato.
Per questo i sistemi ML in produzione richiedono monitoraggio. Google raccomanda di controllare, tra gli altri aspetti, qualità dei dati, feature, skew fra training e serving, età del modello e prestazioni osservabili nel mondo reale.
Il modello non “si accorge” necessariamente del cambiamento e non si riaddestra da solo. L’apprendimento continuo esiste, ma deve essere progettato come parte dell’architettura e introduce a sua volta controlli e rischi.
I principali tipi di machine learning
Le classificazioni del machine learning non sono perfettamente univoche perché possono descrivere dimensioni differenti del processo di apprendimento.
Nella sua introduzione corrente Google presenta supervised learning, unsupervised learning, reinforcement learning e generative AI come categorie utili per orientarsi. Altre tassonomie distinguono inoltre semi-supervised e self-supervised learning. Non vanno però immaginate necessariamente come caselle completamente separate: alcune tecniche possono combinarsi all’interno dello stesso sistema.
Apprendimento supervisionato
Nell’apprendimento supervisionato il modello viene addestrato con esempi che comprendono sia gli input sia il risultato atteso.
Se mostri al sistema migliaia di transazioni accompagnate dall’informazione “frode” o “legittima”, il modello può cercare le relazioni che aiutano a distinguere le due classi e successivamente applicarle a nuove transazioni.
I due problemi classici sono classificazione e regressione. Nel primo caso vogliamo prevedere una categoria; nel secondo un valore numerico.
È una delle aree più importanti dell’apprendimento automatico e merita un approfondimento autonomo: abbiamo dedicato una guida specifica al funzionamento del supervised learning.
Apprendimento non supervisionato
Nell’unsupervised learning non disponiamo della risposta corretta associata a ogni esempio. Chiediamo invece al sistema di individuare strutture utili all’interno dei dati.
Un caso classico è il clustering: raggruppare elementi che risultano simili secondo determinate caratteristiche. Potresti, per esempio, analizzare un insieme di clienti senza aver definito a priori i segmenti e cercare gruppi con comportamenti comparabili.
Fra gli utilizzi rientrano anche riduzione della dimensionalità, individuazione di strutture latenti e alcune tecniche di novelty o anomaly detection. La documentazione corrente di scikit-learn include clustering, decomposizione, density estimation e rilevamento di outlier fra le principali famiglie di metodi non supervisionati.
Non significa però che il sistema “comprenda” autonomamente il significato dei gruppi trovati. Il passaggio da una struttura matematica a un’interpretazione utile richiede ancora contesto e conoscenza del dominio.
Apprendimento per rinforzo
Nel reinforcement learning un agente interagisce con un ambiente, sceglie azioni e riceve segnali di ricompensa. L’obiettivo è apprendere una politica che massimizzi il ritorno atteso nel tempo.
La differenza rispetto al supervised learning è sostanziale. Non stiamo fornendo al modello una risposta corretta per ogni situazione: le conseguenze delle azioni contribuiscono a definire ciò che il sistema dovrebbe imparare.
Questo approccio è adatto a problemi sequenziali nei quali una decisione modifica lo stato successivo: controllo, robotica, giochi e alcuni problemi di ottimizzazione dinamica sono esempi tipici.
Anche qui bisogna evitare una semplificazione: “ricompensa” non significa necessariamente apprendimento semplice per tentativi casuali. Progettare stato, azioni, funzione di reward, politica ed esplorazione può diventare molto complesso.
Semi-supervised, self-supervised e AI generativa: dove si collocano
Nella realtà moderna esistono molti casi in cui la distinzione supervisionato/non supervisionato non basta.
Nel semi-supervised learning una parte degli esempi dispone di etichette e una parte no. È utile, per esempio, quando ottenere grandi quantità di dati è relativamente semplice ma etichettarli richiede lavoro umano costoso.
Il self-supervised learning costruisce invece un segnale di supervisione direttamente dai dati non etichettati, creando obiettivi intermedi o surrogate label. È una famiglia di tecniche importante nell’addestramento di molti modelli moderni.
L’AI generativa aggiunge un altro livello al quadro. Qui l’obiettivo del modello non è soltanto assegnare una categoria o prevedere un numero, ma generare nuovi output — per esempio testo, immagini, audio o codice — sulla base delle strutture apprese.
I moderni Large Language Model sono un esempio evidente del collegamento fra machine learning, deep learning, pretraining e sistemi generativi. Questo non rende però obsolete le tecniche tradizionali: per moltissimi problemi aziendali una regressione, un albero decisionale o un modello di boosting possono essere più appropriati di un grande modello generativo.
Algoritmi e modelli di machine learning: quali problemi risolvono
Chiedersi “qual è il miglior algoritmo di machine learning?” senza specificare il problema è poco utile.
La scelta dipende dal tipo di output, dai dati disponibili, dalla necessità di interpretare il risultato, dai costi computazionali, dagli errori più importanti per il caso d’uso e dalle condizioni in cui il modello dovrà funzionare.
Classificazione e regressione
La classificazione serve a prevedere una classe o categoria. Spam/non spam, frode/non frode e tipologia di documento sono esempi intuitivi.
La regressione mira invece a stimare un valore continuo: domanda prevista, consumo energetico, durata di un processo o prezzo atteso.
Per questi problemi esistono famiglie molto differenti di algoritmi: modelli lineari, nearest neighbors, support vector machine, alberi decisionali, ensemble e reti neurali, fra gli altri. Scikit-learn mantiene una panoramica molto ampia degli algoritmi di supervised learning disponibili.
La metrica deve seguire il problema. L’accuracy, per esempio, può essere fuorviante quando una classe è molto rara. In un sistema antifrode potresti avere un numero enorme di transazioni legittime e pochissime frodi: un modello che dichiara sempre “legittima” avrebbe un’accuracy apparentemente elevata ma nessuna utilità.
Precision, recall, F1, ROC-AUC e altre metriche rispondono a domande diverse. La scelta corretta dipende soprattutto dal costo dei falsi positivi e dei falsi negativi.
Clustering e rilevamento delle anomalie
Quando non esiste un target esplicito, il problema può consistere nel trovare strutture.
Il clustering può essere utilizzato per esplorare segmenti, raggruppare documenti o individuare configurazioni ricorrenti. L’anomaly detection cerca invece osservazioni che si discostano dal comportamento considerato normale.
È importante non confondere i due obiettivi. Un cluster descrive una struttura di somiglianza; un’anomalia è un caso che risulta inconsueto secondo il modello o la distribuzione considerata.
Nel business questi strumenti possono essere combinati con l’analisi predittiva, ma il valore arriva quando il pattern matematico viene collegato a una decisione concreta.
Alberi, ensemble e reti neurali: famiglie diverse per problemi diversi
Gli alberi decisionali suddividono progressivamente lo spazio dei dati attraverso condizioni sulle feature. Sono intuitivi e possono offrire un buon livello di interpretabilità, anche se un singolo albero può essere instabile o adattarsi troppo ai dati.
Metodi ensemble come random forest e gradient boosting combinano più modelli per ottenere prestazioni generalmente più robuste in numerosi problemi su dati tabellari.
Le reti neurali utilizzano invece strati di unità interconnesse e parametri ottimizzati durante il training. Aumentando profondità, dimensione e architettura si entra nel territorio del deep learning.
Non esiste una gerarchia in cui il modello più complesso è automaticamente il migliore. Un algoritmo semplice può essere preferibile quando raggiunge risultati adeguati con meno dati, minori costi, maggiore velocità o maggiore interpretabilità.
La scelta corretta parte dal problema, non dal prestigio della tecnologia.
Esempi di machine learning nella pratica
Il machine learning diventa molto più semplice da comprendere quando si osserva il rapporto fra dato disponibile → pattern da apprendere → decisione da supportare.
Raccomandazioni e personalizzazione
Un sistema di raccomandazione cerca di stimare quali elementi potrebbero essere rilevanti per un determinato utente.
Può combinare segnali legati al comportamento individuale con informazioni su prodotti, contenuti e comportamenti di utenti simili. Il risultato non deve essere necessariamente “indovinare cosa vuole una persona”, ma ordinare un insieme di alternative in modo più utile rispetto a una sequenza generica.
Lo stesso principio può essere applicato a ecommerce, contenuti editoriali, musica, video e altri cataloghi molto estesi.
La difficoltà vera arriva con gli utenti nuovi, i prodotti nuovi, i feedback impliciti e i cosiddetti feedback loop: ciò che il sistema raccomanda modifica infatti ciò che le persone vedranno e quindi i dati raccolti successivamente. Google include esplicitamente i feedback loop fra i problemi da valutare nei sistemi ML in produzione.
Frodi, anomalie e manutenzione predittiva
Nei sistemi antifrode l’obiettivo può essere stimare il rischio associato a una transazione o evidenziare comportamenti insoliti da sottoporre a ulteriori controlli.
Nell’industria, i sistemi IoT possono raccogliere dati da sensori e combinarli con informazioni storiche per riconoscere condizioni associate a guasti o deterioramento. Non significa prevedere con certezza quando una macchina si romperà: significa stimare un rischio o individuare segnali che consentano di intervenire con maggiore informazione.
I modelli predittivi sono precisamente il punto in cui queste tecniche diventano strumenti per stimare risultati futuri o probabilità utili alla decisione.
In entrambi i casi, una buona metrica offline non basta. Bisogna misurare ciò che accade quando il sistema entra realmente nel processo operativo.
Immagini, linguaggio e sistemi generativi
Con immagini e audio, le reti neurali possono imparare rappresentazioni utili per classificazione, riconoscimento e rilevamento.
Sul linguaggio, il machine learning può supportare classificazione di testi, analisi semantica, traduzione, ricerca e generazione. I sistemi generativi moderni portano questo principio molto oltre, producendo sequenze, immagini o altri contenuti sulla base delle distribuzioni apprese durante il training.
Questo è un buon esempio di come il machine learning sia cambiato senza perdere i propri fondamenti. Dataset, obiettivo, training, valutazione e generalizzazione restano centrali anche quando il modello finale contiene miliardi di parametri.
Quando usare il machine learning e quando non serve
Uno degli errori più frequenti è trattare il machine learning come una soluzione da applicare a qualsiasi problema purché esistano dei dati.
In realtà, a volte non serve affatto.
I segnali che un problema è adatto al ML
L’apprendimento automatico diventa interessante quando esiste un risultato definibile, sono disponibili esempi o segnali informativi e la relazione fra input e output è troppo complessa o variabile per essere descritta comodamente con regole manuali.
È particolarmente utile quando il sistema deve generalizzare su molti casi: classificare documenti, stimare valori, riconoscere immagini, ordinare alternative, identificare anomalie o elaborare grandi quantità di informazioni con criteri coerenti.
Serve però anche un modo per misurare se il modello sta realmente migliorando il processo. “Usiamo l’AI” non è un obiettivo; ridurre errori di classificazione, riconoscere più rapidamente una determinata condizione o migliorare una previsione lo sono.
Quando regole deterministiche o analisi tradizionali sono una scelta migliore
Se il problema può essere risolto correttamente con una regola semplice, il machine learning può aggiungere complessità senza produrre valore.
Calcolare uno sconto, applicare un limite normativo, validare un formato o eseguire un flusso con condizioni completamente note sono esempi nei quali una soluzione deterministica può essere più trasparente e affidabile.
Lo stesso vale quando i dati sono troppo pochi, poco rappresentativi o difficili da trasformare in un target credibile.
Esiste poi un’altra domanda pratica: quanto costa sbagliare? In un sistema che suggerisce l’ordine dei prodotti di un catalogo possiamo accettare un certo livello di errore. In un processo che incide su diritti, sicurezza, salute o accesso a servizi essenziali, soglia di evidenza, supervisione e governance devono essere molto più elevate.
La scelta migliore non è quindi sempre “più AI”. È la soluzione meno complessa che riesce a soddisfare in modo affidabile il problema reale.
Limiti e rischi del machine learning
Un modello produce risultati sulla base dei dati, dell’obiettivo e delle scelte progettuali con cui è stato costruito. Non esiste una neutralità automatica derivante dal fatto che a decidere sia un algoritmo.
Qualità dei dati e bias
Se un dataset rappresenta male il contesto in cui il sistema dovrà operare, il modello può generalizzare male proprio sui casi che contano.
Il problema non riguarda soltanto quantità e pulizia. Conta quali gruppi, condizioni ed eventi sono rappresentati, come vengono definite le label, quali feature vengono utilizzate e quale funzione viene ottimizzata.
Un sistema può inoltre avere una buona prestazione media e contemporaneamente commettere molti più errori su un determinato sottogruppo.
Per questo i bias devono essere cercati e misurati lungo l’intero ciclo di sviluppo. Abbiamo approfondito separatamente il rapporto fra bias e intelligenza artificiale, perché ridurre il problema a “basta usare dati migliori” sarebbe insufficiente.
Spiegabilità, sicurezza e affidabilità
Alcuni modelli consentono di ricostruire con relativa facilità quali variabili hanno contribuito maggiormente a una previsione; altri sono molto più difficili da interpretare.
La spiegabilità diventa particolarmente importante quando una previsione deve essere contestata, verificata o utilizzata in processi ad alto impatto.
Anche l’affidabilità non può essere identificata con una singola metrica. Bisogna valutare robustezza ai dati fuori distribuzione, dipendenze della pipeline, cambiamenti nelle feature, stabilità e possibili errori sistematici.
Un modello può inoltre essere tecnicamente corretto ma inserito in un sistema fragile. Per questo, nei progetti reali, il modello è solo una parte del sistema di machine learning. Deployment, monitoraggio, dati, logging, versionamento e procedure operative contano almeno quanto la scelta dell’algoritmo.
Privacy, governance e AI Act nell’Unione europea
Quando i dati riguardano persone, il progetto deve considerare anche privacy, protezione delle informazioni e condizioni legali di utilizzo.
In Europa il quadro va letto anche alla luce dell’Artificial Intelligence Act. Il regolamento è applicato attraverso un calendario progressivo: molte disposizioni sono già operative, mentre alcune regole per i sistemi ad alto rischio seguono scadenze successive
Non significa che qualsiasi modello di machine learning sia automaticamente soggetto agli stessi obblighi. La classificazione dipende dal sistema, dall’uso previsto, dal ruolo dell’organizzazione e dal livello di rischio previsto dal regolamento.
Per un’impresa, quindi, la governance non dovrebbe entrare nel progetto dopo aver costruito il modello. Provenienza e qualità dei dati, responsabilità, documentazione, supervisione e modalità di utilizzo devono essere considerate fin dall’inizio quando il contesto lo richiede.
Come iniziare con il machine learning
Per capire realmente l’apprendimento automatico non è necessario partire da reti neurali enormi o infrastrutture cloud.
Un piccolo problema ben definito insegna molto di più di un progetto ambizioso in cui non è chiaro cosa il modello stia facendo.
Un primo esperimento senza codice
Per osservare direttamente il rapporto fra esempi, training e generalizzazione puoi utilizzare Teachable Machine, uno strumento web di Google ancora disponibile che permette di creare semplici modelli per immagini, suoni e pose senza programmare.
Puoi, per esempio, creare due categorie di immagini, raccogliere diversi esempi per ciascuna e addestrare un classificatore.
La parte interessante arriva dopo. Invece di provare il modello con le stesse immagini usate per il training, mostragli condizioni differenti: luce diversa, sfondo diverso, posizione diversa.
Se il sistema fallisce, hai già incontrato uno dei problemi fondamentali del machine learning: imparare gli esempi non significa necessariamente imparare il concetto che avevi in mente.
Python e scikit-learn per passare ai modelli reali
Quando vuoi passare al codice, Python offre un ecosistema particolarmente adatto al lavoro con dati e modelli.
Per il machine learning classico, scikit-learn permette di lavorare con preprocessing, classificazione, regressione, clustering, model selection e valutazione attraverso un’interfaccia coerente. La documentazione corrente include anche strumenti per pipeline e cross-validation che aiutano a costruire esperimenti in modo meno fragile.
Il primo progetto non deve essere complesso. È sufficiente scegliere un dataset comprensibile, definire un target, costruire una baseline semplice, separare correttamente i dati e valutare gli errori.
Questo permette di capire più cose di un modello avanzato usato come scatola nera.
Se Python è ancora nuovo per te, partire direttamente da scikit-learn aggiunge troppe cose contemporaneamente. Prima conviene saper scrivere ed eseguire piccoli programmi, usare strutture dati e funzioni, interpretare gli errori e gestire un ambiente virtuale. La guida per programmare in Python da zero copre proprio queste basi prima di passare alle librerie di machine learning.
Cosa imparare prima di inseguire framework e tool
La competenza più utile non consiste nel memorizzare i nomi degli algoritmi.
Serve capire che cosa rappresentano le feature, come viene costruito il target, quale metrica risponde al problema, cosa significa generalizzazione e come riconoscere leakage, overfitting e cambiamenti nei dati.
Solo dopo ha senso scegliere fra modelli lineari, alberi, ensemble, reti neurali o strumenti più specializzati.
Framework e librerie cambiano. Il modello mentale del processo resta molto più stabile: problema → dati → baseline → training → validation → test → deployment → monitoraggio.
Se questa sequenza è chiara, diventa molto più semplice valutare anche tecnologie nuove senza confondere una nuova interfaccia con un nuovo principio di apprendimento.
Lo stesso criterio vale quando si parla di computer quantistico e quantum machine learning. Una QPU elabora informazione attraverso qubit, ma questo non rende automaticamente migliore un modello di machine learning: un vantaggio esiste solo se uno specifico sottoproblema può sfruttare realmente un algoritmo quantistico e il risultato supera una baseline classica credibile considerando anche errori, costi e overhead. Per molti workload ML attuali CPU, GPU e acceleratori classici restano la scelta più pratica.
Conclusione
Il machine learning non è semplicemente un software che “impara da solo”. È un modo di costruire modelli capaci di ricavare relazioni dai dati e applicarle a casi nuovi.
Il criterio che separa un esperimento interessante da un sistema realmente utile è la generalizzazione. Un modello deve funzionare oltre i dati sui quali è stato costruito, con metriche coerenti con il problema e controlli adeguati quando il contesto cambia.
Questo spiega anche perché algoritmi sempre più complessi non rendono inutili le tecniche più semplici. Se devi prevedere un valore su dati tabellari, classificare una transazione o individuare un’anomalia, il modello migliore non è quello più nuovo: è quello che risolve il problema con il livello di accuratezza, affidabilità, interpretabilità e costo richiesto.
Per iniziare, quindi, non serve inseguire immediatamente l’ultimo modello di AI. Scegli un problema misurabile, costruisci un dataset che abbia senso, mantieni separata la valutazione e osserva come il modello si comporta sui casi che non ha mai visto. È lì che comincia davvero il machine learning.