
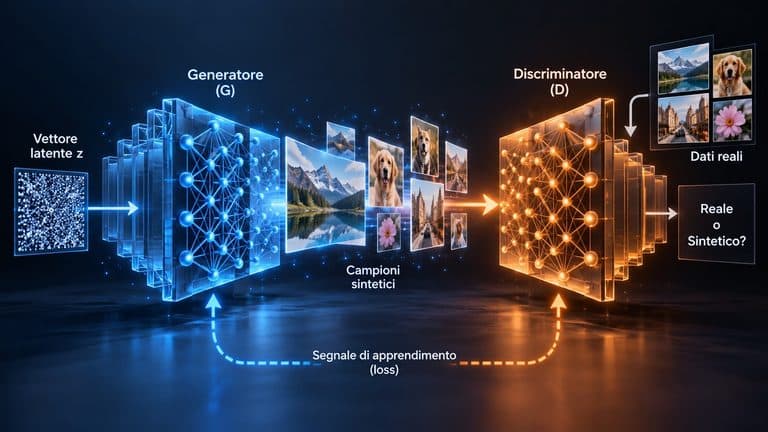
Le GAN, acronimo di Generative Adversarial Networks o reti generative avversarie, sono una famiglia di modelli generativi basata su un’idea particolare: invece di addestrare una sola rete neurale a creare nuovi dati, ne vengono addestrate due con obiettivi contrapposti.
Una rete, chiamata generatore, prova a produrre nuovi campioni simili ai dati reali. L’altra, il discriminatore, cerca invece di capire quali esempi provengono dal dataset e quali sono stati creati artificialmente. Il miglioramento nasce proprio da questa competizione.
Il framework è stato introdotto nel 2014 da Ian Goodfellow e coautori nel paper Generative Adversarial Nets. Nel modello originale, generatore e discriminatore vengono addestrati come partecipanti a un gioco minimax: il primo cerca di ingannare il secondo, mentre il secondo cerca di non farsi ingannare.
Questa idea ha avuto un impatto enorme soprattutto nella generazione e trasformazione delle immagini. Ma c’è una distinzione importante da fare subito: reti generative avversarie e AI generativa non sono sinonimi. Si tratta di una specifica famiglia di modelli all’interno di un ecosistema che oggi comprende anche VAE, diffusion model, Transformer e architetture ibride.
Per orientarti nella gerarchia, puoi partire dalla nostra guida al machine learning e poi approfondire il deep learning. È proprio in quest’ultima area che si colloca il paradigma adversarial: reti neurali profonde imparano a rappresentare una distribuzione di dati e a produrre nuovi esempi plausibili.
Cos’è una GAN e perché si chiama “avversaria”
Una GAN è un framework di machine learning generativo nel quale due modelli neurali vengono addestrati in competizione. Il NIST la descrive come un sistema in cui due reti partecipano a un gioco a somma zero e imparano, attraverso questa dinamica, a generare nuovi dati con caratteristiche statistiche simili a quelle del training set.
La parola adversarial, quindi, non indica che la rete sia malevola o che stia eseguendo un attacco informatico. Descrive la relazione tra i due componenti durante l’addestramento: gli obiettivi del generatore e del discriminatore si oppongono.
È proprio questa opposizione a rendere il metodo interessante. Il generatore non riceve semplicemente una regola statica che gli dica come debba apparire ogni output corretto. Deve migliorare abbastanza da superare un giudice che, contemporaneamente, sta imparando a riconoscere i suoi errori.
Generatore e discriminatore: le due reti in competizione
Il generatore, spesso indicato con G, produce i campioni sintetici.
Nella formulazione classica riceve come input un vettore casuale estratto da uno spazio latente e lo trasforma in un campione nello spazio dei dati: per esempio un’immagine. All’inizio gli output sono normalmente privi di struttura utile. Con l’addestramento, però, i parametri vengono modificati in modo da produrre esempi sempre più compatibili con la distribuzione osservata nei dati reali.
Il discriminatore, indicato normalmente con D, riceve invece sia esempi reali sia esempi creati artificialmente. Il suo compito è stimare da quale dei due insiemi provenga ciascun campione.
Se vuoi approfondire cosa significhi parlare di livelli, pesi, parametri e funzioni di attivazione, la base concettuale è spiegata nella guida alle reti neurali.
La parte interessante è che anche il discriminatore viene addestrato. Non è quindi un controllo fisso: mentre il generatore diventa più bravo a produrre esempi plausibili, il discriminatore diventa più bravo a riconoscerne le imperfezioni.
In termini semplici: un modello crea, l’altro valuta, ed entrambi modificano i propri parametri sulla base del risultato della competizione.
Dal rumore ai dati sintetici: cosa impara realmente il generatore
Dire che il generatore “parte dal rumore” può essere fuorviante se immagini un programma che modifica casualmente un’immagine reale finché non sembra diversa.
Il meccanismo classico è un altro.
Il modello riceve un vettore numerico z, campionato da una distribuzione semplice, e impara una funzione che trasforma quei valori in un esempio appartenente allo spazio dei dati che vogliamo modellare.
Possiamo rappresentarlo così:
vettore latente z → generatore G → campione sintetico
Durante il training deve quindi essere appresa una mappatura tra spazio latente e distribuzione dei dati.
Questo è anche il motivo per cui lo spazio latente è interessante: muovendosi nella rappresentazione interna possono emergere variazioni sistematiche negli output. In architetture come StyleGAN, il controllo e l’organizzazione di queste rappresentazioni sono diventati una parte centrale del modello.
Dove si colloca rispetto a reti neurali e deep learning
La relazione generale può essere schematizzata così:
Intelligenza artificiale → machine learning → deep learning → modelli generativi adversarial
Non tutte le reti neurali adottano questo approccio e non tutto il machine learning utilizza reti neurali.
Si tratta piuttosto di una modalità specifica di costruire e addestrare un sistema generativo, normalmente utilizzando modelli di deep learning come generatore e discriminatore.
È altrettanto importante non usare l’acronimo come sinonimo di qualsiasi modello generativo. Un VAE, un diffusion model o un modello autoregressivo possono produrre nuovi dati senza utilizzare la competizione che caratterizza questa famiglia.
Come funzionano le GAN durante l’addestramento
Per capire come funzionano le GAN, conviene separare il processo in due addestramenti collegati.
Il discriminatore deve migliorare nel distinguere i dati reali da quelli sintetici. Il generatore deve invece migliorare nel produrre campioni che il discriminatore consideri plausibili.
In forma concettuale, un ciclo di training funziona così:
- si estraggono alcuni esempi reali dal dataset;
- il generatore riceve vettori latenti e produce campioni sintetici;
- il discriminatore valuta esempi reali e generati;
- vengono aggiornati i parametri del discriminatore per migliorare la distinzione;
- viene valutata la capacità del generatore di ingannare il discriminatore;
- il gradiente viene propagato fino al generatore e i suoi parametri vengono aggiornati;
- il ciclo viene ripetuto con nuovi batch.
Il dettaglio importante non è memorizzare i sette passaggi, ma vedere la relazione causale: il criterio con cui il generatore viene giudicato dipende da un altro modello che cambia durante il training.
È una situazione molto diversa dall’ottimizzare una singola rete rispetto a un obiettivo completamente statico.
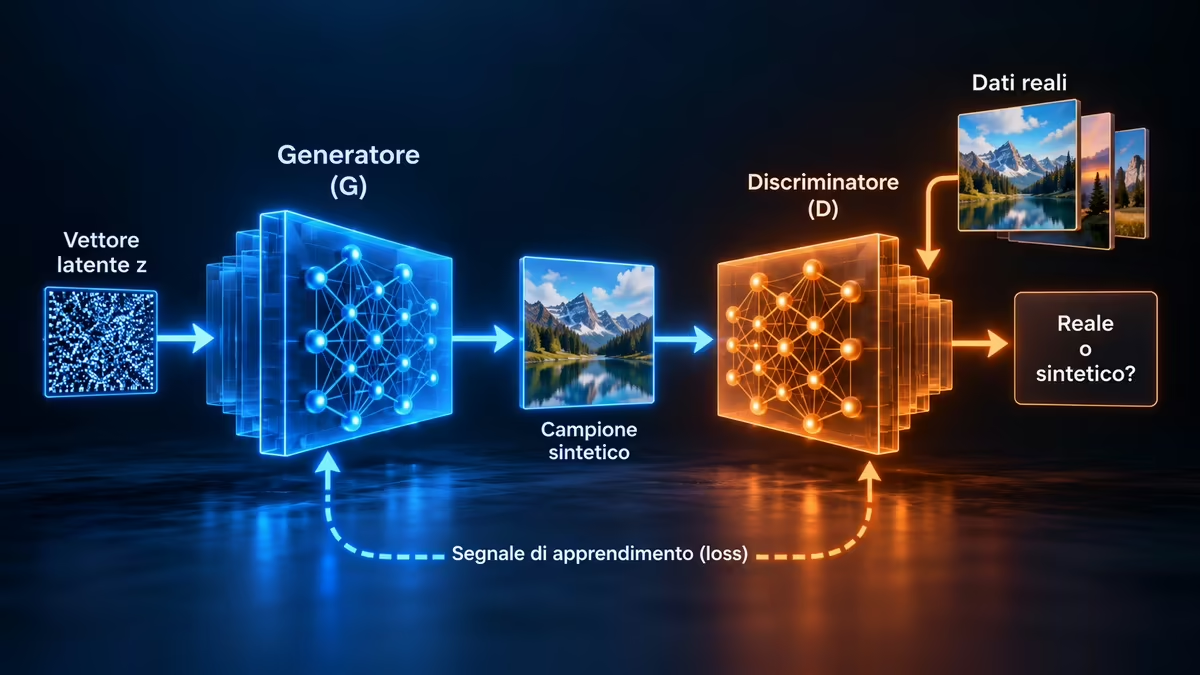
Il ciclo tra dati reali, generatore e discriminatore
Supponiamo di voler creare immagini appartenenti a un determinato dominio.
Il discriminatore riceve due flussi:
dataset → immagini reali → D
rumore → G → immagini sintetiche → D
Quando viene addestrato D, il sistema conosce l’origine dei campioni e può calcolare quanto bene il discriminatore stia separando esempi reali e artificiali.
Quando viene addestrato G, l’obiettivo cambia prospettiva: vogliamo che i campioni creati ottengano dal discriminatore una valutazione compatibile con quella dei dati reali.
Nel caso teorico ideale descritto dagli autori del lavoro originale, quando la distribuzione generata coincide con quella reale il discriminatore non ha più informazioni utili per distinguere le due.
Nella pratica, però, non si addestra il sistema aspettando semplicemente che il discriminatore arrivi al 50% di accuratezza. Le dinamiche dipendono da architettura, dataset, funzioni obiettivo, ottimizzazione e numerosi altri fattori.
Come il feedback del discriminatore migliora il generatore
Il generatore non deve conoscere direttamente quale singolo pixel “sia sbagliato” in senso umano.
Riceve un segnale attraverso la funzione obiettivo e i gradienti che attraversano il discriminatore. In questo modo può modificare i propri parametri nella direzione che rende i campioni prodotti più convincenti rispetto al giudizio di D.
Qui nasce una delle intuizioni più potenti del metodo: il discriminatore può imparare quali caratteristiche rendano un campione più o meno compatibile con il dataset, invece di richiedere che ogni proprietà importante venga definita manualmente.
Ma la stessa dinamica crea un problema. Se uno dei due modelli migliora molto più velocemente dell’altro, il segnale di apprendimento può diventare poco utile.
Funzioni di perdita ed equilibrio: l’intuizione senza formule inutili
Generatore e discriminatore non stanno ottimizzando esattamente la stessa cosa.
Il discriminatore vuole assegnare valutazioni corrette ai dati reali e a quelli sintetici. Il generatore vuole invece produrre campioni che portino D a sbagliare.
Questo rende il training una ottimizzazione accoppiata.
Non stai soltanto scendendo lungo una superficie di errore stabile verso un minimo. Stai modificando contemporaneamente due modelli e, quando uno cambia, cambia anche il problema che l’altro deve risolvere.
È il motivo per cui il paradigma adversarial può produrre risultati eccellenti ma è storicamente noto per essere difficile da addestrare in modo stabile.
Perché il training è difficile
L’eleganza dell’idea “due reti che competono” non deve nascondere una conseguenza pratica: far migliorare due avversari alla velocità giusta è più delicato che ottimizzare un singolo modello.
Se il discriminatore diventa troppo efficace troppo presto, può fornire al generatore un segnale poco informativo. Se invece è troppo debole, non riesce a indicare quali caratteristiche dei campioni prodotti vadano migliorate.
Non esiste quindi un equilibrio garantito solo perché l’architettura è formalmente corretta.
Mode collapse: quando il generatore perde diversità
Il mode collapse è uno dei problemi più conosciuti di questo tipo di modello.
Immagina un dataset che contenga moltissimi tipi di volti. Il generatore scopre però che una piccola famiglia di volti riesce a ingannare bene il discriminatore e continua a produrre soprattutto variazioni di quelli.
Gli output possono sembrare realistici presi singolarmente, ma il modello non sta rappresentando bene tutta la varietà presente nei dati.
Questo distingue due proprietà che non vanno confuse:
fedeltà → quanto un campione appare realistico;
diversità → quanto bene il modello copre le differenti modalità della distribuzione.
Un sistema può fare bene la prima e male la seconda. È ciò che rende insufficiente giudicarlo osservando soltanto una galleria di esempi riusciti.
Instabilità e squilibrio tra le due reti
Durante il training i due componenti devono continuare a fornire l’uno all’altro un problema utile da risolvere.
Se il discriminatore domina, il generatore può ricevere gradienti deboli o poco informativi. Se invece il generatore trova rapidamente uno schema che sfrutta una debolezza di D, quest’ultimo deve adattarsi.
Da qui derivano oscillazioni, sensibilità agli iperparametri e difficoltà di convergenza.
Negli anni sono state introdotte numerose soluzioni: nuove loss, regolarizzazioni, Wasserstein GAN, gradient penalty e architetture più robuste. Questi sviluppi hanno migliorato molto il comportamento dei modelli, ma non hanno eliminato la natura accoppiata dell’ottimizzazione.
Perché un output realistico non basta per valutare il modello
Supponiamo che un sistema produca dieci ritratti perfettamente credibili.
Abbiamo dimostrato che funziona bene?
Non necessariamente. Potrebbe continuare a generare quasi sempre gli stessi tipi di volto oppure ignorare intere parti della distribuzione del dataset.
Per questo nella ricerca sono state impiegate metriche come Inception Score e Fréchet Inception Distance (FID), insieme a misure specifiche del dominio e valutazioni qualitative. Nessuna singola metrica, però, sostituisce una metodologia coerente con il problema reale.
La domanda corretta non è quindi soltanto “quanto sembrano belli gli esempi?”, ma anche quale parte della distribuzione viene coperta, quanto sono diversi gli output e rispetto a quale obiettivo stiamo valutando il sistema.
Applicazioni delle GAN: dove sono state utilizzate
Le applicazioni delle GAN sono spesso associate alle immagini perché proprio nella computer vision il paradigma adversarial ha ottenuto alcuni dei risultati più riconoscibili.
Il framework, però, non impone che il dato sia necessariamente una fotografia. Può essere applicato a differenti distribuzioni e rappresentazioni, anche se ogni dominio richiede architetture, dataset e criteri di valutazione appropriati.
Generazione e manipolazione delle immagini
La generazione di immagini è il caso più famoso.
La famiglia StyleGAN, per esempio, ha mostrato quanto un generatore ben progettato possa produrre immagini fotorealistiche e organizzare in modo utile alcune proprietà dello spazio latente. StyleGAN3 ha poi affrontato specifici problemi di aliasing e dipendenza dalle coordinate presenti nelle architetture precedenti.
Ma questi modelli non servono soltanto a creare un’immagine da zero.
Possono essere addestrati per modificare una rappresentazione, tradurre un dominio visuale in un altro, ricostruire dettagli o generare nuove varianti coerenti con un dataset.
Image-to-image translation e super-risoluzione
Pix2Pix utilizza un modello condizionato per apprendere una trasformazione da un’immagine di input a un’immagine di output partendo da coppie corrispondenti. Il lavoro originale mostra, tra gli esempi, la generazione di fotografie da mappe di etichette, la colorizzazione e la ricostruzione a partire da bordi.
CycleGAN affronta invece uno scenario diverso: apprendere la traduzione tra due domini quando non disponiamo necessariamente di coppie perfettamente allineate. Introduce una cycle consistency loss che vincola la trasformazione nelle due direzioni.
SRGAN applica invece l’apprendimento adversarial alla super-risoluzione, con l’obiettivo di recuperare texture visivamente plausibili quando un’immagine viene ingrandita.
Questi esempi spiegano meglio di un lungo catalogo perché esistano così tante varianti: non sono soltanto nomi diversi dello stesso modello, ma modifiche progettate intorno a task e vincoli differenti.
Dati sintetici e data augmentation
Un altro impiego importante è la creazione di dati sintetici.
Un modello generativo può produrre campioni aggiuntivi che imitano alcune caratteristiche statistiche del dataset reale. In determinati workflow questi dati possono essere utilizzati per sperimentazione, bilanciamento delle classi o data augmentation.
Questo non significa che “più dati sintetici” migliorino automaticamente un sistema.
Se il generatore rappresenta male la distribuzione reale, amplifica bias o soffre di mode collapse, può introdurre nel dataset proprio le distorsioni che volevamo ridurre.
Il valore dei dati sintetici dipende quindi da come vengono generati, validati e utilizzati.
Deepfake, manipolazione dei contenuti e rischi
Le reti generative avversarie sono state strettamente associate ai deepfake perché hanno contribuito in modo importante allo sviluppo della sintesi e manipolazione fotorealistica.
Sarebbe però sbagliato dedurre che ogni deepfake moderno utilizzi questa architettura. Il panorama generativo comprende oggi anche diffusion model, Transformer e sistemi ibridi.
Il problema più generale è un altro: quando diventa semplice generare o modificare contenuti sintetici credibili, l’aspetto realistico non è più una prova sufficiente dell’autenticità del contenuto.
Le applicazioni possono essere legittime — cinema, simulazione, privacy, ricerca, design — oppure abusive, per esempio impersonificazione e disinformazione. È quindi il contesto di utilizzo, non il nome dell’architettura, a determinare gran parte del rischio.
Varianti principali e cosa cambia davvero
Esistono moltissime varianti. Memorizzarne tutte le sigle serve poco.
È più utile capire quale problema modifica ciascuna famiglia.
| Variante | Che cosa cambia | Perché è importante |
|---|---|---|
| DCGAN | Introduce vincoli architetturali basati su reti convoluzionali profonde | Ha contribuito a rendere più efficace il paradigma sulle immagini |
| Conditional GAN (cGAN) | Generatore e discriminatore ricevono informazioni di condizionamento | Permette di controllare quale tipo di campione generare |
| Pix2Pix | Approccio condizionato per trasformazioni image-to-image con coppie input/output | Utile quando esistono esempi allineati della trasformazione desiderata |
| CycleGAN | Aggiunge consistenza ciclica tra due domini | Consente image-to-image translation senza coppie perfettamente corrispondenti |
| StyleGAN | Ridisegna generatore e rappresentazione degli stili | Migliora controllo e qualità nella sintesi visuale |
| SRGAN | Applica l’adversarial learning alla super-risoluzione | Punta alla qualità percettiva delle texture ricostruite |
DCGAN e conditional GAN
DCGAN è importante soprattutto dal punto di vista storico e architetturale: ha mostrato come combinare il paradigma adversarial con reti convoluzionali profonde in modo sufficientemente stabile da apprendere rappresentazioni utili da dataset di immagini.
La conditional GAN, invece, introduce un’idea più generale: non generare soltanto un campione, ma farlo sotto una determinata condizione.
La condizione può rappresentare una classe o un’altra informazione rilevante per il task. È un passaggio concettuale importante perché molte applicazioni reali non chiedono semplicemente “creami qualcosa”, ma “creami qualcosa che soddisfi queste caratteristiche”.
Pix2Pix e CycleGAN
Pix2Pix e CycleGAN risolvono due versioni differenti dello stesso problema generale.
Pix2Pix funziona bene quando possiamo costruire coppie input-output: per esempio una rappresentazione strutturale e la fotografia corrispondente.
CycleGAN nasce invece per i casi in cui queste coppie non sono disponibili. Il vincolo ciclico cerca di evitare che la trasformazione perda completamente l’identità strutturale del campione originario.
La differenza non è cosmetica. Cambia il tipo di dataset necessario per addestrare il sistema.
StyleGAN e SRGAN
StyleGAN è diventata una delle famiglie più riconoscibili nella generazione fotorealistica dei volti e nell’esplorazione dello spazio latente. Le versioni successive hanno affrontato limiti delle implementazioni precedenti, mostrando quanto la progettazione del generatore influisca sul tipo di struttura appresa.
SRGAN parte invece da un problema molto più specifico: la super-risoluzione.
È un buon esempio di come una loss adversarial possa essere utilizzata non per creare necessariamente un contenuto completamente nuovo, ma per spingere un sistema verso risultati percettivamente più realistici.
GAN vs diffusion model e VAE: differenze e trade-off
Il confronto GAN vs diffusion model viene spesso ridotto a una domanda troppo semplice: quale dei due genera le immagini migliori?
Non è il criterio giusto.
Modelli adversarial, diffusion model e VAE affrontano la generazione con meccanismi differenti, quindi cambiano training, inferenza, controllo e failure mode.
| Aspetto | Paradigma adversarial | Diffusion model | VAE |
|---|---|---|---|
| Principio | Competizione generatore-discriminatore | Apprendimento di un processo di denoising | Modello probabilistico encoder-decoder |
| Training | Accoppiato e potenzialmente instabile | Obiettivo di denoising generalmente più regolare | Obiettivo variazionale |
| Generazione | Normalmente un forward pass del generatore | Processo iterativo di denoising | Decodifica di un campione latente |
| Rischio caratteristico | Mode collapse / instabilità | Costo del sampling iterativo | Compromessi fra spazio latente e ricostruzione |
| Condizionamento | Possibile tramite modelli condizionali | Molto sviluppato nelle architetture moderne | Disponibile tramite varianti condizionate |
| Punto di forza tipico | Inferenza rapida e alta fedeltà in domini adatti | Diversità, stabilità e controllo | Spazio latente probabilistico e inferenza strutturata |
La tabella non è una classifica. I risultati dipendono dal task, dal dataset e dall’implementazione.
Generazione, velocità e training rispetto ai diffusion model
Un generatore adversarial addestrato produce normalmente un campione attraverso un singolo passaggio della rete. Questa caratteristica può diventare importante quando la latenza di inferenza è un vincolo.
Un diffusion model classico genera invece attraverso un processo iterativo: parte dal rumore e applica ripetutamente un modello di denoising.
Questo non significa che ogni diffusion model sia “lento” nello stesso modo o che ogni modello adversarial sia adatto al real time. Tecniche di sampling e architetture continuano a evolvere.
Resta però una differenza strutturale utile per orientarsi:
adversarial → generazione diretta con un generatore addestrato contro un discriminatore
diffusion → generazione attraverso una sequenza di trasformazioni di denoising
Differenze rispetto ai VAE
Un Variational Autoencoder segue una logica differente.
Utilizza un encoder che rappresenta i dati in uno spazio latente probabilistico e un decoder che ricostruisce o genera dati a partire da quello spazio.
Il confronto utile non è quindi “VAE crea immagini peggiori e il modello adversarial migliori”. È una semplificazione che dipende troppo dal contesto.
La differenza fondamentale riguarda come viene modellata la distribuzione e come viene ottimizzato il sistema.
Il paradigma adversarial apprende attraverso un discriminatore. Un VAE ottimizza invece un obiettivo probabilistico che struttura esplicitamente lo spazio latente.
Per questo le due famiglie possono avere comportamenti molto diversi pur rientrando entrambe nel generative modeling.
Dove entrano i Transformer
Transformer e modelli adversarial non sono sempre alternative sullo stesso livello.
Un Transformer descrive principalmente una architettura neurale basata sull’attention. Il paradigma qui descritto identifica invece un framework di addestramento generativo basato sulla competizione tra due modelli.
Un Transformer può essere utilizzato dentro sistemi generativi costruiti con obiettivi differenti. Analogamente, un diffusion model può utilizzare architetture Transformer nei propri componenti.
Per questo una domanda come “GAN o Transformer?” può essere mal posta.
Nel caso dei modelli linguistici GPT, la famiglia architetturale è Transformer, non adversarial.
Se vuoi allargare il quadro alle altre famiglie e applicazioni, trovi la panoramica generale nella guida all’AI generativa.
Dove si collocano oggi nell’AI generativa
Questi modelli hanno avuto un ruolo decisivo nella storia recente del generative modeling, soprattutto nell’immagine.
Nel frattempo il panorama è cambiato.
I diffusion model sono diventati centrali in molte pipeline di generazione visuale general-purpose e text-to-image. Le architetture Transformer sono alla base dei grandi modelli linguistici e vengono utilizzate anche in numerosi sistemi multimodali e visuali.
Da qui nasce una conclusione affrettata: “le GAN sono obsolete”.
La ricerca recente non supporta una formulazione così assoluta. Continuano a esistere applicazioni, varianti e architetture ibride in computer vision, dati sintetici, medical imaging, cybersecurity, anomaly detection e altri domini.
I casi in cui restano utili
Un primo caso riguarda la latenza di generazione. Una volta addestrato, il generatore può produrre un campione con un forward pass, mentre una pipeline diffusion tradizionale richiede più step di denoising.
Un secondo riguarda domini relativamente definiti nei quali l’adversarial training e l’architettura scelta riescono a modellare bene la distribuzione.
Un terzo comprende task specifici per i quali esistono soluzioni consolidate: image-to-image translation, super-risoluzione, alcune forme di domain adaptation, anomaly detection e generazione di dati sintetici.
Infine ci sono le architetture ibride. Non è obbligatorio scegliere una sola famiglia e rifiutare tutte le altre: differenti meccanismi possono essere combinati quando il problema lo giustifica.
Perché altre architetture sono diventate più comuni
Quando l’obiettivo è ottenere grande varietà, training più prevedibile e condizionamento molto flessibile, il paradigma adversarial può diventare meno conveniente.
Il successo dei diffusion model deriva anche da qui.
Nei latent diffusion model, per esempio, parte del processo viene spostata nello spazio latente per ridurre il costo computazionale e rendere più flessibile il condizionamento.
Negli anni successivi la ricerca ha continuato a ridurre i costi del sampling e a sviluppare modalità di controllo sempre più sofisticate.
Il risultato non è che i modelli precedenti abbiano smesso di funzionare. È che la scelta disponibile è diventata molto più ampia.
Perché definirle “obsolete” è una semplificazione
Una tecnologia può smettere di essere il default di un settore senza diventare inutile.
Per molti sistemi general-purpose di generazione visuale le reti generative avversarie non sono più l’unico riferimento e spesso non rappresentano la prima architettura a cui si pensa.
La domanda utile, però, non è:
“Questa tecnologia è ancora di moda?”
È:
“Il problema che devo risolvere beneficia delle proprietà specifiche dell’adversarial training?”
Questa seconda domanda porta a una scelta tecnica. La prima rischia soprattutto di inseguire la novità.
Domande frequenti
Le GAN sono utilizzate da ChatGPT?
Definire ChatGPT “una GAN” sarebbe scorretto.
La famiglia GPT nasce da modelli Transformer addestrati per lavorare sulle sequenze. ChatGPT come prodotto può orchestrare più componenti e strumenti, ma il principio generatore-discriminatore non è ciò che definisce i modelli GPT.
GAN e adversarial machine learning sono la stessa cosa?
No.
Nel primo caso, adversarial descrive la competizione fra generatore e discriminatore durante il training.
L’adversarial machine learning comprende invece tecniche, attacchi e mitigazioni che riguardano la manipolazione o compromissione del comportamento dei sistemi di machine learning.
I due concetti possono incontrarsi in determinati lavori di ricerca, ma non sono sinonimi.
Una GAN può generare soltanto immagini?
No.
Il framework non impone che l’output sia un’immagine. In linea di principio può essere utilizzato per apprendere e generare altri tipi di dati.
Le immagini sono però il dominio nel quale queste architetture hanno prodotto alcuni dei risultati più noti e dove sono nate molte delle varianti diventate punti di riferimento, da DCGAN a StyleGAN, Pix2Pix, CycleGAN e SRGAN.
Conclusione
Una GAN è molto più di “un’AI che crea immagini”.
È un modo specifico di costruire un modello generativo: un generatore produce campioni e un discriminatore impara a distinguerli dai dati reali; il miglioramento nasce dall’interazione fra i due.
Questo meccanismo spiega sia i punti di forza sia i limiti dell’approccio. Può produrre risultati estremamente realistici e consentire inferenza rapida, ma rende il training sensibile all’equilibrio fra i due modelli e introduce problemi come il mode collapse.
Capire questa dinamica evita anche un equivoco sul panorama attuale dell’intelligenza artificiale. Le reti generative avversarie non coincidono con tutta l’AI generativa e non sono state semplicemente “sostituite” da una singola tecnologia successiva. Oggi condividono il campo con diffusion model, VAE, Transformer e sistemi ibridi, ciascuno con meccanismi e trade-off propri.
Quando incontri questa architettura in un progetto o in una ricerca, quindi, la domanda utile non è se sia la tecnologia più nuova. È capire perché l’adversarial training sia adatto a quel problema, quali compromessi introduca e che cosa offra rispetto alle alternative disponibili.