
DALL·E è la famiglia di modelli di OpenAI che ha contribuito a rendere popolare la generazione di immagini a partire da una descrizione testuale. Se però hai cercato “Dall E” o “Dalle AI” per creare un’immagine con OpenAI, c’è una distinzione importante da fare subito: DALL·E non è più il riferimento operativo principale.
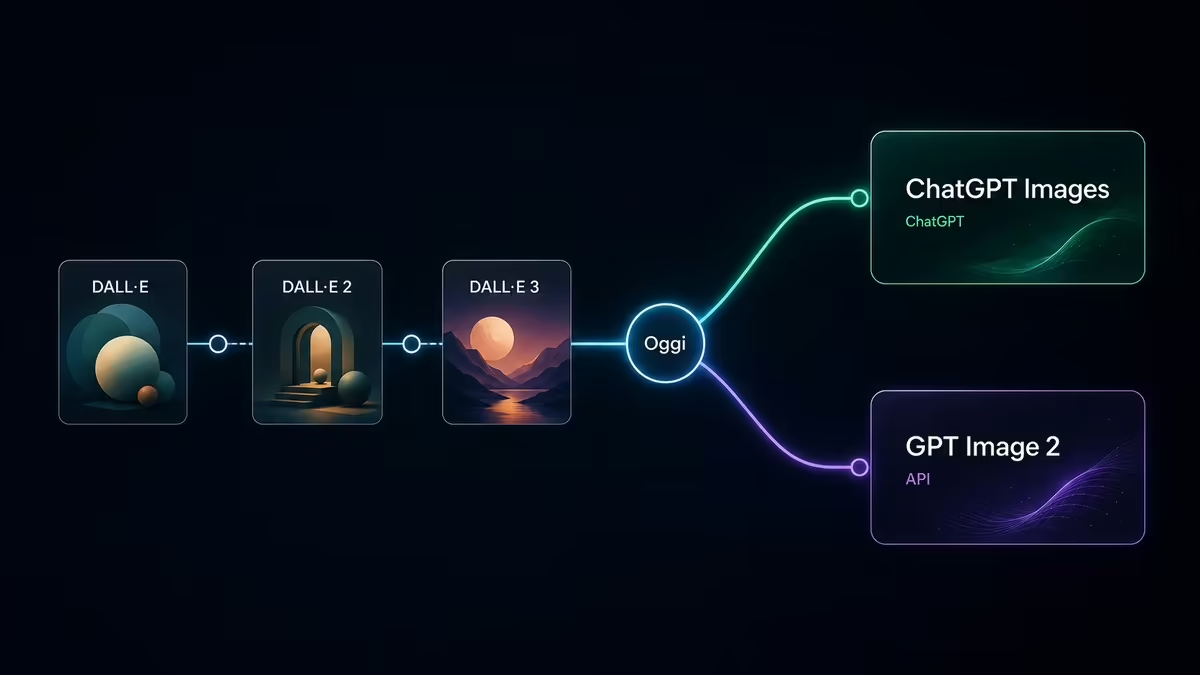
In ChatGPT la creazione e la modifica delle immagini passano oggi attraverso ChatGPT Images; per gli sviluppatori OpenAI indica invece GPT Image 2 come modello corrente per image generation ed editing. DALL·E 2 e DALL·E 3 sono ormai modelli legacy: entrambi risultano deprecated e rimossi dall’API.
Il nome DALL·E, quindi, resta importante perché identifica una parte fondamentale della storia dell’AI generativa e continua a essere cercato dagli utenti. Ma per capire cosa puoi fare realmente con le immagini OpenAI bisogna separare la famiglia storica DALL·E, il prodotto ChatGPT Images e il modello GPT Image 2.
È proprio questa distinzione che useremo come filo conduttore della guida: prima capiremo cosa è successo a DALL·E, poi vedremo come funziona realmente un generatore di immagini AI, come creare e modificare immagini, come scrivere prompt migliori, quali limiti tenere presenti e quando ha senso scegliere un sistema diverso.
DALL·E oggi: cosa è cambiato e cosa si usa al suo posto
Il modo più semplice per orientarsi è smettere di pensare a DALL·E come a un prodotto che continua semplicemente con una numerazione progressiva.
La sequenza DALL·E → DALL·E 2 → DALL·E 3 esiste ed è importante storicamente. Ma OpenAI ha successivamente spostato la propria generazione visiva verso la famiglia GPT Image e verso una esperienza integrata direttamente in ChatGPT.
Il risultato è che tre nomi che spesso vengono usati come sinonimi indicano in realtà cose diverse:
- DALL·E è la famiglia storica di modelli text-to-image di OpenAI;
- ChatGPT Images è l’esperienza attraverso cui un utente crea e modifica immagini dentro ChatGPT;
- GPT Image 2 è il modello di generazione ed editing che OpenAI indica per l’utilizzo corrente tramite API.
Questa distinzione è molto simile a quella fra prodotto e modello che trovi nella nostra guida a ChatGPT: l’interfaccia con cui lavori e il modello che svolge una determinata operazione non sono necessariamente la stessa cosa.
Da DALL·E 1, DALL·E 2 e DALL·E 3 a ChatGPT Images
Le prime generazioni di DALL·E hanno mostrato che un modello poteva trasformare una frase in un’immagine nuova invece di limitarsi a classificare o riconoscere immagini esistenti.
Con DALL·E 2 la generazione è diventata molto più pratica: maggiore qualità, possibilità di modificare immagini e un rapporto più stretto tra descrizione testuale e risultato visivo. DALL·E 3 ha poi migliorato soprattutto la capacità di seguire istruzioni articolate e ha reso centrale l’interazione attraverso ChatGPT.
È stato un passaggio importante perché ha modificato anche il ruolo del prompt.
Con un generatore tradizionale scrivi un comando e aspetti il risultato. In un ambiente conversazionale, invece, puoi partire da un brief incompleto, osservare l’immagine, spiegare cosa non funziona e continuare a correggerla.
La generazione diventa quindi un processo iterativo, non una singola estrazione.
Oggi OpenAI porta questa logica dentro ChatGPT Images. La documentazione ufficiale indica che puoi creare immagini partendo da una conversazione, caricare immagini esistenti, modificarle, intervenire su aree specifiche e richiedere elementi come testo o sfondo trasparente. ChatGPT Images 2.0 è disponibile su tutti i piani, anche se limiti e capacità accessorie possono variare in base all’account.
Documentazione ufficiale di ChatGPT Images
DALL·E 3 esiste ancora?
DALL·E 3 esiste come modello storico e tecnologia legacy, ma non è più il modello su cui costruire un nuovo workflow.
La documentazione API di OpenAI lo classifica esplicitamente come deprecated e rimosso dall’API, raccomandando GPT Image 2 per la generazione e la modifica delle immagini. Lo stesso vale per DALL·E 2.
OpenAI ha inoltre annunciato il ritiro del GPT DALL·E ufficiale presente in ChatGPT e indirizza gli utenti verso ChatGPT Images per continuare a creare e modificare contenuti visivi.
Questo spiega perché online puoi incontrare ancora tutorial perfettamente funzionanti dal punto di vista storico ma ormai sbagliati dal punto di vista operativo: parlano di crediti DALL·E, di DALL·E 3 come modello corrente o dell’accesso tramite ChatGPT Plus come unica strada.
Sono informazioni che descrivevano una fase precedente del prodotto.
Esiste DALL·E 4?
No: OpenAI non ha presentato un modello corrente chiamato DALL·E 4.
Se incontri formule come “DALL·E 4” usate per indicare genericamente la nuova generazione di immagini OpenAI, rischi di confondere due linee di prodotto differenti.
L’evoluzione non è stata:
DALL·E 2 → DALL·E 3 → DALL·E 4
ma, semplificando:
famiglia DALL·E → generazione immagini integrata in ChatGPT → famiglia GPT Image
Nel catalogo corrente dei modelli OpenAI, GPT Image 2 occupa infatti la posizione dedicata alla generazione e all’editing delle immagini, mentre i modelli precedenti della famiglia GPT Image e DALL·E vengono classificati come precedenti o deprecated.
Questa non è una semplice questione di naming. Cambia anche il modo corretto di spiegare il prodotto: oggi non ha molto senso chiedersi quale “versione di DALL·E” scegliere. È più utile chiedersi se creare l’immagine dentro ChatGPT oppure integrare GPT Image 2 in un’applicazione tramite API.
Cos’è DALL·E e perché ha cambiato la generazione di immagini AI
DALL·E è nato come modello di intelligenza artificiale capace di generare immagini a partire da una descrizione testuale.
Questa definizione è semplice, ma il cambiamento che ha introdotto è profondo.
Prima della diffusione dei modelli text-to-image, produrre un contenuto visivo originale significava normalmente fotografare, illustrare, modellare, comporre manualmente oppure partire da materiale esistente.
Con la generazione AI compare un workflow diverso:
descrivi una rappresentazione visiva → il modello interpreta i vincoli → produce una nuova immagine candidata → valuti il risultato → modifichi le istruzioni o l’immagine → generi una nuova versione.
Non elimini necessariamente il lavoro creativo. Sposti parte del lavoro dalla produzione manuale alla direzione del risultato.
Questo è il motivo per cui i generatori di immagini hanno trovato applicazioni molto diverse: concept art, moodboard, visual editoriali, campagne, mockup, brainstorming, storyboard e prototipi.
Da una descrizione testuale a un’immagine
Considera un prompt elementare:
Una bicicletta rossa davanti a una casa bianca.
Un generatore non deve soltanto produrre tre oggetti — bicicletta, colore rosso e casa — ma deve rappresentare anche le relazioni contenute nella richiesta.
La bicicletta deve essere davanti alla casa. Il rosso deve riferirsi alla bicicletta. Il bianco deve riferirsi alla casa.
Quando il prompt diventa:
Una bicicletta da corsa rossa appoggiata a una casa bianca mediterranea al tramonto, fotografata frontalmente con una luce calda e ombre lunghe.
si aggiungono altre relazioni: tipologia del soggetto, posizione, architettura, momento della giornata, punto di vista, qualità della luce.
La qualità di un sistema text-to-image dipende anche dalla capacità di mantenere queste relazioni senza perdere elementi o attribuire una proprietà all’oggetto sbagliato.
È per questo che prompt adherence, coerenza spaziale, rendering del testo e capacità di modifica sono diventati criteri molto più significativi della semplice domanda “produce belle immagini?”.
DALL·E, ChatGPT Images e GPT Image 2 non sono la stessa cosa
Un errore frequente nell’AI è confondere modello, sistema e applicazione.
È lo stesso problema che affrontiamo nella guida generale all’intelligenza artificiale: un modello è una componente computazionale, mentre un sistema reale può aggiungere interfaccia, strumenti, controlli, memoria, dati e logiche applicative.
Con le immagini OpenAI:
ChatGPT Images è l’esperienza con cui interagisci.
GPT Image 2 è il modello specializzato che OpenAI mette a disposizione degli sviluppatori per generazione ed editing tramite API.
DALL·E è la famiglia precedente che ha costruito buona parte della notorietà della generazione visiva di OpenAI.
Usare questi termini correttamente evita molte conclusioni sbagliate, soprattutto quando si parla di prezzi, API, disponibilità o confronto con altri generatori.
Come funziona la generazione di immagini con l’intelligenza artificiale
La tentazione è spiegare un generatore di immagini con formule come “l’AI comprende il prompt e immagina la scena”.
Sono metafore intuitive, ma diventano fuorvianti se prese letteralmente.
Un modello non possiede necessariamente un’intenzione creativa, non vede la scena nella propria mente e non consulta un archivio cercando la fotografia che assomiglia di più alla frase.
Lavora invece con rappresentazioni matematiche apprese durante l’addestramento e produce un output in funzione dell’input e dei parametri del sistema.
Se vuoi approfondire la differenza tra questi modelli matematici e il cervello umano, nella guida alle reti neurali spieghiamo perché termini come “neurone”, “apprendimento” e “rete” non implicano che il sistema pensi come una persona.
Cosa succede quando scrivi un prompt
Per l’utente il processo può essere rappresentato così:
PROMPT → INTERPRETAZIONE DEL CONTESTO → GENERAZIONE → IMMAGINE → VALUTAZIONE → MODIFICA
Il prompt fornisce al sistema informazioni sul risultato desiderato.
Possono riguardare:
- soggetto;
- ambiente;
- azione;
- relazioni fra gli elementi;
- punto di vista;
- composizione;
- illuminazione;
- formato;
- stile;
- testo da rappresentare;
- vincoli su ciò che deve o non deve comparire.
Il modello utilizza queste informazioni come condizioni per produrre un output coerente con la richiesta.
Nei prodotti conversazionali entra inoltre in gioco il contesto della conversazione. Se generi una scena e nel messaggio successivo scrivi “mantieni tutto uguale ma cambia la bicicletta da rossa a verde”, il nuovo comando acquista significato grazie all’immagine e allo scambio precedente.
Questo è un vantaggio concreto del workflow conversazionale: non devi ricostruire ogni volta tutto il brief.
Generare da zero e modificare un’immagine sono due task differenti
Con il text-to-image puro parti essenzialmente da un’istruzione testuale.
Con l’image-to-image o l’editing, invece, fornisci anche una rappresentazione visiva che diventa parte dell’input.
GPT Image 2 supporta sia input sia output immagine e OpenAI documenta il supporto a input visivi ad alta fedeltà e dimensioni flessibili.
Questo rende possibili workflow come:
- cambiare lo sfondo conservando il soggetto;
- eliminare un oggetto;
- modificare un colore;
- aggiungere un elemento;
- adattare una scena a un altro formato;
- creare una variante partendo da un’immagine di riferimento.
Il punto importante è che editing non significa manipolazione pixel-perfect garantita.
Anche quando selezioni una zona precisa, il modello può modificare elementi vicini o reinterpretare dettagli che volevi mantenere. La stessa documentazione di ChatGPT Images avverte che una selezione non è sempre esatta e che le modifiche possono estendersi oltre l’area evidenziata.
Per un lavoro professionale è quindi utile distinguere:
editing generativo → ottimo per esplorare e ricostruire;
editing deterministico → ancora necessario quando devi controllare singoli pixel, livelli, maschere, colore o geometria con precisione.
Perché un’immagine può sembrare corretta anche quando non lo è
Un generatore è ottimizzato per produrre un output visualmente plausibile rispetto alla richiesta. La plausibilità, però, non garantisce la correttezza fattuale.
Un’insegna può sembrare autentica ma contenere una parola sbagliata.
Una scheda elettronica può sembrare credibile ma presentare connessioni impossibili.
Una ricostruzione storica può avere l’atmosfera corretta e mescolare dettagli appartenenti a periodi differenti.
Un’interfaccia software può sembrare realistica pur non corrispondendo a nessun prodotto esistente.
Questa distinzione è essenziale quando utilizzi immagini AI in contesti informativi, tecnici, scientifici o commerciali.
Un’immagine convincente non è automaticamente un’immagine vera.
Come usare DALL·E oggi: creare immagini con ChatGPT Images
Se il tuo obiettivo è semplicemente generare o modificare un’immagine senza programmare, il percorso più diretto non è cercare una vecchia interfaccia DALL·E. È utilizzare ChatGPT Images.
OpenAI documenta due ingressi principali: puoi chiedere direttamente nella conversazione di creare un’immagine oppure aprire la superficie dedicata alle immagini.
Creare la prima immagine partendo da una descrizione
Puoi iniziare con una richiesta normale:
Crea un’illustrazione editoriale di un piccolo studio di web design. Una designer lavora davanti a un monitor mentre diverse bozze di homepage prendono forma intorno alla postazione. Inquadratura orizzontale, luce naturale, atmosfera professionale, niente testo.
La generazione produrrà una prima interpretazione.
A questo punto il lavoro interessante non è riscrivere immediatamente un prompt tre volte più lungo. È valutare cosa è sbagliato.
Forse il soggetto è troppo centrale.
Forse l’ambiente sembra un ufficio generico.
Forse la composizione non lascia spazio negativo sufficiente per il layout editoriale.
La richiesta successiva può allora essere molto precisa:
Mantieni il soggetto e l’atmosfera. Sposta la designer sul terzo destro dell’immagine e lascia più spazio negativo a sinistra. Riduci gli elementi decorativi sul tavolo.
Questa sequenza è spesso più controllabile di un enorme prompt iniziale che tenta di anticipare ogni possibile errore.
Modificare un’immagine già esistente
Puoi anche caricare una foto o un’illustrazione e descrivere la modifica.
Per esempio:
Mantieni prodotto, prospettiva e illuminazione. Sostituisci soltanto il fondo grigio con una parete color avorio leggermente texturizzata. Non modificare forma, colore o logo del prodotto.
La frase contiene tre componenti importanti:
cosa deve cambiare: lo sfondo;
cosa deve restare: prodotto, prospettiva e illuminazione;
quali dettagli sono critici: forma, colore e logo.
Nel lavoro reale è spesso questa distinzione fra variabile e invarianti a rendere un’istruzione più utile.
Cambiare solo una parte senza rifare tutto
ChatGPT Images dispone anche di un editor in cui puoi selezionare l’area su cui vuoi intervenire.
Puoi, per esempio, selezionare un oggetto e scrivere:
Sostituisci questa tazza con un piccolo vaso in ceramica bianca. Mantieni invariati tavolo, mano, luce e profondità di campo.
La selezione aiuta a indirizzare il cambiamento, ma non va interpretata come una maschera assoluta. Se il contesto intorno all’oggetto deve essere ricostruito per rendere la modifica plausibile, potrebbero cambiare anche alcuni pixel esterni alla selezione.
Per questo conviene controllare sempre:
- soggetto principale;
- dettagli che dovevano rimanere identici;
- testo;
- mani e geometrie complesse;
- ombre e riflessi;
- eventuali loghi o elementi di brand.
Testo, formato e sfondo trasparente
ChatGPT Images supporta istruzioni per inserire testo all’interno dell’immagine, creare dettagli specifici e produrre uno sfondo trasparente. Puoi inoltre indicare proporzioni e formato desiderati.
Questo amplia molto gli scenari rispetto ai primi generatori text-to-image.
Puoi chiedere, per esempio:
Crea un’illustrazione vettoriale di una tazza di caffè vista frontalmente, sfondo trasparente, nessuna ombra esterna, bordi puliti.
Oppure:
Crea un poster verticale con la frase “OPEN STUDIO” come unico testo. Il lettering deve essere grande, geometrico e perfettamente leggibile. Nessun altro testo nell’immagine.
Il rendering tipografico dei modelli recenti è migliorato sensibilmente, ma per loghi, packaging, documenti o materiale destinato alla stampa il testo va comunque verificato carattere per carattere.
Iterare nella stessa conversazione
Uno degli aspetti più utili dell’integrazione conversazionale è la possibilità di trasformare il prompt in un dialogo di art direction.
Puoi procedere così:
Prima generazione
Interno di una libreria contemporanea, atmosfera calda, legno chiaro, fotografia editoriale.
Correzione compositiva
La scena è troppo simmetrica. Porta il bancone a sinistra e crea una diagonale con gli scaffali.
Correzione della luce
Mantieni la composizione, ma sostituisci l’illuminazione artificiale con luce naturale proveniente da grandi finestre sulla destra.
Correzione narrativa
Aggiungi una sola persona che sfoglia un libro in secondo piano. Non deve guardare verso la camera.
Il vantaggio non consiste nel fatto che ogni modifica sarà perfetta. Consiste nel poter ragionare sul risultato progressivamente, invece di tentare di esprimere una direzione creativa completa in una singola frase.
Come scrivere un buon prompt per creare immagini con l’AI
Un prompt efficace non è quello con più aggettivi.
È quello che riduce le ambiguità che contano.
Aggiungere automaticamente formule come “8K”, “masterpiece”, “ultra detailed”, “award-winning” o una lunga sequenza di termini estetici non garantisce un’immagine migliore. Spesso rende soltanto meno chiara la gerarchia delle istruzioni.
Per una generazione controllabile conviene ragionare come su un piccolo brief visivo.
Soggetto, azione, ambiente, composizione e linguaggio visivo
Un buon punto di partenza è:
SOGGETTO → AZIONE/RELAZIONE → AMBIENTE → COMPOSIZIONE → LUCE → LINGUAGGIO VISIVO → VINCOLI
Non devi necessariamente includere tutte le componenti. Devi specificare quelle che cambierebbero realmente il risultato.
Confronta:
Un fotografo in uno studio.
con:
Fotografia editoriale orizzontale di un fotografo che sistema una fotocamera su un tavolo da lavoro in uno studio piccolo e ordinato. Inquadratura a tre quarti, soggetto sul lato sinistro, luce morbida da finestra, colori naturali, nessun testo nell’immagine.
Il secondo prompt non è migliore perché è più lungo.
È migliore perché chiarisce cosa deve esserci, cosa sta succedendo, come deve essere composta la scena e quali elementi non servono.
Da un prompt generico a una richiesta controllabile
Immagina di voler creare la featured image di un articolo su sicurezza e password.
Prompt generico:
Immagine sulla sicurezza informatica.
Il problema è evidente: il sistema deve decidere quasi tutto. Potrebbe produrre un lucchetto, un hacker con cappuccio, una cascata di codice verde o qualsiasi altro cliché visivo.
Una versione più utile sarebbe:
Immagine editoriale tecnologica orizzontale. Una persona sta creando una password su un laptop mentre un secondo dispositivo mostra una conferma di autenticazione. Ambiente domestico realistico, nessun hacker, nessun codice fluttuante, nessuna interfaccia leggibile, illuminazione naturale, composizione pulita con spazio negativo.
Qui hai definito il meccanismo da rappresentare, non soltanto il tema.
È una differenza fondamentale anche quando lavori con un designer umano: “sicurezza informatica” è un argomento; “utente che conferma un accesso con un secondo dispositivo” è una direzione visiva.
Come correggere un risultato invece di complicare il prompt
Quando la prima immagine non funziona, prova a identificare la classe dell’errore.
Se il problema è la composizione:
Mantieni soggetti e ambiente, ma allontana la camera e lascia più spazio vuoto sopra e a destra.
Se il problema è lo stile:
Mantieni composizione e soggetti. Elimina il look illustrativo e rendi la scena fotografica, con texture naturali e luce morbida.
Se il problema è un elemento:
Mantieni tutto il resto. Elimina il secondo monitor e non sostituirlo con altri oggetti.
Se il problema è una relazione:
Il telefono deve essere nella mano destra della persona, non appoggiato sul tavolo.
Questo tipo di correzione conserva una relazione chiara fra problema osservato e istruzione successiva.
Scrivere invece ogni volta un prompt completamente nuovo rende più difficile capire quale modifica abbia prodotto un miglioramento.
Gli errori di prompting più frequenti
Uno dei più comuni è usare parole valutative al posto di proprietà visive.
“Bello”, “professionale”, “premium” o “moderno” sono concetti molto ampi.
Se “premium” per te significa fotografia di prodotto con fondale neutro, materiali opachi, luce laterale morbida e composizione minimale, descrivi quegli elementi.
Un secondo errore è chiedere troppe cose incompatibili nello stesso spazio: primo piano del soggetto, panoramica dell’ambiente, dieci oggetti protagonisti, testo molto lungo e contemporaneamente ampio spazio negativo.
L’immagine ha una superficie finita. La gerarchia del prompt dovrebbe rispettare la gerarchia visiva.
Il terzo errore è continuare ad aggiungere aggettivi quando il problema è strutturale.
Se il soggetto è nel punto sbagliato della composizione, “più bello, più cinematografico, più dettagliato” non lo sposterà necessariamente.
Serve dire dove deve stare.
Cosa sa fare bene e quali limiti devi conoscere
La domanda utile non è se un modello “sa creare immagini”.
Quello è ormai il requisito di base.
Per valutarne l’utilità devi osservare quanta parte del lavoro successivo riesce a evitare.
Un’immagine esteticamente interessante ma inutilizzabile perché il titolo è sbagliato, il prodotto cambia forma o la composizione non rispetta il layout può costare più tempo di una generazione apparentemente meno spettacolare ma controllabile.
Testo dentro le immagini, composizione e instruction following
I modelli contemporanei sono diventati molto più capaci di rispettare istruzioni relative a composizione, testo e relazioni tra oggetti.
Ma “più capaci” non significa “deterministici”.
Se devi produrre un’immagine in cui:
- una frase deve essere perfettamente identica;
- il marchio non può cambiare di un pixel;
- un prodotto deve rispettare dimensioni industriali;
- una mappa deve avere coordinate corrette;
- un grafico deve mostrare dati reali;
la generazione dovrebbe essere solo una fase del processo.
La verifica resta necessaria.
Per questo, quando crei infografiche o asset con dati, è spesso più robusto costruire testo, numeri e grafici con strumenti nativi invece di rasterizzarli dentro un’immagine generata.
Coerenza dei soggetti e modifiche iterative
Fornire immagini di riferimento e continuare a lavorare nello stesso contesto può migliorare la continuità fra più iterazioni.
GPT Image 2 supporta image input ad alta fedeltà, caratteristica particolarmente utile quando vuoi conservare elementi provenienti da un’immagine esistente.
Tuttavia, “riferimento” non equivale a “blocco”.
Un volto può cambiare leggermente.
Un logo può deformarsi.
La disposizione degli oggetti può spostarsi.
Una texture può essere reinterpretata.
Per una singola immagine questo può essere irrilevante. Per un catalogo di prodotti, una campagna con personaggio ricorrente o una identità di marca diventa invece un requisito critico.
Persone, luoghi e dettagli reali richiedono attenzione
Se l’immagine deve rappresentare qualcosa che esiste nel mondo reale, aumenta la necessità di verifica.
Una scena generica di “una piazza italiana” può tollerare libertà creative.
Una rappresentazione di Piazza San Marco utilizzata come fotografia documentaria no.
Lo stesso vale per persone reali, eventi, prodotti, edifici, opere, uniformi o attrezzature tecniche.
Il generatore produce un’immagine sulla base dei vincoli disponibili; non è una banca immagini documentale.
Se la precisione fattuale è il requisito principale, una fotografia reale, uno screenshot verificato, un diagramma costruito da dati o una fonte primaria possono essere media editoriali molto migliori.
Un’immagine convincente non è necessariamente corretta
Questo principio merita di essere ripetuto perché è uno dei rischi più insidiosi della generazione visiva.
Gli errori evidenti si notano.
Quelli plausibili sono più pericolosi.
Un’immagine di un circuito con un componente inesistente può apparire professionale.
Un diagramma medico scorretto può sembrare didattico.
Una falsa interfaccia può sembrare una schermata autentica.
Un documento inventato può sembrare una scansione reale.
Quando l’immagine ha una funzione informativa o probatoria, la qualità estetica viene dopo l’accuratezza.
DALL·E è gratis? Come funzionano accesso e costi
Una parte consistente delle vecchie guide online parla ancora di crediti DALL·E.
Quel modello non descrive più correttamente il modo corrente di accedere alla generazione immagini OpenAI.
ChatGPT Images nei piani gratuiti e a pagamento
OpenAI indica che ChatGPT Images 2.0 è disponibile su tutti i piani ChatGPT.
Questo significa che non è più corretto dire in senso generale che per generare un’immagine sia obbligatorio sottoscrivere ChatGPT Plus.
Resta però importante una precisazione: disponibilità della funzione e quantità di utilizzo non sono la stessa cosa.
Limiti, priorità e funzioni aggiuntive possono variare in base al piano e possono cambiare nel tempo. Per questo eviterei di scegliere un abbonamento sulla base di un numero di generazioni letto in una guida non aggiornata.
Per verificare il tuo caso concreto, il riferimento migliore resta la schermata del piano e la documentazione ufficiale corrente.
Perché i vecchi crediti DALL·E non sono più il riferimento
Il sistema storico di crediti apparteneva a una fase in cui DALL·E veniva fruito in modo molto più separato dall’ecosistema ChatGPT.
Con il passaggio a ChatGPT Images e ai nuovi modelli GPT Image, il modello di accesso è cambiato.
Continuare a scrivere “DALL·E costa X crediti per immagine” mescola quindi un vecchio schema commerciale con un prodotto differente.
La distinzione corretta è oggi:
ChatGPT Images → accesso attraverso il piano ChatGPT e relativi limiti;
GPT Image 2 API → consumo a pagamento in base all’utilizzo.
Quanto costa GPT Image 2 tramite API
Per l’API OpenAI pubblica un tariffario basato sui token.
Al momento della revisione, la tariffazione Standard di GPT Image 2 è:
| Componente | Prezzo per 1 milione di token |
|---|---|
| Input testuale | 5 USD |
| Input testuale in cache | 1,25 USD |
| Input immagine | 8 USD |
| Input immagine in cache | 2 USD |
| Output immagine | 30 USD |
Il Batch applica tariffe inferiori rispetto allo Standard.
Pricing ufficiale delle API OpenAI
Il costo effettivo di una singola immagine dipende però da più variabili, tra cui dimensione, qualità e quantità di input visuale utilizzato durante un editing.
Per questo non convertirei la tabella in una promessa del tipo “ogni immagine costa sempre X centesimi”.
Per budget e automazioni su scala conviene usare il calcolatore indicato nella documentazione OpenAI e misurare il proprio workflow reale.
Usare GPT Image 2 tramite API: quando serve davvero
La maggioranza degli utenti non ha bisogno dell’API per creare una copertina, modificare una fotografia o provare un concept.
ChatGPT Images è più semplice proprio perché si occupa dell’interfaccia e della conversazione.
L’API diventa interessante quando la generazione visiva deve diventare una funzione di un sistema.
Per esempio:
utente compila un form → applicazione costruisce un brief → GPT Image 2 genera l’asset → sistema salva l’immagine → QA → pubblicazione
oppure:
catalogo prodotti → immagine di riferimento → generazione di ambientazioni → controllo → approvazione
La differenza non è quindi qualità “professionale” contro qualità “amatoriale”.
È soprattutto interazione manuale contro integrazione programmatica.
Generazione e modifica programmatica
La documentazione corrente di GPT Image 2 indica supporto per generazione ed editing delle immagini e per input visuali ad alta fedeltà. Il modello viene esposto attraverso gli endpoint e gli strumenti OpenAI destinati alla generazione di immagini.
In un’applicazione reale dovresti però considerare più del semplice prompt:
- autenticazione;
- gestione dei costi;
- limiti di utilizzo;
- storage;
- retry;
- moderazione;
- formati;
- logging;
- qualità;
- controllo umano;
- gestione degli errori.
L’API risolve la parte generativa. Non progetta automaticamente l’intero workflow.
Dimensioni, qualità e immagini di riferimento
GPT Image 2 supporta dimensioni flessibili e image input.
Questo è utile quando una applicazione deve produrre formati differenti o modificare asset esistenti.
Pensa, per esempio, a un sistema editoriale che deve creare lo stesso concept in:
- landscape per un articolo;
- verticale per una story;
- quadrato per un catalogo;
- sfondo trasparente per una composizione successiva.
Anche in questo caso, però, non assumerei che rigenerare la stessa descrizione in quattro aspect ratio produca automaticamente quattro crop dello stesso master.
Una nuova generazione può modificare composizione e dettagli.
Se la continuità è critica, la pipeline deve prevedere una strategia specifica di riferimento, editing o post-produzione.
Quando l’API ha senso rispetto a ChatGPT
Userei ChatGPT Images quando:
- stai esplorando un’idea;
- lavori manualmente su pochi asset;
- vuoi discutere e correggere un’immagine;
- non hai bisogno di automazione;
- vuoi un workflow rapido e conversazionale.
Valuterei GPT Image 2 tramite API quando:
- generi asset da un’app o da un CMS;
- hai flussi ripetitivi;
- devi elaborare immagini in volume;
- vuoi collegare la generazione a dati o logica applicativa;
- devi costruire un prodotto basato sulla generazione visiva.
Non sceglierei l’API soltanto perché sembra la soluzione “più avanzata”.
Se il tuo processo rimane manuale, aggiunge complessità senza necessariamente produrre un risultato migliore.
Diritti sulle immagini AI: cosa puoi fare con gli output di OpenAI
La domanda “di chi è un’immagine generata con DALL·E?” sembra semplice, ma in realtà contiene almeno tre questioni differenti:
- che cosa stabilisce il contratto tra OpenAI e l’utente;
- se l’output può ottenere protezione tramite copyright;
- se l’immagine viola diritti di terzi.
Confondere questi livelli porta facilmente a conclusioni troppo forti.
Proprietà dell’output nei termini OpenAI
Nelle condizioni applicabili agli utenti europei OpenAI specifica che, nel rapporto tra OpenAI e l’utente e nei limiti consentiti dalla legge, l’utente mantiene i propri diritti sull’input e possiede l’output.
Le stesse condizioni chiariscono però anche che gli output potrebbero non essere unici: utenti differenti possono ricevere contenuti simili.
Condizioni d’uso OpenAI per l’Europa
Questa è la risposta alla questione contrattuale.
Non chiude automaticamente quella sul copyright.
Proprietà contrattuale e copyright non sono la stessa cosa
Il fatto che OpenAI assegni all’utente i propri eventuali diritti sull’output non significa che ogni immagine generata dall’AI acquisisca automaticamente una protezione copyright identica a quella di un’opera realizzata interamente da una persona.
La proteggibilità dipende dalla normativa applicabile e dalle caratteristiche concrete del lavoro.
Inoltre, un output può contenere elementi problematici indipendentemente dal rapporto contrattuale con OpenAI.
Se chiedi, per esempio, di utilizzare:
- un marchio di terzi;
- un personaggio protetto;
- un’opera esistente;
- materiale che non eri autorizzato a caricare;
l’assegnazione dell’output da parte del provider non elimina i diritti che potrebbero appartenere ad altri soggetti.
Nelle condizioni OpenAI, infatti, resta in capo all’utente la responsabilità di avere i diritti, licenze e permessi necessari per fornire gli input.
Per progetti commerciali sensibili, una valutazione legale specifica è più affidabile di qualsiasi regola generale sull’“AI copyright”.
Immagini di persone reali e autenticità
Anche la possibilità tecnica di generare o modificare un’immagine non implica che ogni utilizzo sia consentito.
Le politiche OpenAI includono restrizioni relative alla privacy e all’utilizzo dell’immagine fotorealistica o della voce di una persona senza consenso quando ciò può creare confusione sull’autenticità.
Il problema, in pratica, non è soltanto “questa immagine è generata dall’AI?”.
È anche:
chi rappresenta?
come viene presentata?
potrebbe essere scambiata per una documentazione reale?
il soggetto ha autorizzato quell’utilizzo?
C2PA e SynthID: come viene indicata la provenienza
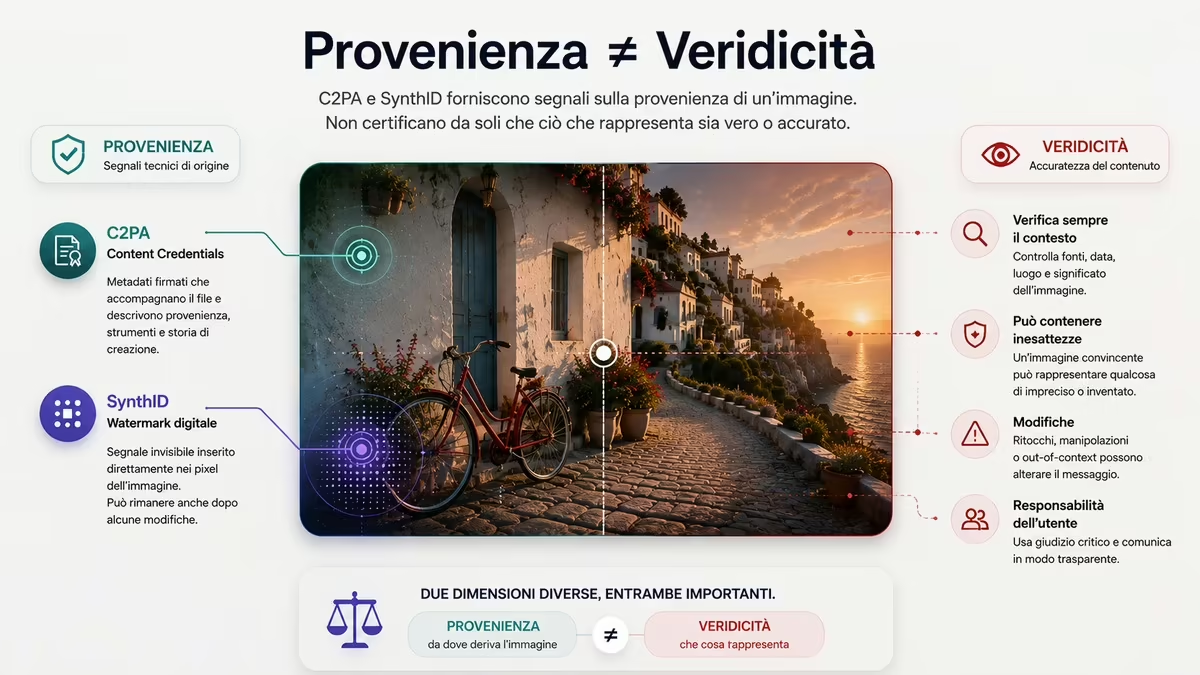
OpenAI utilizza oggi due tipi di segnali di provenienza sulle immagini supportate generate dai propri strumenti: Content Credentials C2PA e watermark SynthID.
C2PA utilizza metadati che possono fornire informazioni sulla provenienza del file.
SynthID inserisce invece un segnale nel contenuto stesso, che può sopravvivere ad alcune modifiche anche quando i metadati vengono eliminati.
Le due tecniche sono complementari.
Ma c’è un limite importante: la presenza di un segnale di provenienza non certifica che ciò che l’immagine rappresenta sia vero.
OpenAI precisa che questi segnali non garantiscono che il contenuto sia accurato, non modificato, posseduto legalmente o presentato nel contesto corretto. La copertura può inoltre variare in base a prodotto, modello, formato, metodo di esportazione e momento della creazione.
È un punto particolarmente utile in ambito editoriale: provenienza e veridicità sono due problemi differenti.
DALL·E vs altri generatori di immagini AI: cosa scegliere
Non esiste oggi un confronto serio che possa essere ridotto a “DALL·E vs Midjourney vs Stable Diffusion”.
Il mercato è diventato più articolato e, soprattutto, gli strumenti seguono filosofie differenti.
Per fare un confronto utile bisogna quindi definire prima i criteri.
I principali sono:
- workflow conversazionale;
- capacità di editing;
- aderenza alle istruzioni;
- controllo estetico;
- testo e layout;
- immagini di riferimento;
- API;
- disponibilità dei pesi;
- possibilità di esecuzione su infrastruttura propria;
- costo;
- livello tecnico richiesto.
Senza un benchmark first-party condotto con gli stessi prompt e criteri non avrebbe senso dichiarare un vincitore assoluto. Possiamo però confrontare come sono progettati e per quali workflow vengono proposti oggi.
Se la tua domanda non riguarda specificamente l’ecosistema OpenAI, puoi partire direttamente dalla guida ai generatori di immagini AI, dove lo stesso metodo viene applicato all’intera categoria e la scelta parte dal workflow anziché dal nome del modello.
| Sistema | Modello/superficie attuale | Caratteristica strutturale | Da valutare soprattutto se… |
|---|---|---|---|
| OpenAI | ChatGPT Images / GPT Image 2 | generazione ed editing integrati nel workflow conversazionale, più API | vuoi iterare attraverso il linguaggio naturale o integrare image generation in un prodotto |
| Midjourney | V8.2 | il vendor concentra l’ultima release su estetica, qualità e personalizzazione | la direzione estetica e la personalizzazione visuale sono una priorità |
| Nano Banana 2 | Google punta su generazione/editing rapidi, conoscenza del mondo e integrazione nell’ecosistema Gemini | lavori già con Gemini o vuoi un workflow visuale integrato nei prodotti Google | |
| Ideogram | Ideogram 4.0 | open weights, forte enfasi su testo, layout e controllo | tipografia, layout o possibilità di usare pesi aperti sono requisiti importanti |
| Stability AI | Stable Diffusion 3.5 | famiglia di modelli scaricabili e personalizzabili | vuoi maggiore controllo sulla pipeline o deployment su infrastruttura gestita da te |
OpenAI documenta GPT Image 2 come proprio modello corrente per generazione ed editing. Midjourney indica V8.2 come versione predefinita e la descrive come un aggiornamento orientato a estetica, qualità dell’immagine e personalizzazione. Google presenta Nano Banana 2 come modello di generazione ed editing rapido con capacità derivate dal proprio ecosistema Gemini. Ideogram 4.0 è disponibile con open weights e include capacità specifiche per testo e layout. Stability AI mantiene Stable Diffusion 3.5 come propria famiglia più recente di base model scaricabili e personalizzabili.
Quando sceglierei ChatGPT Images o GPT Image 2
Ha molto senso quando la generazione è parte di un processo conversazionale.
Non devi decidere tutto prima di iniziare.
Puoi osservare l’output, descrivere il problema e continuare a iterare.
È particolarmente utile per:
- concept;
- variazioni;
- editing;
- visual editoriali;
- brainstorming;
- trasformazioni partendo da immagini;
- workflow applicativi tramite API.
Quando valuterei Midjourney
La direzione di prodotto di Midjourney continua a dare grande peso al lato estetico e alla personalizzazione. La versione corrente ha inoltre un’interfaccia web completa: descriverlo semplicemente come “un bot che funziona su Discord”, come fanno ancora molte vecchie comparative, non rappresenta più bene il prodotto.
Lo valuterei quando esplorazione visuale, stile e personalizzazione estetica hanno molto peso nel progetto.
Non dedurrei però da questa caratteristica che sia automaticamente migliore per qualsiasi fotografia, grafica, prodotto o briefing.
Quando valuterei Nano Banana 2
Google integra Nano Banana 2 nel proprio ecosistema Gemini e lo presenta come un modello orientato a generazione ed editing rapidi, subject consistency e utilizzo della conoscenza disponibile nel sistema.
È quindi particolarmente interessante quando il lavoro visuale è già inserito in un flusso Gemini o Google.
Anche qui la scelta dovrebbe partire dal workflow, non dal nome del modello.
Quando valuterei Ideogram 4.0
Ideogram 4.0 ha costruito una parte significativa della propria identità intorno a testo dentro le immagini e controllo del layout.
Con la versione 4.0 ha aggiunto un elemento ancora più distintivo: gli open weights.
Questo lo rende interessante non soltanto per l’utente che vuole creare un poster, ma anche per sviluppatori e organizzazioni che vogliono maggiore controllo sull’infrastruttura o sul fine-tuning.
Quando valuterei Stable Diffusion 3.5
Stable Diffusion mantiene un vantaggio strutturale molto particolare: il modello può far parte di pipeline che l’utente controlla in misura molto maggiore rispetto ai servizi completamente chiusi.
Stability AI mette a disposizione diverse varianti della famiglia 3.5, comprese versioni pensate per differenti compromessi fra dimensioni, prestazioni e qualità.
Questa flessibilità comporta però anche un rovescio della medaglia: configurare, personalizzare e gestire una pipeline può richiedere competenze e infrastruttura che un’interfaccia come ChatGPT nasconde completamente.
La domanda quindi non è:
“Qual è il generatore più potente?”
ma:
“Quanto controllo voglio assumermi direttamente?”
Quando usare un generatore di immagini AI nel lavoro reale
La generazione visiva funziona particolarmente bene quando il costo dell’esplorazione è normalmente elevato.
Se realizzare quattro concept richiederebbe ore e quello che ti serve in questa fase è decidere una direzione, produrre rapidamente più ipotesi può avere un enorme valore.
Il discorso cambia quando sei già nella fase in cui ogni dettaglio deve essere esatto.
Concept e brainstorming visivo
È probabilmente uno degli usi più naturali.
Puoi trasformare un brief astratto in qualcosa che il cliente o il team riesca a discutere.
Invece di dire:
“immagino una campagna minimalista, materica, con una forte presenza del prodotto”,
puoi generare diverse interpretazioni, scartare quelle sbagliate e capire quale direzione merita sviluppo.
Il risultato iniziale non deve essere necessariamente il materiale finale.
Può essere un oggetto di discussione.
Ed è spesso questo il valore più grande della generazione: rendere visibile un’idea quando è ancora economico cambiarla.
Immagini editoriali, social e marketing
Per blog, social media e campagne digitali la generazione può essere utile quando un’immagine stock non racconta realmente il concetto.
Un articolo su autenticazione a due fattori non ha bisogno dell’ennesimo lucchetto blu.
Può rappresentare il vero meccanismo: una persona che accede da un computer e conferma l’identità su un secondo dispositivo.
Un articolo sulla cache web non deve necessariamente mostrare una nuvola con frecce.
Può visualizzare la differenza fra recuperare ogni volta una risorsa dalla sorgente e servirne una copia già disponibile vicino all’utente.
Qui l’AI diventa interessante quando ti permette di produrre visual specifici del concetto, non immagini genericamente tecnologiche.
Mockup e direzione creativa
Un altro scenario efficace è anticipare visivamente una decisione.
Puoi simulare:
- un packaging;
- una ambientazione;
- un set fotografico;
- un concept di campagna;
- una moodboard;
- una hero image;
- un ambiente;
- una combinazione di materiali.
L’importante è presentare correttamente il risultato.
Un mockup generativo è un concept, non sempre una specifica esecutiva.
Se l’AI aggiunge una giunzione impossibile a un mobile o altera le proporzioni di un prodotto, il visual può continuare a essere utile per parlare di atmosfera ma non per costruire l’oggetto.
Dove designer e art director restano necessari
L’aumento della capacità dei modelli non elimina la necessità di giudizio.
Anzi, quando produrre alternative diventa molto facile, scegliere bene diventa più importante.
Un professionista deve ancora decidere:
- quale messaggio deve comunicare l’immagine;
- qual è la gerarchia;
- quanto è coerente con il brand;
- cosa va mantenuto invariato;
- cosa è tecnicamente o semanticamente scorretto;
- se l’asset funziona nel layout reale;
- se testo e colori sono corretti;
- se la fonte visuale è appropriata;
- quali rischi di licenza, privacy o autenticità esistono;
- quando smettere di generare e finalizzare.
La disponibilità di un generatore non sostituisce un sistema visuale.
Rende più economico produrre materiale all’interno di quel sistema — se il sistema esiste.
Conclusione
DALL·E rimane uno dei nomi più importanti della generazione di immagini con l’intelligenza artificiale, ma non è più il nome che descrive meglio ciò che un utente OpenAI utilizza operativamente.
Se vuoi creare o modificare immagini attraverso una conversazione, il riferimento è ChatGPT Images.
Se devi integrare la generazione in un’applicazione, automatizzare un processo o lavorare programmaticamente, il riferimento corrente è GPT Image 2.
DALL·E 2 e DALL·E 3 sono invece parte della generazione precedente e non vanno più presentati come alternative API attuali.
Il cambiamento più interessante, però, non riguarda soltanto il nome del modello.
Il workflow stesso è maturato.
Non si tratta più semplicemente di scrivere una frase e sperare che il generatore produca qualcosa di bello. Puoi partire da immagini esistenti, iterare, correggere parti della scena, definire formati, guidare composizione e testo e collegare la generazione a sistemi software.
Questo aumenta molto ciò che puoi fare, ma anche ciò che devi saper valutare.
Prompt più lunghi non garantiscono output migliori. Immagini più realistiche non garantiscono maggiore accuratezza. E un generatore più nuovo non è automaticamente la scelta migliore per ogni progetto.
Per un lavoro occasionale, partirei da ChatGPT Images e lavorerei per iterazioni.
Per automazione e prodotti digitali, valuterei GPT Image 2 tramite API.
Per esigenze specifiche — forte direzione estetica, ecosistema Gemini, tipografia e layout, open weights o pipeline self-hosted — confronterei anche Midjourney, Nano Banana, Ideogram e Stable Diffusion usando criteri legati al progetto reale.
È questo il punto in cui la generazione di immagini AI smette di essere una curiosità: quando non scegli il modello che produce l’immagine più spettacolare al primo tentativo, ma lo strumento che ti permette di arrivare al risultato corretto con il workflow più adatto.