
Il riconoscimento facciale è una forma di riconoscimento biometrico che confronta le caratteristiche di un volto per verificare o identificare una persona. La definizione sembra semplice, ma nasconde una distinzione decisiva: trovare un volto dentro una fotografia non significa sapere a chi appartiene, e controllare che il volto davanti a una fotocamera corrisponda a quello già registrato non equivale a cercare una persona in un database con migliaia o milioni di identità.
Per capire davvero come funziona questa tecnologia conviene quindi separare tre operazioni: face detection, verifica 1:1 e identificazione 1:N. Da questa differenza dipendono l’architettura tecnica, il tipo di errore più pericoloso, la quantità di dati necessari e anche il livello di rischio per la privacy.
In questa guida vediamo cosa succede dal momento in cui una fotocamera acquisisce un volto fino alla decisione di corrispondenza, perché Face ID è un caso diverso dalla sorveglianza biometrica, quanto sono affidabili i sistemi moderni e quali limiti impongono GDPR, AI Act e normativa italiana.
Cos’è il riconoscimento facciale e cosa non è
Un sistema di riconoscimento facciale utilizza il volto come caratteristica biometrica per stabilire se due rappresentazioni appartengano alla stessa persona oppure per cercare una possibile identità all’interno di un insieme di candidati.
Microsoft descrive infatti il face recognition come un processo di verifica o identificazione di individui tramite il volto. È una formulazione più precisa di quella, ancora frequente, che usa “face detection” e “riconoscimento facciale” come sinonimi.
Face detection e face recognition non sono la stessa cosa
La face detection risponde a una domanda del tipo: “c’è un volto in questa immagine e dove si trova?”. Il sistema può restituire le coordinate dell’area occupata dal viso e, a seconda del modello, altre informazioni utili all’elaborazione.
Il riconoscimento, invece, introduce il confronto con una rappresentazione di riferimento. Non basta quindi localizzare occhi, naso e bocca: bisogna trasformare il volto in dati confrontabili e valutare la somiglianza rispetto a uno o più template.
Questa distinzione evita un errore molto comune. Un filtro social che segue il viso per applicare una maschera grafica può usare il rilevamento facciale senza identificare affatto la persona. Allo stesso modo, un software che sfoca automaticamente i volti in un video deve prima trovarli, ma non ha necessariamente bisogno di sapere a chi appartengono.
| Operazione | Domanda a cui risponde | Confronto principale | Esempio |
|---|---|---|---|
| Face detection | C’è un volto e dove si trova? | Nessuna identità necessaria | individuare i volti da sfocare |
| Verifica 1:1 | Questa persona è quella che dichiara di essere? | un volto contro un riferimento | sblocco di un dispositivo |
| Identificazione 1:N | Chi è questa persona tra quelle presenti nel database? | un volto contro molti candidati | ricerca di un’identità in una watchlist |
Verifica 1:1 e identificazione 1:N: perché la differenza conta
Nella verifica 1:1 il sistema confronta il volto acquisito con un’identità già dichiarata o registrata. La domanda è binaria: “questa è la stessa persona?”. È il modello tipico dell’autenticazione biometrica.
Nel riconoscimento biometrico usato per autenticazione, questo modello limita il confronto a un riferimento già associato all’identità dichiarata, evitando la ricerca attraverso un’intera popolazione di candidati.
Nell’identificazione 1:N, invece, il sistema deve cercare tra molte identità e restituire uno o più candidati. La documentazione Azure distingue esplicitamente Verify, che effettua un confronto uno a uno, da Identify, che valuta il volto rispetto a un gruppo di persone.
L’identificazione facciale 1:N pone quindi un problema diverso dalla semplice autenticazione: il sistema non deve confermare un’identità già dichiarata, ma selezionare le corrispondenze più plausibili all’interno di un insieme più ampio.
All’aumentare del numero di candidati cambia anche il problema statistico. Un match che sembra convincente quando confronti due sole rappresentazioni può diventare meno significativo quando cerchi la migliore somiglianza fra milioni di elementi. Per questo la dimensione del database, la soglia scelta e il contesto operativo contano almeno quanto il nome dell’algoritmo.
Template biometrico ed embedding: cosa viene realmente confrontato
I sistemi moderni non lavorano semplicemente sovrapponendo due fotografie e contando quanti pixel coincidono.
Una pipeline di riconoscimento estrae dal volto una rappresentazione numerica che conserva informazioni utili a distinguere un’identità da un’altra riducendo, per quanto possibile, l’effetto di variazioni come posa, luce o espressione. Nel deep learning questa rappresentazione viene spesso chiamata embedding.
Il paper FaceNet, uno dei lavori che hanno reso popolare questo approccio, descrive uno spazio numerico in cui la distanza tra le rappresentazioni corrisponde a una misura di somiglianza facciale. I sistemi attuali possono utilizzare architetture differenti, ma il modello mentale resta utile: il confronto avviene fra rappresentazioni matematiche, non fra due fotografie osservate “come farebbe una persona”.
È anche il motivo per cui parlare genericamente di “scansione del volto” può essere fuorviante. La scansione è solo l’ingresso del processo; ciò che conta per il matching è la rappresentazione costruita dal sistema e il modo in cui viene confrontata con quelle di riferimento.
Come funziona il riconoscimento facciale
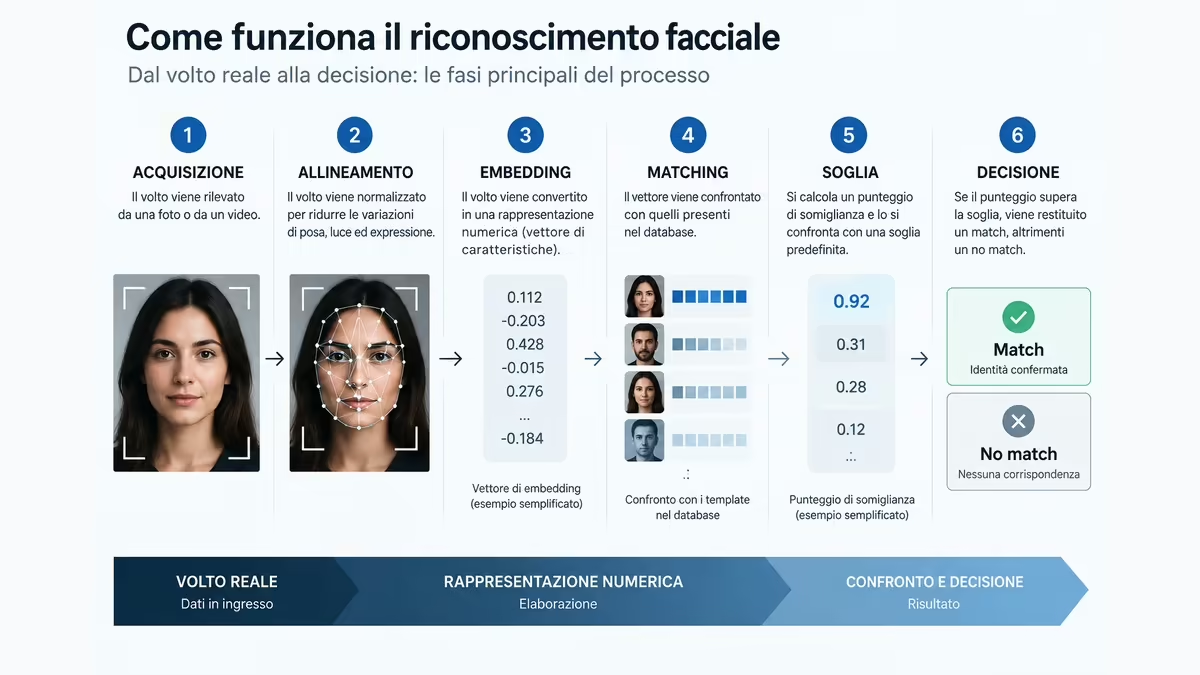
Una pipeline reale può cambiare molto tra smartphone, controllo accessi, servizi cloud e sistemi investigativi. Il percorso logico, però, può essere ricondotto a cinque fasi: acquisizione, normalizzazione, rappresentazione, matching e decisione.
1. Individuazione e acquisizione del volto
Nel riconoscimento facciale, la prima fase consiste nel trovare il volto nell’immagine o nel flusso video. Qui entra in gioco la face detection.
Il sistema delimita l’area del viso e valuta se l’immagine sia abbastanza utilizzabile. Controluce, occhi coperti, volto troppo piccolo, mosso o ruotato possono ridurre la qualità già prima del riconoscimento. La documentazione Microsoft, per esempio, segnala tra i fattori problematici illuminazione estrema, occlusioni, cambiamenti legati all’età ed espressioni molto marcate.
L’acquisizione può usare una normale fotocamera RGB oppure sensori aggiuntivi, come infrarossi o profondità. Non significa che un sistema 3D sia automaticamente migliore in ogni scenario: dipende da come viene progettato il confronto e dal tipo di attacco o variazione che deve gestire.
2. Allineamento e normalizzazione dell’immagine
Un volto fotografato perfettamente di fronte e uno ruotato di trenta gradi non sono due input equivalenti.
Prima di costruire la rappresentazione biometrica, il software può quindi normalizzare dimensioni, orientamento e posizione del viso. I punti di riferimento facciali aiutano ad allineare immagini che arrivano da pose leggermente differenti.
L’obiettivo non è “abbellire” la foto, ma rendere il confronto meno dipendente da elementi accidentali. Una normalizzazione scadente può propagare l’errore alle fasi successive anche se il modello di riconoscimento è buono.
3. Estrazione delle caratteristiche e creazione dell’embedding
Il volto normalizzato viene elaborato da un modello che produce una rappresentazione numerica compatta.
Nei sistemi basati su deep learning, la rete apprende quali pattern sono utili a separare identità differenti. Non va immaginata come un elenco fisso del tipo “distanza tra gli occhi = X, larghezza del naso = Y”. Quelle misure geometriche hanno avuto un ruolo importante nei sistemi storici, ma le architetture moderne imparano rappresentazioni molto più complesse dai dati.
Questo passaggio è uno dei punti in cui qualità e composizione del dataset di addestramento diventano decisive. Se il modello ha visto male alcune condizioni o popolazioni, la rappresentazione può essere meno robusta proprio nei casi in cui servirebbe maggiore affidabilità.
4. Matching, similarity score e soglia di decisione
A questo punto il sistema confronta la rappresentazione appena prodotta con quella di riferimento o con quelle presenti nel database.
Il risultato normalmente non è una verità assoluta, ma un punteggio di somiglianza. Una soglia trasforma poi quel valore in una decisione operativa: corrispondenza accettata, rifiutata oppure candidato da sottoporre a ulteriore verifica.
È qui che entra uno dei trade-off più importanti. Abbassare la soglia può ridurre i casi in cui il sistema non riconosce la persona corretta, ma può aumentare le corrispondenze errate. Alzarla può fare il contrario.
Per questo “il software ha il 99% di accuratezza” è una frase quasi inutile se non sappiamo quale errore viene misurato, a quale soglia, su quale dataset e in quale scenario.
5. Liveness detection e protezione dallo spoofing
Riconoscere che due volti sembrano appartenere alla stessa persona non basta per costruire un sistema di autenticazione sicuro. Bisogna anche capire se davanti al sensore c’è una persona reale e presente, non una fotografia, un video riprodotto su uno schermo, una maschera o un artefatto più sofisticato.
La liveness detection cerca proprio segnali di presenza reale. Le tecniche possono usare profondità, infrarossi, movimenti, caratteristiche della pelle, challenge attive o combinazioni di più segnali.
Apple, per esempio, spiega che Face ID utilizza la fotocamera TrueDepth per creare una mappa di profondità e un’immagine a infrarossi, trasformandole in una rappresentazione matematica protetta nella Secure Enclave. Apple dichiara inoltre meccanismi anti-spoofing e verifica dello sguardo.
Questo non rende qualsiasi “sblocco col volto” equivalente a Face ID. Due smartphone possono offrire la stessa esperienza apparente — guardi lo schermo e si sblocca — pur usando sensori, modelli e livelli di sicurezza molto diversi.
Dove viene usato il riconoscimento facciale
La stessa tecnologia di base può essere inserita in sistemi con conseguenze molto differenti. È quindi più utile ragionare per scenario e architettura che parlare genericamente di “pro e contro del riconoscimento facciale”.
Smartphone e Face ID
Lo sblocco di uno smartphone è il caso più familiare. Qui il dispositivo sa già quale identità deve verificare: quella registrata dal proprietario.
Face ID è quindi soprattutto un esempio di verifica biometrica 1:1 locale. Apple dichiara che i dati facciali e le rappresentazioni matematiche restano sul dispositivo, protetti dalla Secure Enclave, e non vengono inclusi nei backup iCloud. Dichiara inoltre una probabilità di falso riconoscimento casuale di circa 1 su 1.000.000 con un solo Face ID registrato, specificando condizioni in cui il rischio può essere maggiore, come gemelli, fratelli molto somiglianti e bambini piccoli.
Quel numero non va trasferito ad altri sistemi. È un dato riferito all’architettura Face ID e alle condizioni descritte da Apple, non una misura universale della biometria facciale.
Verifica dell’identità, banche e controllo degli accessi
La verifica del volto può essere usata per confermare che la persona presente davanti alla fotocamera corrisponda al documento o all’identità già dichiarata.
È un modello comune nell’onboarding remoto, nel controllo accessi e in alcuni flussi di viaggio. La domanda resta “questa persona corrisponde a questo riferimento?”, ma il rischio cambia se il template viene conservato localmente, su un dispositivo controllato dall’utente o in un database centralizzato.
Questo dettaglio non è secondario. Un database centralizzato di template può diventare un obiettivo di grande valore e amplificare l’impatto di una violazione.
Aeroporti e controllo di frontiera
Negli aeroporti la biometria può servire a velocizzare il passaggio tra check-in, controlli e imbarco, ma non esiste un unico modello tecnico.
Un sistema può effettuare una verifica 1:1 rispetto al documento di viaggio oppure una identificazione 1:N rispetto a un archivio. Il Garante Privacy ha affrontato concretamente questa distinzione nel provvedimento sul sistema FaceBoarding dell’aeroporto di Milano Linate, soffermandosi su architettura centralizzata, template biometrici, cifratura, base giuridica e controllo effettivo dell’interessato sui dati.
Il caso è utile perché mostra quanto sia riduttivo chiedersi soltanto “il riconoscimento facciale è comodo?”. Occorre capire dove si crea il template, chi lo conserva, per quanto tempo, con quale base giuridica e contro quale insieme viene confrontato.
Foto, video e organizzazione delle immagini
Il riconoscimento può anche raggruppare fotografie della stessa persona all’interno di una raccolta privata o di un servizio fotografico. In questo contesto, espressioni come “riconoscimento volti” possono indicare funzioni di clustering che non arrivano necessariamente all’identificazione anagrafica della persona.
Qui va mantenuto un confine netto con la ricerca visiva. Trovare immagini simili, oggetti, prodotti o copie della stessa fotografia non richiede necessariamente l’identificazione biometrica della persona ritratta.
Anche due funzioni che nell’interfaccia sembrano molto simili possono quindi lavorare su problemi diversi: “trova altre foto con questo volto” non è la stessa cosa di “dimmi chi è questa persona nel mondo reale”.
Videosorveglianza e identificazione nelle attività di polizia
Il salto di rischio più grande arriva quando il volto di una persona viene acquisito senza una sua azione esplicita e confrontato con database o watchlist per identificarla in uno spazio pubblico.
L’identificazione facciale basata su watchlist può operare su molte persone contemporaneamente e produrre conseguenze significative anche per chi non è l’obiettivo dell’indagine. La qualità delle telecamere, la distanza, l’angolo del volto, la dimensione della watchlist e la soglia di matching diventano elementi determinanti.
È proprio questa differenza di scala e controllo che spiega perché la normativa europea tratti l’identificazione biometrica remota in modo molto più rigoroso rispetto allo sblocco personale di uno smartphone.
Quanto è affidabile il riconoscimento facciale
La risposta più corretta non è una percentuale: dipende dal sistema, dal dataset, dalla soglia e dallo scenario.
Il NIST mantiene una valutazione continuativa degli algoritmi con due programmi distinti per verifica 1:1 e identificazione 1:N. Già questa separazione fa capire perché non abbia senso cercare un singolo numero capace di descrivere “l’accuratezza del riconoscimento facciale”.
Falsi positivi e falsi negativi
Nella verifica 1:1, un false match si verifica quando il sistema considera corrispondenti due volti di persone diverse. Un false non-match avviene invece quando rifiuta due rappresentazioni della stessa persona.
Nell’identificazione 1:N le metriche cambiano perché il sistema ricerca all’interno di un insieme di candidati. NIST utilizza, tra le altre, FNIR e FPIR: la prima misura la quota di ricerche con soggetto presente che non restituiscono correttamente il match sopra soglia; la seconda la quota di ricerche con soggetto non presente che producono comunque uno o più candidati sopra soglia.
Gli errori non hanno lo stesso costo. In uno smartphone, un falso rifiuto può essere soprattutto fastidioso perché costringe a inserire il codice. In un contesto investigativo, un falso candidato può invece portare una persona innocente a ulteriori controlli.
Perché una percentuale di accuratezza da sola dice poco
Immagina due sistemi dichiarati “accurati al 99%”. Il primo viene usato per verificare l’utente che sta aprendo la propria app bancaria. Il secondo cerca una persona in una folla confrontando ogni volto con una watchlist molto grande.
La percentuale aggregata può essere identica e il rischio operativo completamente diverso.
Serve sapere almeno quale popolazione è stata testata, quali immagini sono state usate, quale soglia determina il match, quanto è grande il database e come vengono gestiti i casi incerti. Senza queste informazioni, il numero comunica più sicurezza di quanta ne dimostri.
Luce, posa, distanza, qualità dell’immagine e dimensione del database
Una fotografia frontale, nitida e ben illuminata non pone lo stesso problema di un fotogramma estratto da una telecamera distante.
Controluce, occlusioni, movimento, risoluzione, angolo del volto e invecchiamento possono peggiorare l’input. La stessa documentazione dei servizi di riconoscimento moderni raccomanda immagini di qualità sufficiente e segnala che alcune condizioni possono impedire il match.
Nei sistemi 1:N si aggiunge poi il database. Più candidati significa più confronti e maggiore necessità di calibrare soglie e procedure di revisione.
Bias e differenze demografiche nei sistemi di riconoscimento
Un algoritmo può avere buone prestazioni medie e comportarsi peggio su alcuni gruppi.
Il NIST ha documentato differenze demografiche nei tassi di errore di numerosi algoritmi di riconoscimento facciale. Non significa che ogni sistema presenti lo stesso bias o che le differenze siano immutabili: variano tra algoritmi, dataset e condizioni. Significa però che la performance media non basta per valutare equità e rischio.
La domanda corretta non è quindi “il riconoscimento facciale è biased sì o no?”, ma come cambiano false match e false non-match tra i gruppi rilevanti per quello specifico sistema e quello specifico uso.
Questo punto diventa particolarmente importante quando un errore può negare un servizio, produrre un allarme o contribuire a una decisione su una persona.
Riconoscimento facciale e ricerca per immagini: qual è la differenza
Partire da una foto per cercare risultati sul Web e identificare biometricamente una persona sono operazioni diverse, anche se nell’esperienza utente possono sembrare vicine.
Una ricerca inversa può trovare copie della stessa fotografia, versioni modificate o pagine in cui quell’immagine compare. Un sistema di ricerca visuale può riconoscere oggetti, prodotti, luoghi o elementi della scena. Nessuna di queste capacità implica automaticamente un confronto biometrico dell’identità.
Trovare immagini simili non significa identificare una persona
Se carichi una fotografia e un motore trova la stessa immagine pubblicata su una pagina che contiene un nome, hai ottenuto una pista contestuale. Il motore può aver riconosciuto la fotografia o elementi visivi, non necessariamente il volto in senso biometrico.
Al contrario, un sistema di identificazione facciale può confrontare il volto con un database anche senza cercare sul Web pagine contenenti quella stessa foto.
Sono due meccanismi che possono arrivare a risultati apparentemente simili attraverso percorsi tecnici differenti.
Quando un motore visuale riconosce oggetti e quando confronta volti
Il modo più semplice per orientarsi è chiedere quale sia l’unità che il sistema sta confrontando.
Se confronta immagini, caratteristiche visuali generali o contenuti indicizzati, siamo nell’ambito della ricerca per immagini e della computer vision. Se crea un template biometrico del volto per verificare o identificare una persona, siamo nel riconoscimento facciale.
Questa distinzione conta anche sul piano della privacy: una fotografia non diventa automaticamente un dato biometrico appartenente alle categorie particolari del GDPR soltanto perché contiene un viso.
Privacy e sicurezza: perché i dati biometrici richiedono più cautela
Il volto ha una caratteristica che lo rende diverso da una password: non puoi sostituirlo facilmente se il dato biometrico viene compromesso.
Questo non significa che da un template si possa sempre ricostruire una fotografia perfetta né che ogni implementazione abbia lo stesso rischio. Significa che i template e le rappresentazioni biometriche vanno progettati, conservati e protetti considerando conseguenze di lungo periodo.
Un template biometrico non è una normale password
Una password può essere cambiata. Un volto, un’impronta digitale o l’iride fanno parte della persona.
In un sistema di riconoscimento biometrico, la protezione del template è quindi un requisito strutturale e non un semplice dettaglio di implementazione.
Per questo un sistema ben progettato cerca di ridurre l’esposizione del dato biometrico attraverso elaborazione locale, cifratura, isolamento hardware, minimizzazione, tempi di conservazione limitati e separazione tra identità e template quando l’architettura lo consente.
Nel caso Face ID, per esempio, Apple dichiara che la rappresentazione matematica del volto resta sul dispositivo e viene protetta dalla Secure Enclave. È un modello molto diverso da un archivio centrale usato per confrontare persone differenti.
Conservazione, accesso al database e compromissione dei dati
La domanda “dove sono salvate le foto?” è utile ma non sufficiente. Un sistema può cancellare la foto originale e conservare comunque un template biometrico necessario al matching.
Conviene quindi verificare cosa viene memorizzato, se il template è cifrato, chi possiede le chiavi, chi può accedere al sistema, quanto dura la conservazione e se i dati vengono riutilizzati per altri scopi.
Il provvedimento del Garante su FaceBoarding mostra concretamente perché la conservazione centralizzata e il controllo dell’interessato siano elementi sostanziali, non semplici dettagli tecnici.
Sorveglianza di massa e uso dei dati per finalità diverse
Il rischio aumenta quando il riconoscimento passa da un’azione volontaria e circoscritta a un monitoraggio su larga scala.
Una persona che sblocca il proprio telefono sa di aver attivato la verifica. Una persona che attraversa uno spazio pubblico potrebbe invece essere acquisita e confrontata senza un’interazione visibile.
A cambiare non è soltanto la tecnologia: cambiano scala, aspettativa dell’interessato, controllo, finalità e conseguenze di un eventuale match.
Riconoscimento facciale, GDPR e AI Act: cosa cambia in Europa e in Italia
Sul piano giuridico bisogna evitare due semplificazioni opposte: “il riconoscimento facciale è vietato” e “basta il consenso”. Entrambe possono essere sbagliate se isolate dal contesto.
I dati biometrici nel GDPR
Il GDPR definisce dati biometrici quelli ottenuti da uno specifico trattamento tecnico relativo a caratteristiche fisiche, fisiologiche o comportamentali che consente o conferma l’identificazione univoca di una persona, citando espressamente le immagini facciali tra gli esempi.
L’articolo 9 introduce poi una protezione rafforzata per i dati biometrici trattati allo scopo di identificare in modo univoco una persona, prevedendo un divieto generale con specifiche eccezioni.
La sfumatura è importante: non ogni foto di un volto è automaticamente un dato biometrico speciale ai sensi dell’articolo 9. Conta il trattamento tecnico e la finalità di identificazione univoca.
AI Act: scraping dei volti, identificazione biometrica e usi vietati
L’AI Act aggiunge un secondo livello di regole per determinati sistemi di intelligenza artificiale.
Tra le pratiche vietate rientra la creazione o l’espansione di database di riconoscimento facciale tramite scraping indiscriminato di immagini da Internet o da sistemi CCTV. Il regolamento limita inoltre in modo molto severo l’identificazione biometrica remota in tempo reale negli spazi pubblicamente accessibili per finalità di law enforcement, prevedendo eccezioni ristrette e condizioni specifiche.
La Commissione europea distingue esplicitamente queste situazioni dall’autenticazione o verifica biometrica uno a uno, come lo sblocco dello smartphone. Questa distinzione nel quadro AI Act non elimina naturalmente gli obblighi derivanti da GDPR e altre norme applicabili.
Verifica sul dispositivo e identificazione biometrica remota sono casi diversi
Il Comitato europeo per la protezione dei dati sottolinea nelle linee guida sul riconoscimento facciale per le forze dell’ordine che una verifica basata su un template custodito sul dispositivo personale non presenta lo stesso profilo di rischio di un sistema che identifica persone in un ambiente non controllato confrontandole con un vasto database.
È una distinzione utile anche fuori dal settore di polizia: l’architettura e la scala contano quanto l’etichetta “riconoscimento facciale”.
La normativa italiana sulle attività di polizia
Il legislatore italiano ha inoltre adottato il D.Lgs. 9 settembre 2026, n. 160, pubblicato in Gazzetta Ufficiale il 15 settembre. Il provvedimento dedica un intero capo ai sistemi AI utilizzati nelle attività di polizia per categorizzazione biometrica, identificazione biometrica remota in tempo reale e riconoscimento facciale a posteriori.
Il testo ufficiale è consultabile nella Gazzetta Ufficiale. Per un progetto concreto, però, questa guida non sostituisce una valutazione legale: finalità, soggetto che tratta i dati, base giuridica, tecnologia impiegata e contesto possono cambiare completamente l’analisi.
App e software di riconoscimento facciale: cosa verificare prima di usarli
La query “app riconoscimento facciale” nasconde esigenze molto diverse. Alcuni utenti vogliono organizzare foto; altri cercano uno sblocco biometrico; altri ancora cercano un software di riconoscimento facciale capace di confrontare un volto con identità già registrate.
Un software di riconoscimento facciale può quindi offrire funzioni tecnicamente molto diverse dietro un’etichetta commerciale simile: dal semplice rilevamento dei volti fino al confronto biometrico con un archivio di identità.
Mettere questi strumenti nella stessa lista sarebbe poco utile e, in alcuni casi, fuorviante.
Riconoscimento, semplice rilevamento o ricerca inversa?
Prima di installare un software, controlla cosa fa realmente.
Se trova un volto in una fotografia, sta facendo detection. Se raggruppa immagini probabilmente appartenenti alla stessa persona, può usare similarity matching. Se cerca copie della fotografia sul Web, è ricerca inversa. Se confronta un volto con identità registrate per stabilire chi sia, entra nell’identificazione biometrica.
Il nome commerciale dell’app non garantisce quale di queste operazioni venga eseguita.
Elaborazione locale o cloud e gestione dei dati
Per un’app che utilizza il volto, la privacy policy non è un dettaglio da saltare.
Bisogna capire se foto e template vengono elaborati sul dispositivo o inviati a un server, per quanto tempo restano disponibili, se contribuiscono all’addestramento, se vengono condivisi con terzi e come puoi cancellarli.
Una funzione più comoda può avere un’architettura meno adatta a dati particolarmente sensibili. Non c’è quindi un “miglior software” indipendente dallo scenario.
Come leggere le promesse di accuratezza
Una percentuale pubblicitaria non basta.
Quando valuti un software di riconoscimento facciale, chiediti prima di tutto quale task sia stato misurato: verifica 1:1, identificazione 1:N, detection o un’altra funzione. Senza questa informazione, anche un numero apparentemente molto alto può essere poco significativo.
Un fornitore serio dovrebbe spiegare almeno quale task misura, quali metriche usa, in quali condizioni ha eseguito il test e come viene scelta la soglia. Per sistemi ad alto impatto servono inoltre test sul proprio dominio operativo, non solo benchmark generici del vendor.
Se il software viene usato per decidere accessi, controlli o indagini, la validazione deve essere proporzionata alle conseguenze dell’errore.
Quando un’app non è adatta a identificare una persona
Un risultato visivamente simile non è una prova d’identità.
Se stai cercando una persona partendo da una fotografia pubblica, un motore visuale può aiutarti a trovare contesti, copie e pagine correlate. Dovresti però trattare questi risultati come indizi da verificare, non come verdetti biometrici.
Lo stesso principio vale per applicazioni che restituiscono nomi o profili sulla base della somiglianza: senza sapere quale database utilizzano, come è stato costruito e con quali diritti vengono trattate le immagini, non puoi valutare seriamente né affidabilità né liceità.
Quando il riconoscimento facciale ha senso e quando è meglio evitarlo
Non esiste una risposta unica perché il costo dell’errore cambia radicalmente tra scenari.
| Scenario | Modello tipico | Vantaggio principale | Rischio da controllare | Criterio pratico |
|---|---|---|---|---|
| Sblocco dispositivo | verifica 1:1 locale | rapidità e comodità | spoofing e falso match | preferire architetture robuste e fallback sicuro |
| Accesso a un servizio | verifica 1:1 | ridurre frizione nell’identificazione | conservazione del template | minimizzare e proteggere i dati biometrici |
| Organizzazione foto | clustering/somiglianza | trovare immagini della stessa persona | profilazione e cloud storage | controllare dove vengono elaborati i dati |
| Controllo accessi fisico | 1:1 o 1:N | ingresso rapido | falso rifiuto/falso accesso | calibrare soglia e alternativa manuale |
| Ricerca in watchlist | identificazione 1:N | restringere candidati | falso positivo ad alto impatto | revisione umana e metriche adatte alla scala |
| Spazio pubblico | identificazione remota | ricerca automatizzata | sorveglianza, proporzionalità, diritti | verificare prima base legale, necessità e limiti |
Il criterio che userei è semplice: più il sistema decide su molte persone che non hanno iniziato volontariamente il confronto, più deve crescere il livello di giustificazione, controllo e verifica.
Domande frequenti sul riconoscimento facciale
Face ID è un sistema di riconoscimento facciale?
Sì, ma è più preciso descriverlo come sistema di autenticazione biometrica 1:1. Confronta il volto rilevato con la rappresentazione registrata sul dispositivo per verificare l’utente, invece di cercare chi sia una persona all’interno di un grande database di identità.
Il riconoscimento facciale può identificare una persona da una foto?
Può farlo se dispone di un database di riferimento adatto e se la qualità dell’immagine consente il confronto. Non significa che qualsiasi app o motore di ricerca possa identificare chiunque da una fotografia. Ricerca inversa, ricerca visuale e identificazione biometrica sono meccanismi differenti.
Una foto può ingannare un sistema di riconoscimento facciale?
Dipende dal sistema. Una semplice soluzione basata su immagine 2D può essere più vulnerabile, mentre sistemi con profondità, infrarossi e liveness detection sono progettati per riconoscere alcuni tentativi di spoofing. Nessun meccanismo dovrebbe però essere considerato invulnerabile senza test specifici.
Il riconoscimento facciale è legale in Italia?
Non esiste un sì o no valido per qualsiasi utilizzo. La liceità dipende dalla finalità, dal tipo di trattamento, dalla base giuridica, dall’architettura, dal contesto e dalle norme applicabili. GDPR, AI Act e disciplina nazionale impongono condizioni diverse tra autenticazione personale, servizi privati e identificazione biometrica remota nelle attività di polizia.
Qual è la differenza tra biometria e riconoscimento facciale?
La biometria è la categoria più ampia. Comprende tecniche basate su caratteristiche fisiche, fisiologiche o comportamentali, come volto, impronta, iride o voce. Il riconoscimento facciale è quindi una specifica applicazione biometrica centrata sulle caratteristiche del volto.
Conclusione
Il punto più importante da portarsi via non è che il riconoscimento facciale sia “sicuro” o “pericoloso” in assoluto. È che sotto la stessa etichetta convivono sistemi profondamente diversi.
Trovare un volto in una foto, verificare il proprietario di uno smartphone e cercare una persona in un database non sono tre versioni della stessa operazione. Cambiano il numero di confronti, il significato della soglia, il costo di un falso match, la quantità di dati trattati e il livello di controllo che la persona mantiene sulla propria biometria.
Quando devi valutare un sistema, partirei quindi da quattro domande: sta facendo detection, verifica o identificazione? Dove viene conservato il template? Quali false acceptance e false rejection produce nello scenario reale? Quali conseguenze ha un errore?
Per valutare il riconoscimento facciale in modo serio bisogna quindi guardare oltre il risultato finale e capire quale pipeline, quale database e quale soglia hanno prodotto quella decisione.
Se queste risposte non sono chiare, una percentuale di accuratezza o la promessa “AI-powered” servono a poco. Il riconoscimento facciale diventa davvero comprensibile solo quando si guarda al meccanismo completo: acquisizione → rappresentazione → confronto → soglia → decisione → conseguenza.