
Il Natural Language Processing (NLP), in italiano elaborazione del linguaggio naturale, è il campo dell’intelligenza artificiale e della linguistica computazionale che studia e sviluppa metodi per elaborare il linguaggio umano con un computer.
In pratica, entra in gioco ogni volta che un sistema deve fare qualcosa di utile con parole, frasi o documenti: riconoscere il sentiment di una recensione, classificare un’email, individuare nomi di persone e aziende in un testo, tradurre una frase, riassumere un documento, interpretare una ricerca o generare una risposta.
La definizione sembra semplice. Il problema è che il linguaggio umano semplice non lo è affatto.
La stessa parola può cambiare significato in base alla frase, una negazione può ribaltare il senso di un commento, un pronome può riferirsi a elementi comparsi molte righe prima e un’espressione perfettamente normale per una persona può essere ambigua per un modello.
L’NLP cerca quindi di trasformare il linguaggio in rappresentazioni che un sistema informatico possa analizzare e utilizzare, senza ridurre tutto alla semplice corrispondenza tra parole.
Ed è qui che conviene chiarire subito una distinzione diventata particolarmente importante: Natural Language Processing, Transformer, Large Language Model e AI generativa non sono sinonimi. Gli LLM hanno cambiato profondamente molti compiti linguistici, ma l’NLP è un campo molto più ampio e comprende anche approcci basati su regole, modelli statistici, classificatori specializzati, sistemi di estrazione e pipeline progettate per uno specifico task.
Vediamo come si incastrano tutti questi pezzi.
Natural Language Processing: cos’è e cosa significa NLP
NLP è l’acronimo di Natural Language Processing, espressione che viene normalmente tradotta con elaborazione del linguaggio naturale.
Per linguaggio naturale si intendono le lingue che le persone utilizzano per comunicare, come italiano, inglese o spagnolo, in contrapposizione ai linguaggi formali progettati con regole esplicite per scopi specifici, come un linguaggio di programmazione.
L’obiettivo dell’NLP non è necessariamente fare in modo che il computer “capisca” una frase nello stesso senso in cui la comprende una persona.
Questa formulazione è comoda nel linguaggio quotidiano, ma può essere fuorviante.
Più precisamente, un sistema NLP elabora una sequenza linguistica e produce un risultato utile al task per cui è stato progettato: una categoria, un’entità, una traduzione, una rappresentazione numerica, un riassunto, una risposta o un nuovo testo.
Per esempio:
“Il nuovo smartphone è veloce, ma la batteria mi ha deluso.”
Un sistema di sentiment analysis potrebbe rilevare una valutazione complessivamente mista. Un sistema più granulare potrebbe collegare un’opinione positiva a “veloce” e una negativa a “batteria”. Un modello di Named Entity Recognition, invece, cercherebbe eventuali persone, aziende, prodotti o luoghi presenti nella frase.
Lo stesso testo può quindi essere elaborato in modi completamente diversi a seconda del problema che vogliamo risolvere.
Quando e dove nasce il Natural Language Processing
Non esiste un giorno o un luogo unico che possa essere considerato la “nascita ufficiale” del Natural Language Processing.
Le sue radici moderne si sviluppano soprattutto negli anni Cinquanta dall’incontro tra informatica, linguistica, matematica e ricerca sull’intelligenza artificiale.
Nel 1950 Alan Turing pubblicò Computing Machinery and Intelligence, il lavoro nel quale propose l’imitation game, successivamente diventato noto come Turing Test. Il linguaggio e la conversazione assumevano già un ruolo centrale nella domanda su ciò che una macchina potesse essere in grado di fare.
Uno dei primi esperimenti concreti più conosciuti arrivò nel 1954 con il progetto Georgetown-IBM, che mostrò a New York la traduzione automatica di oltre sessanta frasi dal russo all’inglese. Era un sistema estremamente limitato rispetto agli standard attuali, ma rappresentò una dimostrazione importante delle possibilità della traduzione automatica. La storia e i limiti di quell’esperimento sono documentati nell’ACL Anthology.
Negli anni successivi arrivarono sistemi simbolici e conversazionali come ELIZA, mentre la ricerca si spostò progressivamente da regole scritte manualmente a metodi statistici, machine learning, reti neurali e infine Transformer.
Parlare di una singola invenzione dell’NLP è quindi poco preciso. È più corretto considerarlo un campo cresciuto per successive ondate tecnologiche.
NLP e linguistica computazionale sono la stessa cosa?
I due termini hanno una forte sovrapposizione, ma non devono essere considerati sempre perfettamente equivalenti.
La linguistica computazionale studia il linguaggio attraverso modelli e metodi computazionali e mantiene un legame molto forte con la linguistica.
Natural Language Processing viene spesso utilizzato in senso maggiormente applicativo: costruire sistemi in grado di analizzare, classificare, estrarre o generare linguaggio.
Nella ricerca e nei prodotti reali i confini possono diventare sfumati. La distinzione utile non è cercare una separazione assoluta, ma capire che un buon sistema NLP può richiedere competenze di linguistica, informatica, statistica e machine learning.
Come funziona il Natural Language Processing
Non esiste una singola pipeline che descriva tutti i sistemi NLP.
Un vecchio errore didattico consiste nel presentare sempre il processo come una sequenza obbligatoria:
testo → tokenizzazione → stemming → analisi sintattica → analisi semantica → output.
È una buona mappa per capire alcuni concetti, ma i sistemi moderni non devono necessariamente attraversare manualmente ogni fase.
Una pipeline spaCy, un classificatore basato su TF-IDF, un Transformer per Named Entity Recognition e un LLM che riceve un prompt possono elaborare il linguaggio in modi profondamente differenti.
Il modello mentale più utile è questo:
input linguistico → rappresentazione → modello o regole → task → output → valutazione
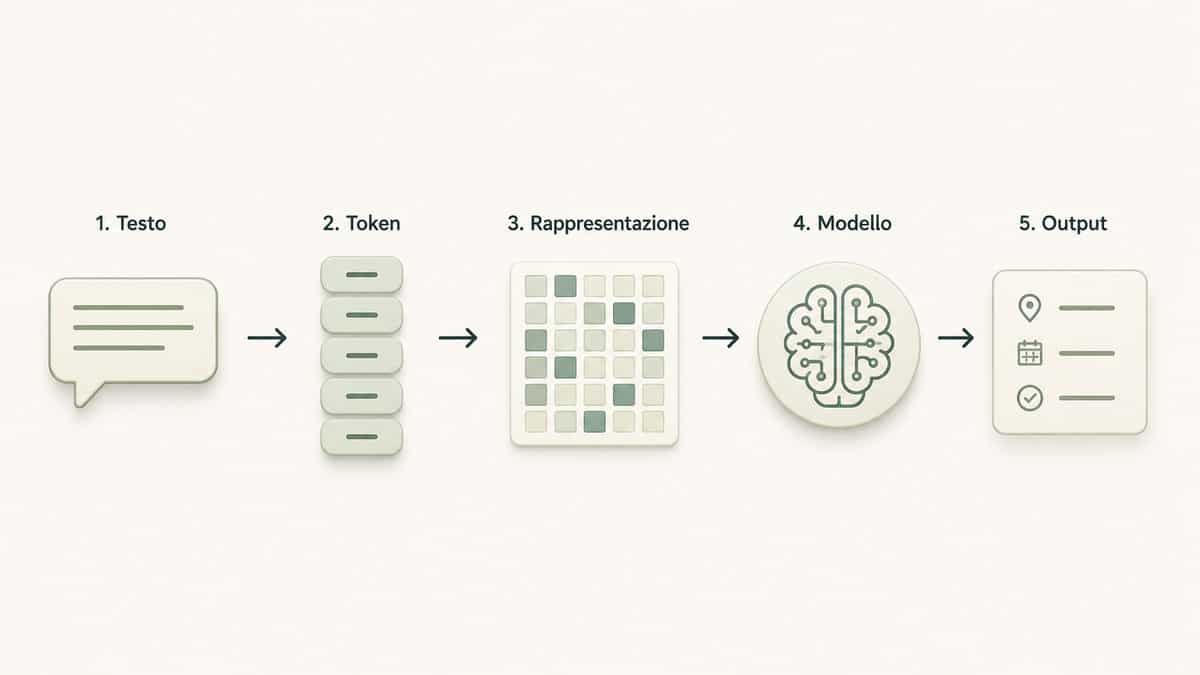
1. Definire il task
Prima ancora di scegliere il modello bisogna stabilire cosa deve fare il sistema.
Vuoi capire se una recensione è positiva?
Estrarre codici prodotto dalle email?
Individuare persone e aziende in migliaia di documenti?
Tradurre?
Riassumere?
Rispondere a domande?
La qualità di un progetto NLP dipende moltissimo da questa definizione. “Capire il testo” è troppo vago per essere un requisito tecnico.
2. Tokenizzazione: dividere il linguaggio in unità elaborabili
Uno dei primi problemi riguarda la tokenizzazione, cioè la suddivisione del testo in unità utilizzabili dal sistema.
Una frase potrebbe essere scomposta in parole, segni di punteggiatura o subword.
Prendiamo:
“L’intelligenza artificiale cambia rapidamente.”
Una tokenizzazione linguistica potrebbe separare parole e punteggiatura secondo determinate regole. Un moderno tokenizer utilizzato da un language model può invece dividere alcune parole in frammenti più piccoli.
Questo dettaglio è importante: un token non coincide necessariamente con una parola.
Tool come spaCy costruiscono pipeline nelle quali il testo viene prima tokenizzato e successivamente elaborato da componenti come lemmatizer, parser o entity recognizer.
3. Stemming e lemmatizzazione
In molte applicazioni tradizionali è utile ricondurre forme diverse di una parola a una rappresentazione più stabile.
Lo stemming utilizza generalmente regole relativamente meccaniche per ridurre le parole a una radice.
La lemmatizzazione cerca invece di ricondurle al lemma linguisticamente corretto.
Per esempio:
- “mangio” → “mangiare”;
- “andavano” → “andare”;
- “migliori” → “buono”, a seconda del contesto e del sistema utilizzato.
Non significa che stemming o lemmatizzazione siano obbligatori in ogni progetto. Nei modelli contestuali moderni molte informazioni vengono apprese direttamente dalle rappresentazioni prodotte dal modello.
4. Trasformare le parole in numeri
Un computer non elabora il significato di una frase come lo percepiamo noi.
Serve quindi una rappresentazione numerica.
Gli approcci possibili sono molti.
Metodi classici come Bag of Words e TF-IDF rappresentano un documento attraverso la presenza e l’importanza dei termini. Sono relativamente semplici, ma possono essere estremamente efficaci per classificazione, ricerca o baseline di progetto.
Con gli embedding, parole, frasi o documenti vengono invece rappresentati attraverso vettori numerici.
Il vantaggio è che la rappresentazione può catturare relazioni utili fra elementi linguisticamente o semanticamente vicini.
I modelli contestuali hanno fatto un passo ulteriore: la rappresentazione di una parola può cambiare in funzione delle parole che la circondano.
È fondamentale quando una stessa forma assume significati diversi.
“Banca” in “banca dati” e “banca che concede un mutuo” contiene la stessa sequenza di caratteri, ma il contesto cambia completamente ciò che il sistema dovrebbe ricavare.
5. Applicare un modello
Una volta ottenuta una rappresentazione dell’input, il sistema utilizza il modello o le regole previste dal progetto.
Potrebbe trattarsi di:
- regole e pattern;
- un classificatore statistico;
- un algoritmo di machine learning;
- una rete neurale;
- un modello di deep learning;
- un Transformer;
- un Large Language Model;
- una combinazione di più componenti.
La soluzione tecnicamente più sofisticata non è automaticamente quella migliore.
Se devi trovare con precisione codici fiscali o pattern perfettamente definiti, una regola può essere più semplice e affidabile di un modello generativo.
Se devi comprendere richieste aperte formulate in decine di modi differenti, la situazione cambia.
6. Valutare l’output
Un sistema NLP non dovrebbe essere giudicato perché “sembra intelligente”.
Va valutato sul task reale.
Per un classificatore possono contare precision, recall, F1 score o altre metriche appropriate.
Per un sistema di estrazione bisogna verificare quali entità trova, quali perde e quali inventa.
Per un sistema generativo la valutazione diventa più complessa: correttezza, pertinenza, copertura, fedeltà alle fonti, sicurezza e qualità linguistica possono richiedere metriche e controlli differenti.
Il modello è solo una parte del sistema. Dataset, task, valutazione e vincoli operativi contano altrettanto.
Quali sono i principali task del NLP
Natural Language Processing non descrive un unico problema.
È un contenitore di task differenti, alcuni dei quali esistevano molto prima degli attuali LLM.
| Task NLP | Cosa produce | Esempio |
|---|---|---|
| Classificazione del testo | una o più categorie | spam / non spam |
| Sentiment analysis | valutazione o polarità del testo | positivo / negativo / neutro |
| Named Entity Recognition | entità e relativa categoria | “Milano” → luogo |
| Part-of-Speech tagging | ruolo grammaticale dei token | nome, verbo, aggettivo |
| Parsing sintattico | relazioni grammaticali | soggetto, verbo, dipendenze |
| Traduzione automatica | testo in un’altra lingua | italiano → inglese |
| Riassunto | versione condensata | sintesi di un documento |
| Question answering | risposta a una domanda | risposta estratta o generata |
| Generazione di testo | nuova sequenza linguistica | risposta, descrizione, bozza |
| Ricerca semantica | risultati affini per significato | recupero di documenti pertinenti |
Classificazione del testo
Nella classificazione viene assegnata un’etichetta a una frase o a un documento.
Un help desk potrebbe classificare automaticamente i ticket in “fatturazione”, “problema tecnico”, “spedizione” o “richiesta commerciale”.
Un filtro email può distinguere messaggi legittimi da spam.
Una piattaforma editoriale può catalogare automaticamente i documenti per argomento.
Il vantaggio è evidente quando il volume diventa troppo elevato per una classificazione esclusivamente manuale.
Sentiment analysis
La sentiment analysis prova a stimare il tono o la polarità di un testo.
L’esempio classico è l’analisi delle recensioni.
Ma attenzione alla semplificazione.
“Bel prodotto. Peccato che si sia rotto dopo due giorni.”
Una semplice classificazione positiva/negativa può perdere gran parte dell’informazione utile. Anche sarcasmo, negazione, linguaggio tecnico e contesto possono creare difficoltà.
Per questo il risultato di un sistema di sentiment analysis va interpretato in relazione ai dati e al dominio su cui è stato valutato.
Named Entity Recognition
La Named Entity Recognition, abbreviata NER, serve a individuare entità all’interno del testo.
Per esempio:
“Mario Rossi lavora per Acme a Milano.”
Un modello potrebbe classificare:
- Mario Rossi → persona;
- Acme → organizzazione;
- Milano → località.
La NER è utile per trasformare grandi quantità di testo non strutturato in informazioni maggiormente organizzabili.
Può essere impiegata su articoli, contratti, ticket, documenti aziendali, cataloghi e archivi.
Analisi sintattica
Alcuni sistemi NLP analizzano anche la struttura grammaticale.
Possono determinare la categoria grammaticale dei token oppure costruire relazioni di dipendenza fra le parole della frase.
Queste informazioni non servono necessariamente in ogni pipeline moderna, ma restano utili in numerose applicazioni linguistiche, sistemi di estrazione e analisi del testo.
Traduzione, riassunto e question answering
Traduzione e riassunto mostrano bene come l’NLP sia passato dalla sola analisi alla trasformazione del linguaggio.
Nel question answering la distinzione è ancora più importante.
Un sistema può:
- estrarre da un documento un segmento già presente;
- recuperare documenti pertinenti;
- generare una risposta basandosi sul contesto ricevuto;
- combinare retrieval, regole, database e modello generativo.
Dire semplicemente “usa l’intelligenza artificiale per rispondere” nasconde quindi architetture molto diverse.
Ricerca semantica
La ricerca semantica prova a recuperare contenuti in base alla pertinenza del significato, non soltanto alla presenza letterale delle stesse parole.
Un utente può cercare:
“come recuperare la password del sito”
mentre il documento pertinente parla di:
“reimpostazione delle credenziali di accesso”.
Un buon sistema di retrieval può riconoscere la relazione anche senza una corrispondenza lessicale perfetta.
È uno dei casi in cui embedding e modelli linguistici hanno ampliato notevolmente ciò che possiamo costruire.
NLP, NLU e NLG: quali sono le differenze
NLP, NLU e NLG vengono spesso utilizzati come se fossero tre tecnologie indipendenti sullo stesso livello.
La relazione è più semplice se partiamo dal campo più ampio.
NLP comprende i metodi utilizzati per elaborare il linguaggio.
NLU, Natural Language Understanding, indica l’area orientata a ricavare significato, intenzioni, relazioni o informazioni dal linguaggio.
NLG, Natural Language Generation, riguarda invece la produzione di linguaggio naturale a partire da dati, rappresentazioni o istruzioni.
IBM descrive NLU e NLG come componenti correlate dell’ecosistema NLP, una distinzione più utile rispetto a considerarli semplicemente tre sinonimi.
| Concetto | Domanda principale | Esempio |
|---|---|---|
| NLP | Come elaboriamo il linguaggio? | pipeline complessiva |
| NLU | Che cosa possiamo ricavare dall’input? | intent, entità, significato |
| NLG | Come produciamo un output linguistico? | risposta o testo generato |
Natural Language Understanding: che cos’è la NLU
La NLU punta soprattutto all’interpretazione dell’input.
In un assistente per prenotazioni potremmo ricevere:
“Mi serve un tavolo domani sera per quattro.”
Il sistema potrebbe estrarre:
- intento → prenotare;
- numero persone → 4;
- data → domani;
- fascia temporale → sera.
Questi dati possono poi essere utilizzati dal software per interrogare disponibilità, applicare regole e completare l’operazione.
La NLU non richiede necessariamente un LLM. Intent classification, entity extraction e regole possono essere implementati attraverso molte architetture differenti.
Natural Language Generation: che cos’è la NLG
La NLG affronta la direzione opposta: produrre un testo comprensibile da informazioni disponibili nel sistema.
Un’applicazione meteo potrebbe trasformare dati strutturati in:
“Domani sono previste temperature più basse e piogge nel pomeriggio.”
Un assistente conversazionale può generare una risposta molto più articolata.
Con i moderni modelli generativi il confine è diventato meno visibile all’utente, perché uno stesso modello può ricevere testo, interpretarlo e produrre altro testo. Dal punto di vista progettuale, però, distinguere input, comprensione richiesta, logica applicativa e generazione resta estremamente utile.
NLP, Machine Learning, Deep Learning, Transformer e LLM: cosa cambia
Questa è probabilmente la parte in cui oggi si crea più confusione.
Natural Language Processing indica il campo e i problemi legati all’elaborazione del linguaggio.
Machine learning, deep learning, Transformer e Large Language Model indicano invece famiglie di metodi o modelli che possono essere utilizzati per affrontare quei problemi.
Non formano una semplice catena nella quale ogni tecnologia nuova elimina quella precedente.
Dalle regole al machine learning
I primi sistemi NLP facevano largo uso di regole linguistiche, dizionari e pattern progettati manualmente.
Questi approcci non sono spariti.
Se conosci perfettamente il formato che vuoi individuare, una regola può ancora essere la soluzione più trasparente.
Con il machine learning il sistema può invece apprendere regolarità a partire da esempi.
In una classificazione spam, per esempio, possiamo addestrare un modello su messaggi precedentemente etichettati invece di cercare di scrivere manualmente ogni possibile regola.
È il passaggio che conviene approfondire nella guida dedicata al machine learning: il modello apprende parametri dai dati invece di essere definito interamente attraverso istruzioni esplicite per ogni caso.
Deep learning e reti neurali
Il deep learning ha reso possibile apprendere rappresentazioni molto più complesse del linguaggio attraverso reti neurali con molteplici livelli di trasformazione.
Prima dei Transformer, architetture ricorrenti come RNN e LSTM erano molto utilizzate per sequenze linguistiche.
Hanno avuto un ruolo importante perché il testo è una sequenza: l’interpretazione di ciò che arriva dopo può dipendere da ciò che è arrivato prima.
Con sequenze lunghe, però, addestramento e gestione delle dipendenze possono diventare difficili.
È qui che i Transformer hanno cambiato il quadro.
Perché i Transformer hanno cambiato il Natural Language Processing
Nel paper Attention Is All You Need, pubblicato nel 2017, venne proposta l’architettura Transformer basata sull’attention, senza utilizzare ricorrenza o convoluzioni come struttura fondamentale del modello.
L’idea dell’attention permette al modello, semplificando molto, di ponderare le relazioni fra gli elementi di una sequenza quando costruisce le rappresentazioni interne.
Prendiamo:
“Laura non ha comprato il computer perché era troppo costoso.”
Per interpretare correttamente “era troppo costoso” bisogna collegare parole che non sono necessariamente adiacenti.
L’attention consente al modello di costruire relazioni contestuali fra elementi della sequenza in modo molto efficace.
I Transformer hanno successivamente dato origine a famiglie di modelli utilizzate per classificazione, traduzione, question answering, embeddings e generazione.
NLP e LLM non sono la stessa cosa
Un Large Language Model è un modello linguistico di grandi dimensioni, normalmente basato su deep learning e architetture Transformer o derivate.
Natural Language Processing è invece il campo più ampio.
La distinzione è importante anche nella pratica.
La documentazione Microsoft dedicata alla scelta delle tecnologie NLP separa esplicitamente il dominio NLP dai language model: tokenizzazione, stemming, NER, sentiment analysis e classificazione possono essere risolti anche attraverso strumenti specializzati che non richiedono un grande modello generativo.
Hugging Face utilizza una distinzione analoga nel proprio corso su NLP e LLM: NLP è il campo generale, mentre gli LLM sono una potente famiglia di modelli utilizzabile per molti task linguistici.
Quindi:
un LLM può fare NLP, ma NLP non significa automaticamente LLM.
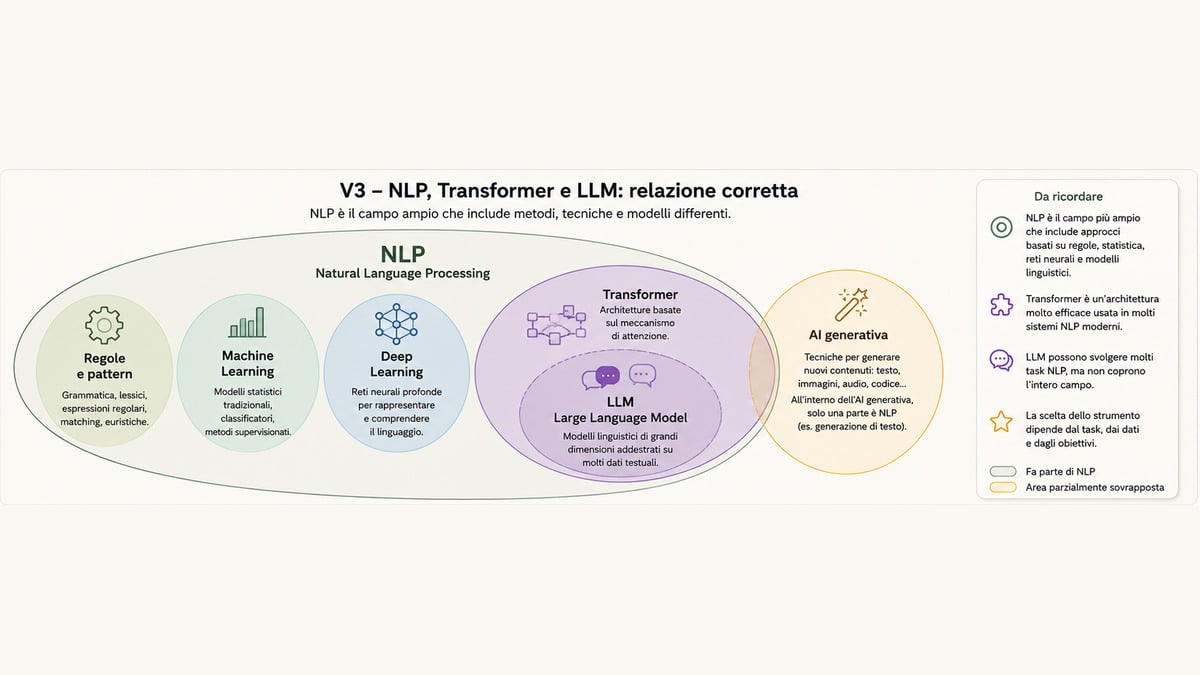
Questo evita anche un errore progettuale abbastanza comune: usare un modello generativo enorme per un problema che un classificatore o una pipeline specializzata risolverebbero con meno costo, minore latenza e output più prevedibili.
NLP e AI generativa
L’AI generativa riguarda sistemi progettati per produrre nuovi contenuti: testo, immagini, audio, video, codice e altre modalità.
Quando il contenuto generato è linguaggio, esiste naturalmente una grande sovrapposizione con l’NLP.
Ma non tutta l’AI generativa riguarda il linguaggio e non tutto l’NLP riguarda la generazione.
Un sistema che classifica mille email senza produrre una sola frase è NLP.
Un modello che genera un’immagine da una descrizione appartiene all’AI generativa, ma il prodotto finale non è un task NLP testuale.
La distinzione serve soprattutto per scegliere strumenti e metriche corrette.
Esempi e applicazioni del Natural Language Processing
Il modo migliore per capire il Natural Language Processing non è elencare decine di settori, ma osservare che cosa entra nel sistema, quale task viene applicato e quale risultato ne esce.
Motori di ricerca e ricerca interna
Input:
“scaricare fatture dello scorso mese”
Un sistema può rappresentare semanticamente la query, analizzare l’intento e recuperare documenti o funzioni pertinenti anche se non contengono esattamente quelle parole.
Qui NLP, information retrieval e ricerca semantica possono lavorare insieme.
Assistenza clienti
Una richiesta come:
“Il pacco risulta consegnato ma io non l’ho ricevuto.”
può essere classificata come problema di consegna e associata automaticamente all’ordine dell’utente.
Il sistema potrebbe quindi:
testo → intent → entità → regola aziendale → risposta o escalation
La generazione della risposta è soltanto l’ultimo pezzo.
Questo spiega perché un buon chatbot non coincide semplicemente con “mettere un LLM davanti agli utenti”.
Analisi di recensioni e feedback
Immagina migliaia di recensioni di un ecommerce.
Possiamo voler ricavare:
- sentiment generale;
- prodotto citato;
- caratteristica discussa;
- problema ricorrente;
- argomento della recensione.
L’obiettivo non deve per forza essere produrre nuovo testo.
Spesso il valore vero consiste nel trasformare linguaggio non strutturato in segnali utilizzabili da analytics e processi aziendali.
Documenti ed estrazione delle informazioni
Contratti, email, ticket e report possono contenere dati importanti mescolati a molto testo.
Un sistema NLP può estrarre:
- persone;
- organizzazioni;
- date;
- importi;
- prodotti;
- clausole o categorie specifiche.
In un sistema reale l’estrazione può inoltre essere collegata a database, workflow di revisione e controlli umani.
Traduzione automatica
La traduzione è uno dei problemi storici dell’elaborazione del linguaggio naturale e rimane uno dei più complessi.
Non basta tradurre ogni parola individualmente.
Bisogna gestire:
- ordine della frase;
- significato;
- contesto;
- espressioni idiomatiche;
- genere e numero;
- terminologia del dominio;
- tono.
È un esempio perfetto del motivo per cui il linguaggio non può essere trattato come una semplice sostituzione da dizionario.
Generazione e riassunto
Con i modelli generativi possiamo trasformare documenti lunghi in sintesi, riscrivere testi o produrre risposte a partire da istruzioni.
Il vantaggio è la flessibilità.
Il limite è altrettanto importante: un output linguisticamente plausibile non garantisce che l’informazione sia corretta.
Per applicazioni ad alto impatto occorre quindi separare qualità stilistica, factuality e provenienza dell’informazione.
Natural Language Processing in italiano: perché è più difficile
Un modello che funziona bene sull’inglese non deve necessariamente offrire la stessa qualità in italiano.
La lingua, il dataset e il dominio contano.
L’italiano presenta morfologia ricca, accordi di genere e numero, verbi fortemente flessi, pronomi clitici e una struttura sintattica sufficientemente flessibile da creare combinazioni molto diverse per esprimere concetti simili.
Prendiamo:
“Gliel’avevo già detto.”
Per una persona madrelingua è una frase normalissima.
Per un sistema bisogna gestire correttamente la struttura di “gliel’”, la forma verbale composta e il riferimento implicito degli elementi della frase.
Un altro problema è il dominio.
Un modello addestrato principalmente su articoli giornalistici potrebbe comportarsi diversamente su:
- cartelle cliniche;
- contratti;
- linguaggio social;
- ticket tecnici;
- ecommerce;
- documentazione industriale.
L’italiano non è semplicemente “una lingua supportata”
La domanda utile non è soltanto:
Il modello supporta l’italiano?
Bisogna chiedere:
Quanto funziona bene sul tipo di italiano che devo elaborare?
Italiano giornalistico, conversazioni online, recensioni, documenti legali e trascrizioni vocali possono avere distribuzioni linguistiche molto diverse.
Il supporto dichiarato è quindi il punto di partenza, non la prova definitiva di qualità.
Pipeline NLP specifiche per l’italiano
Per attività linguistiche tradizionali esistono strumenti che mantengono pipeline dedicate alla nostra lingua.
spaCy pubblica modelli specifici per l’italiano, con componenti che possono includere tokenizzazione, analisi morfologica, lemmatizzazione, parsing ed entity recognition.
Questo non significa che siano automaticamente la soluzione migliore per qualsiasi progetto.
Significa che, per un task specifico, vale la pena confrontare modelli dedicati, Transformer multilingue e LLM sul proprio dataset invece di scegliere in base alla popolarità del tool.
Come valutare un sistema NLP in italiano
Il test più utile consiste nell’utilizzare esempi rappresentativi del problema reale.
Se devi classificare ticket italiani, crea un set di ticket che rifletta realmente:
- categorie;
- abbreviazioni;
- errori;
- lessico tecnico;
- richieste ambigue;
- casi rari.
Poi misura l’errore.
Un benchmark generico può dirti che un modello è promettente. Solo i dati del tuo caso d’uso possono dirti se è sufficientemente affidabile per quel caso d’uso.
Quale tecnologia NLP scegliere
Non esiste un “miglior strumento NLP” valido per tutto.
La scelta dipende soprattutto dal task, dal tipo di output richiesto e dai vincoli del sistema.
| Esigenza | Approccio da valutare | Perché |
|---|---|---|
| Pattern molto definiti | regole / regex | semplice, controllabile e veloce |
| Lemmatizzazione, parsing, NER | pipeline NLP specializzata | componenti linguistiche dedicate |
| Sentiment o classificazione | modello specializzato o servizio NLP | output strutturato e ripetibile |
| Similarità semantica | embedding + retrieval | ricerca per significato |
| Task contestuali complessi | Transformer fine-tuned | rappresentazioni contestuali potenti |
| Generazione open-ended | language model / LLM | flessibilità nell’output |
| Risposte su documenti propri | retrieval + modello, se necessario | grounding su informazioni selezionate |
Quando scegliere spaCy
spaCy ha senso quando serve una pipeline NLP controllabile in Python per attività come tokenizzazione, lemmatizzazione, parsing, Named Entity Recognition o classificazione.
È particolarmente interessante quando vuoi conoscere con chiarezza quali componenti compongono la pipeline e gestire direttamente il processo.
Non è però necessario utilizzare ogni componente disponibile.
Un progetto dovrebbe caricare ciò che serve al task reale.
Quando scegliere un Transformer specializzato
Un Transformer fine-tuned può essere un’ottima scelta quando il problema richiede una comprensione contestuale superiore rispetto a una pipeline più tradizionale, ma vuoi comunque mantenere un output ben definito.
Esempio:
input → testo del ticket
output → una delle dieci categorie previste.
Non serve necessariamente un chatbot.
Il modello deve classificare bene.
Framework come Hugging Face Transformers rendono disponibili modelli e workflow per numerosi task NLP e permettono di lavorare con checkpoint pre-addestrati o fine-tuned.
Quando usare un’API NLP gestita
Un servizio gestito può avere senso quando vuoi evitare di gestire direttamente infrastruttura, deployment e aggiornamento del modello.
Per esempio, la Cloud Natural Language API di Google espone funzionalità come analisi del sentiment, entità, sintassi e classificazione del testo.
Il vantaggio è la semplicità operativa.
Il compromesso riguarda controllo, costo, privacy dei dati, dipendenza dal provider e disponibilità delle funzionalità necessarie.
Quando serve davvero un LLM
Un LLM diventa particolarmente interessante quando il task non si lascia ridurre facilmente a un piccolo set di output.
Per esempio:
- rispondere a domande aperte;
- riscrivere;
- sintetizzare;
- estrarre informazioni con schema variabile;
- interpretare istruzioni articolate;
- generare contenuto.
Ma usare un LLM comporta anche nuovi problemi:
- output non completamente deterministico;
- costo per inferenza;
- latenza;
- necessità di controllo;
- rischio di informazioni inventate;
- gestione del contesto;
- privacy e data governance.
La domanda corretta non è quindi:
“Posso usare un LLM?”
Quasi sempre la risposta tecnica sarà sì.
La domanda migliore è:
“Un LLM migliora materialmente questo task rispetto a una soluzione più semplice?”
Se devi rilevare sempre le stesse cinque categorie e il classificatore raggiunge l’affidabilità richiesta, aggiungere generazione open-ended può complicare inutilmente il sistema.
Limiti del NLP: ambiguità, bias, privacy e affidabilità
Il linguaggio non diventa facile soltanto perché il modello è più grande.
Molti problemi fondamentali rimangono.
Ambiguità e contesto
Prendiamo:
“Ho visto l’uomo con il telescopio.”
Chi aveva il telescopio?
Chi parla oppure l’uomo?
Una persona può cercare di dedurlo dal contesto. Senza informazioni aggiuntive, però, la frase resta linguisticamente ambigua.
Un modello può produrre l’interpretazione più probabile senza che questa sia necessariamente quella corretta.
Ironia e linguaggio implicito
“Fantastico, un’altra riunione di tre ore.”
La parola “fantastico” è positiva, ma la frase potrebbe comunicare esattamente il contrario.
Un sistema addestrato su esempi poco rappresentativi può fallire proprio su questi casi.
Domain shift
Un modello può funzionare molto bene durante i test e degradare quando cambia il tipo di testo.
È il domain shift.
Un classificatore addestrato su recensioni di ristoranti non dovrebbe essere considerato automaticamente affidabile su referti medici o ticket di un servizio finanziario.
La lingua è la stessa; la distribuzione dei dati no.
Bias
I modelli apprendono dai dati utilizzati per costruirli e questi dati possono contenere squilibri, stereotipi e associazioni indesiderate.
Il problema non si risolve semplicemente aggiungendo un disclaimer.
Bisogna valutare dataset, gruppi coinvolti, tipi di errore e conseguenze nel contesto reale.
Abbiamo approfondito questi aspetti nella guida dedicata a bias e intelligenza artificiale.
Privacy
Il testo può contenere informazioni personali o riservate:
- nomi;
- email;
- indirizzi;
- dati sanitari;
- informazioni finanziarie;
- documenti aziendali.
Prima di inviare questi dati a un servizio esterno bisogna capire dove vengono elaborati, come vengono conservati, quali controlli offre il provider e quali obblighi si applicano al progetto.
La capacità tecnica di elaborare un documento non equivale all’autorizzazione a farlo.
Le allucinazioni riguardano soprattutto i sistemi generativi
Un classificatore tradizionale può sbagliare categoria.
Un sistema NER può non riconoscere un’entità.
Un modello generativo può invece produrre una frase nuova che appare credibile pur contenendo informazioni non supportate.
È il problema normalmente descritto come AI hallucination.
È però poco preciso attribuire le “allucinazioni” all’intero campo NLP.
Sono particolarmente rilevanti nei sistemi generativi e nei language model che producono liberamente nuovi output.
Questa distinzione conta perché ogni tipo di errore richiede controlli diversi.
Domande frequenti sul Natural Language Processing
NLP e programmazione neurolinguistica sono la stessa cosa?
No.
In questo contesto NLP significa Natural Language Processing, cioè elaborazione del linguaggio naturale.
L’acronimo NLP viene utilizzato anche per indicare la programmazione neurolinguistica, ma si tratta di un ambito completamente diverso.
Quando si parla di intelligenza artificiale, machine learning, chatbot, sentiment analysis, Transformer o language model, NLP indica normalmente Natural Language Processing.
Il Natural Language Processing funziona anche con la voce?
Sì, ma è utile distinguere le fasi.
Un segnale audio può prima essere trasformato in testo attraverso un sistema di speech recognition. A quel punto un sistema NLP può analizzare la trascrizione per identificare intento, entità, sentiment o risposta.
Un assistente vocale come Alexa rende questa distinzione più concreta: riconoscere ciò che una persona ha pronunciato è un problema diverso dal comprendere l’intento della richiesta e decidere quale informazione, servizio o azione utilizzare. Nei sistemi moderni queste fasi possono essere integrate profondamente, ma restano utili per capire che riconoscimento vocale e comprensione del linguaggio non sono sinonimi.
Nei sistemi moderni alcune architetture possono integrare direttamente più modalità, ma speech processing e NLP non sono concetti perfettamente equivalenti.
Gli LLM hanno sostituito il NLP tradizionale?
No.
Gli LLM hanno ampliato enormemente ciò che è possibile fare con il linguaggio, soprattutto nei task generativi e open-ended.
Questo non rende inutili classificatori, regole, NER specializzata, retrieval, parser o modelli più piccoli.
In produzione, anzi, un sistema efficace può combinare più tecniche:
regole + retrieval + modello specializzato + LLM
La scelta dipende dal problema.
Che cosa significa NLG?
NLG significa Natural Language Generation.
È l’area dedicata alla produzione automatica di linguaggio naturale.
Può trasformare dati strutturati in una frase, generare una descrizione, costruire una risposta o produrre un testo più articolato.
Qual è la differenza tra NLP e NLU?
Natural Language Processing è il campo più ampio.
Natural Language Understanding si concentra soprattutto sulle tecniche utilizzate per ricavare significato o informazioni dall’input, per esempio intent ed entità.
NLU viene quindi normalmente considerato un sottoinsieme o componente dell’NLP, non un’alternativa ad esso.
Qual è un esempio semplice di Natural Language Processing?
Un filtro antispam è un buon esempio.
Riceve il testo di un’email, lo rappresenta in una forma elaborabile da un modello e restituisce una categoria:
spam / non spam.
Non deve conversare, generare testi o utilizzare un enorme language model per essere un sistema NLP.
Conclusione
Il Natural Language Processing non è una singola tecnologia e non coincide con gli LLM.
È il campo che cerca di rendere il linguaggio umano utilizzabile da sistemi informatici attraverso tecniche che vanno dalle regole e dai modelli statistici fino al machine learning, alle reti neurali, ai Transformer e ai grandi modelli linguistici.
La domanda più utile, quindi, non è quale sia “il miglior NLP”.
È molto più concreta:
che cosa deve fare il sistema con il linguaggio?
Se devi estrarre entità da documenti, potresti avere bisogno di una pipeline NER.
Se devi classificare richieste, potrebbe bastare un modello specializzato.
Se devi recuperare informazioni per significato, entrano in gioco embedding e retrieval.
Se devi affrontare istruzioni aperte e produrre testo, un LLM può diventare la scelta giusta.
Capire questa differenza permette di evitare due estremi: trattare l’NLP come una vecchia tecnologia superata oppure utilizzare un grande modello generativo per qualsiasi problema linguistico.
Il punto non è scegliere la tecnologia più complessa. È scegliere il livello di elaborazione del linguaggio necessario per risolvere bene il problema reale.